
上下文壓縮成本:幾輪請求才能回本
目錄
在六次快取已預熱、起始上下文接近 14k 個權杖的測試中,Claude Sonnet 5.5 的上下文壓縮成本,都在後續 4-6 次請求後回本。這個實測範圍只適用於受測工作負載。制定策略時,必須計入摘要生成成本、實際的快取計費方式,以及剩餘工作是否足以收回這次壓縮的成本。
TL;DR
- 上下文視窗空間不足時,縮減使用中的上下文是容量上的必要措施;本次測試並未測量模型的最大視窗。
- 在高價級距生成摘要後,再查詢一次大致損益兩平,成本為 $0.0560882,保留歷史則為 $0.0560655;在這個例子中,查詢兩次就明確收回摘要成本。
- 事後套用公式估計需要 4-5 輪回本,實測則為 4-6 輪;這不是事前預測測試。
- 一項包含六個問題的封存資料任務,壓縮後成本為 $0.0156941,不壓縮則為 $0.0059911,兩者正確率都是 6/6。
你想用上下文壓縮解決什麼問題?
先確定縮減上下文的原因,再設定權杖門檻。遇到上下文硬上限、即將進入更高計價級距,或只是一般的長對話,應採取的判斷各不相同。
上下文壓縮會把較早的對話內容換成較短的表示,供後續請求使用。我們的實驗採用用戶端文字摘要:先透過一般模型呼叫生成摘要,再由應用程式用摘要文字取代先前的歷史。原生支援簽章或加密的壓縮功能,其請求與用量規格並不相同。
| 情境 | 主要目標 | 何時應採取行動? | 本文提供的依據 |
|---|---|---|---|
| 接近模型的上下文視窗上限 | 讓任務能繼續執行 | 必須為下一次輸入、工具結果與輸出預留足夠空間 | 模型公開規格與工程策略;未做最大視窗實驗 |
| 接近更高的計價級距 | 降低整個工作負載的成本 | 預期節省的費用超過摘要與後續執行成本 | 小規模、未使用快取的計價級距實驗 |
| 視窗與計價級距都還有餘裕 | 改善特定工作負載 | 剩餘有效工作足以收回摘要成本,且不會遺失必要狀態 | 使用快取的狀態保留配對測試,以及短篇封存資料工作負載 |
情境 1:模型的上下文空間快用完了怎麼辦?
在下一次請求可能超出支援視窗之前,先縮減或重整使用中的上下文。到了這個階段,繼續帶上完整對話紀錄可能已經不可行。
Claude Haiku 5.5 的模型規格記載,上下文視窗為 1M 個權杖,最大輸出為 128K。這些是公開規格。我們沒有測試閘道路由實際可接受的最大上下文,以下的計價級距實驗也無法確定這個邊界。
為下一次輸入、工具結果,以及服務要求預留的輸出保留空間。要在摘要請求仍放得進視窗時就觸發壓縮。必要狀態應透過摘要或可檢索的來源紀錄保留下來,並以能否成功繼續任務來評估;因超出視窗而遭拒的請求,不能算是成本更低的成功基準。
情境 2:進入更高計價級距前,該先壓縮嗎?
依實際價格計算,若預期剩餘工作能收回摘要成本,就值得壓縮。跨入另一個計價級距可能讓壓縮變得划算,但摘要請求本身也可能按較高價格計費。
Claude Haiku 5.5 在輸入超過 100,000 個權杖後會調整價格。我們於 2026 年 11 月 4 日查閱的標準輸入/輸出費率,在此門檻以內,每百萬個權杖為 $0.10/$0.50;超過門檻則為 $0.50/$2.50。
我們透過 Synthorai 閘道送出內容各異的虛構圖書館紀錄。輸入 94,350 個權杖的請求花費 $0.009437,輸入 111,999 個權杖的請求則花費 $0.0560095。兩者都生成四個輸出權杖。這筆價差同時包含輸入長度與計價級距的影響。
接著,我們對較長的歷史生成摘要。這次呼叫處理了 112,028 個輸入權杖,未回報任何快取命中,按較高級距計費後為 $0.0560715。兩條執行路徑都正確回答了數量與來源查詢。
| 剩餘查詢次數 | 保留歷史 | 摘要加縮減上下文後的查詢 | 保留歷史,全部改按低費率計算 | 壓縮,全部改按低費率計算 |
|---|---|---|---|---|
| 1 | $0.0560655 | $0.0560882 | $0.0112131 | $0.0112310 |
| 2 | $0.1120760 | $0.0560944 | $0.0224152 | $0.0112372 |
查詢一次時大致損益兩平,兩條路徑只差 $0.0000227。在這個例子中,查詢兩次就明確收回摘要成本。將所有權杖都改按低費率計算,可以區分用量與費率各自造成的影響。
這些未使用快取的請求只代表一項合成任務。歷史已在快取中的情況並不相同。必須確認摘要能讓輸入降到門檻以下多少,以及新增輸入何時又會跨過門檻;詳見長上下文計價級距。
情境 3:壓縮一次後,還要幾輪才能回本?
在六次使用快取的 Claude Sonnet 5.5 測試中,起始輸入約為 13.5k-14.2k 個權杖,實測需要後續 4-6 輪才能回本。這裡的一輪,是指一次後續模型請求。實驗計入摘要生成與之後的快取寫入成本,再從共用的預熱步驟之後,找出十二次後續請求內首次回本的位置。六次測試中,一旦回本,壓縮路徑直到第 12 次請求都沒有比保留歷史更貴。這項觀察不涵蓋之後的快取到期、再次生成摘要或任務改變。
壓縮會浪費已付的快取寫入加價嗎?
做決策時,先前已付的寫入費用屬於沉沒成本。真正要比較的是,未來減少的讀取成本,能否抵銷摘要請求與新寫入的成本。這些實驗使用明確指定的五分鐘快取;隱式快取的定價依供應商而異,未必收取相同的寫入加價。
以下是一組中等成長速度的測試,呈現首次壓縮與工作階段稍後再次生成摘要的差異:
| 壓縮措施 | 省下的後續讀取成本 | 額外的後續寫入成本 | 摘要生成成本 | 到第 12 輪的淨結果 |
|---|---|---|---|---|
| 首次摘要,相較於保留歷史 | $0.0159875 | $0.0010175 | $0.0049761 | 便宜 $0.0099939 |
| 第二次摘要,相較於只做一次摘要 | $0.0037283 | $0.0013925 | $0.0065302 | 貴 $0.0041844 |
第二列還包含其他權杖費用減少的 $0.0000100。摘要費用已包含摘要請求本身的快取計費項目,不要重複計算。權杖用量分類無法指出哪些個別項目從未再次使用。
回本公式與實測結果差多少?
簡單的已預熱快取模型,可以估算還需要幾輪才能回本。令 H 為被取代的歷史權杖數,S 為替代摘要的輸入權杖數,A 為摘要請求的完整成本,r 為每個快取讀取權杖的價格,w 為每個快取寫入權杖的價格。被取代歷史之前、未變動的指令應予保留。
在後續 n 次請求中,保留歷史的成本為 n*r*H,替換成摘要的成本為 A + w*S + (n-1)*r*S。兩者的增量成本差為:
compact cost minus retain cost
= A + (w-r)*S - n*r*(H-S)

payback turns
= ceil((A + (w-r)*S) / (r*(H-S)))
公式假設 H > S、摘要立即符合快取條件、價格不變,而且後續新增內容、輸出與工具工作量相同。它不涵蓋快取到期、額外重寫保留前綴,或為恢復品質而付出的成本。這些條件有變化時,應改用分段成本計算。
我們是在實驗結束後才套用公式。計算輸入取自預熱與摘要呼叫的用量紀錄,而非後續成本,但當時已經知道實驗結果。因此,這是事後核對,不是保留測試集驗證,也不是事前預測驗證。分析以預熱時的總輸入近似 H,以摘要輸出權杖數近似 S;由於固定指令、請求包裝文字與快取資格的影響,這兩個值並不等於實際可替換的歷史與替代摘要輸入。
| 每輪新增量 | 測試次序 | 事後估計 | 實測回本時間 |
|---|---|---|---|
| 約 96 個權杖/輪 | 1 | 5 輪 | 6 輪 |
| 約 96 個權杖/輪 | 2 | 5 輪 | 6 輪 |
| 約 1.4k 個權杖/輪 | 1 | 5 輪 | 5 輪 |
| 約 1.4k 個權杖/輪 | 2 | 4 輪 | 4 輪 |
| 約 5.2k-5.5k 個權杖/輪 | 1 | 5 輪 | 5 輪 |
| 約 5.2k-5.5k 個權杖/輪 | 2 | 4 輪 | 5 輪 |
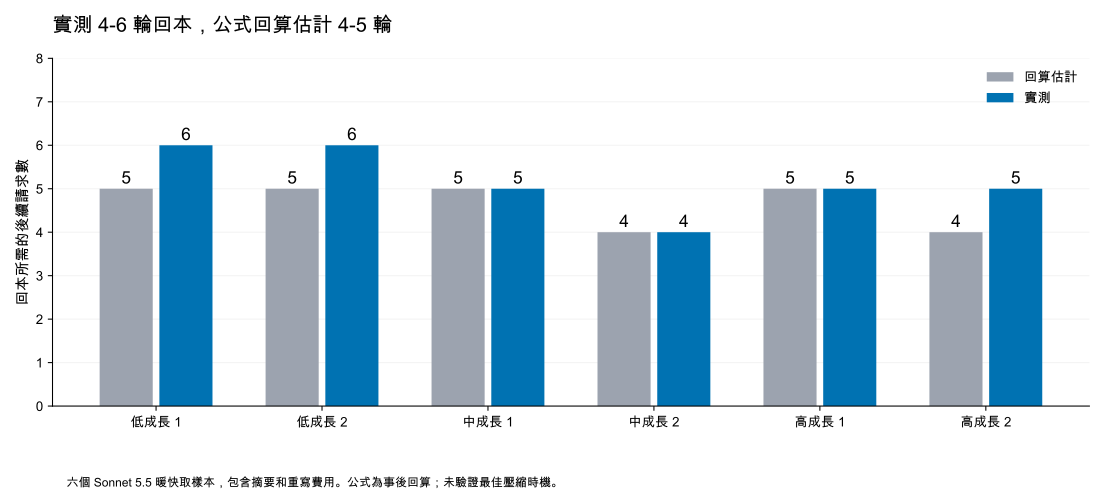
這六次測試的事後核對誤差最多為一輪。要在未來做決策,仍須從先前的摘要估計 A 與 S,並在新任務上驗證;這次比較不提供通用的誤差保證。
DeepSeek 的隱式快取有什麼不同?
沒有獨立的快取寫入費,不代表壓縮後的輸入免費。DeepSeek V4.1 Flash 1017 採用自動快取,輸入依命中與未命中分別計價。定價頁面未列出獨立的寫入費。新的摘要前綴尚未進入快取時,仍按未命中輸入費率收費。
快取文件要求前綴必須符合已持久化儲存的單位。建置需要數秒,命中也僅採盡力而為方式,因此替換後的前綴可能不只一次請求未命中。應追蹤 prompt_cache_hit_tokens 與 prompt_cache_miss_tokens;不要假設只有一次冷啟動呼叫,也不要假設未變動的系統前綴一定命中。
令 p 為每個未命中輸入權杖的價格,m 為未來 n 次請求中,替代前綴仍處於冷快取狀態的請求數。若保留歷史的基準路徑持續命中快取,且後續共同成本可以抵銷:
compact cost minus retain cost
= A + m*(p-r)*S - n*r*(H-S)
只有一次冷快取請求時,應以 p 取代 w,不是代入零。若不知道 m,就計算多種情境,或依實際命中/未命中用量計價,並納入固定前綴與摘要呼叫的未命中成本。
以下是公式試算,不是 DeepSeek 實驗。採用 Flash 官方離峰價格:命中輸入為 $0.003/M、未命中輸入為 $0.15/M,輸出為 $0.60/M。假設摘要為 1k 個權杖、原始歷史已在快取中、替代前綴只有一次冷快取請求,且摘要成本為 A = r*H + output_price*S。忽略請求包裝文字、推理與工具。
| 原始歷史 | 假設的摘要呼叫成本 | 計算所得回本時間 |
|---|---|---|
| 10k 個權杖 | $0.000630 | 29 次請求 |
| 100k 個權杖 | $0.000900 | 4 次請求 |
讀取很便宜時,保留較短且已在快取中的歷史可能更划算;工作持續較久時,壓縮則可能回本。我們並未測量 DeepSeek 的品質與回本時間。尖峰費率或混合費率工作階段需要重新計算。
上下文成長速度如何影響壓縮時機?
成長速度會改變做決策時的歷史長度。若壓縮前經過了 j 輪,每輪增加 g 個權杖,就把 H_j = H_0 + g*j,連同當下的摘要大小與成本代入回本公式。
兩條路徑若在之後增加相同內容,就會產生共同成本。在價格與快取行為不變的前提下,這些項目會互相抵銷。成長越快,越早遇到容量或價格限制,但這本身不能決定幾輪回本。
在我們的成長測試中,必要狀態一直很小,持續增加的是封存資料。兩次十二輪測試都顯示,中等成長速度下,重複壓縮比只做一次摘要更貴;高成長速度下則更便宜。包含延長測試在內,所有策略都正確回答了 96/96 個狀態查詢;這不代表已驗證必要狀態無限成長的情況。
模型建議持續執行的工作隔多久壓縮一次?
對長時間執行的任務,若成長速度、摘要大小、價格與快取行為大致固定,可令 F 為每個壓縮週期的固定費用,包含摘要輸出與替代內容的重寫。與間隔呈線性關係的成本不納入,因為攤到每輪後是常數。摘要模型若從快取讀取歷史,可用 A - r*H + w*S 估計 F;其他計價方式必須另行拆解。若 g 為每輪成長量,k 為兩次摘要之間的輪數,與間隔相關的平均成本為:
average interval-dependent cost = F/k + r*g*(k-1)/2
candidate interval k = sqrt(2*F/(r*g))
candidate history threshold = S + g*k
這要求 F、r 與 g 都為正數、保留的摘要夠小,而且任務品質相當。成長量為零時,就沒有由成長驅動的週期性觸發條件;讀取免費時,這個模型也無法靠節省讀取成本回本。以我們的顯式快取價格與摘要大小計算,低、中、高成長速度的候選間隔分別接近 30、7-8 與 4 輪。應在容量餘裕允許下,測試附近的整數間隔,且至少為一次請求;我們沒有透過完整的間隔測試證明這些值最佳。按未命中輸入計價的快取,必須另行拆解固定成本。
用一筆實際計算來看單位會更清楚。某次中等成長速度的測試紀錄為 A = $0.0049761、H = 13,712、S ≈ 341,以及 g ≈ 1,396 tokens/turn。代入 r = $0.10/M 與 w = $2.50/M 後:
F ≈ 0.0049761 - (0.10/1,000,000)*13,712
    + (2.50/1,000,000)*341
  = $0.0044574 per cycle

k ≈ sqrt(2*0.0044574 / ((0.10/1,000,000)*1,396))
  ≈ 8 requests
這只是根據紀錄值計算候選間隔,並未證明每八次請求壓縮一次是最佳策略。剩餘工作量還要另外檢查:如果估計壓縮後要五次請求才回本,但只剩三次,就算週期計時器顯示該壓縮了,也應略過這次非必要的壓縮。
任務接近完成時,若新增摘要無法在剩餘請求內回本,就略過這次非必要摘要。容量、計價級距與必要資訊保留要求,優先於這個簡化的金額模型。
一項短篇封存資料工作負載,可以說明這道判斷。兩種策略都正確回答了六個數量問題,但保留歷史只花 $0.0059911,包含摘要的路徑則花 $0.0156941。六次查詢不足以收回這次壓縮成本。摘要保留了足夠細節,不需要額外查找。回本所需的剩餘工作長度,取決於實際摘要與工作負載,並不存在通用的四到六輪規則。
如何測量完整成本?
摘要、第一次重寫後的請求,以及每一次後續請求都要計入。只看 prompt 權杖減少量與快取命中率,無法證明省了錢。
Claude Sonnet 5.5 的成本計算採用新輸入 $2/M、五分鐘快取寫入 $2.50/M、快取讀取 $0.10/M,以及輸出 $10/M。快取讀取很便宜,但仍然要付費。替換已在快取中的歷史,可能產生新的寫入;摘要太短,也可能根本不符合快取資格。我們明確設定的內容區塊中斷點,產生了可測得的快取寫入與讀取;部分壓縮後的短前綴,在最初幾次請求中兩者都沒有回報。
這個函式假設冷前綴請求次數已知。將顯式快取的寫入價格,或隱式快取的未命中輸入價格,傳入 cold_input_per_million:
import math


def payback_turns(summary_cost, history_tokens, summary_tokens,
                  read_per_million=0.10, cold_input_per_million=2.50,
                  cold_requests=1):
    if cold_requests < 0 or int(cold_requests) != cold_requests:
        raise ValueError("cold_requests must be a nonnegative integer")
    r = read_per_million / 1_000_000
    p = cold_input_per_million / 1_000_000
    if summary_cost < 0 or p < r:
        raise ValueError("Unsupported cost assumptions")
    if history_tokens <= summary_tokens or r <= 0:
        return None
    upfront = summary_cost + cold_requests * (p - r) * summary_tokens
    saving_per_turn = r * (history_tokens - summary_tokens)
    return max(1, cold_requests, math.ceil(upfront / saving_per_turn))
若要在壓縮前做決策,應從先前的呼叫估計摘要成本。驗證時要核對完整用量紀錄,包含失敗與恢復工作;缺少用量紀錄,不代表該次請求免費。
測量於 2026 年 11 月 4 日透過閘道的 Messages 介面進行,關閉 thinking,且未使用託管工具。一般回覆的輸出上限為 128 個權杖,摘要則為 2,048 個。成本依回傳用量與標準價格重建,再與閘道回報成本核對,並非與供應商發票對帳。一般工作負載測試的是用戶端摘要,不是原生壓縮實作。
正式環境該採用什麼策略?
先處理容量與費率限制,並為輸入、工具結果與輸出保留空間。對 Claude Sonnet 5.5 的顯式快取工作負載,應計入寫入加價與摘要費用,並略過不太可能在任務完成前回本的非必要壓縮。在相同的任務到達序列與結束輪次下,驗證解析候選值附近的整數間隔。
對 DeepSeek V4.1 Flash 1017 的隱式快取,若命中穩定且剩餘工作不多,就保留有用的前綴。把軟性容量觸發門檻設得晚一點可能合理,但沒有獨立寫入費,不代表應該等到硬上限。工作較長時,應估計實際命中/未命中成本,並在重寫後持續觀察後續請求,直到開始命中快取。
價格、快取狀態、模型或必要狀態大小改變時,都要重新計算。保留可檢索的來源,對細節敏感的任務則要逐項驗證變更後的值。使用正確的權杖用量分類,將摘要與後續用量記錄在同一個 agent 工作階段中。
常見問題
上下文壓縮一定能降低 API 成本嗎?
節省的費用必須超過摘要、快取重建與恢復成本。我們的六次查詢封存資料任務,使用摘要花費 $0.0156941,保留歷史則為 $0.0059911,兩者正確率都是 6/6。
應該剛好到計價門檻時就壓縮嗎?
計價門檻是評估完整剩餘工作負載的時機,不是自動生成摘要的指令。在我們的 Claude Haiku 5.5 範例中,摘要本身按超過 100,000 個權杖的級距計費;後續查詢一次大致損益兩平,兩次則明確回本。
可以等到上下文視窗滿了再處理嗎?
必須為摘要請求、下一次輸入/工具結果與輸出保留空間。歷史若已超出上限,摘要請求本身也可能放不進去。我們並未測量最大視窗的失敗邊界。
上下文成長越快,一次摘要就一定越早回本嗎?
兩條路徑共同增加的內容成長越快,兩種策略的成本都會提高,不會自動增加單次摘要省下的費用。重複壓縮能限制後續累積量,但也會增加摘要與重寫成本。在中等成長速度的測試中,十二輪內重複壓縮比只做一次摘要更貴;高成長速度的測試則是重複壓縮較划算。應依成長速度、剩餘工作長度與必須保留的狀態選擇策略。
有隱式快取,就應該等到上下文上限再壓縮嗎?
短任務中,隱式快取可能讓保留便宜且已在快取中的歷史更划算。DeepSeek V4.1 Flash 1017 對尚未進入快取的摘要前綴,仍收取未命中輸入費用,而且持久化僅採盡力而為方式。先估計剩餘收益,再確保距離支援的視窗上限,仍留有工具、輸入與輸出空間。上面的 DeepSeek 數值是試算結果,不是實測門檻。