
LLM 에이전트가 느린 이유: 트레이스로 찾는 3가지 원인
느린 에이전트의 원인 3가지를 각각 재현하고 수정합니다. 순차 모델 호출 시간을 3.7초에서 1.8초로 줄인 사례와 자체 코드에 있는 느린 도구를 살펴봅니다. 한 줄 답변에도 추론을 수행하는 문제를 함께 다루고 원인별 수정 결과를 확인합니다.
추천 모델
실시간 가격| 모델 | 평가 | 가격 |
|---|---|---|
| GPT-6 Luna 한 문장 답변 다섯 개의 소요 시간 중앙값은 기본 추론 수준에서 25.6 s, reasoning_effort를 none으로 설정했을 때 10.2 s였으며, 출력 토큰은 1,150에서 190으로 줄었습니다. | 데모의 메인 에이전트 | $0.1/100만부터 |
| DeepSeek V4.1 Flash 동일한 입력 토큰 127개에 대해 한 문장 확인 요청 세 개를 순차적으로 보냈을 때 소요 시간 중앙값은 3.7 s, 함께 보냈을 때는 1.8 s였습니다. | 데모의 하위 에이전트 | $0.3/100만부터 |
목차
에이전트가 느린 이유는 대개 3가지 중 하나다. 함께 실행해도 되는 모델 호출이 서로 기다리거나, 호출 사이에 실행되는 자체 코드가 느리거나, 모델 호출 하나가 해당 단계에 필요한 것보다 많은 작업을 한다. 트레이스는 모든 호출과 호출 사이의 공백을 시간축에 표시하므로, 몇 초면 원인을 구분할 수 있다. 이 글에서는 간단한 고객 지원 에이전트로 각 문제를 재현하고 수정한 뒤, 수정 전후 실행을 Synthorai 콘솔에서 나란히 비교한다.
TL;DR
- 독립적인 모델 호출 3개를
asyncio.gather로 함께 실행하자 비용은 그대로 유지하면서 시간 중앙값이 3.7 s에서 1.8 s로 줄었다. - 각각 1.1 s가 걸리는 모의 데이터베이스 조회 4개를 함께 실행하자 에이전트 자체 코드에서 걸리는 시간이 4.6 s에서 1.3 s로 줄었다. 이 구간은 모델을 바꿔도 줄어들지 않는다.
- GPT-6 Luna의 한 문장 답변 5개에서 추론을 끄자(
reasoning_effort="none") 시간이 25.6 s에서 10.2 s로, 출력 토큰은 1,150에서 190으로 줄었다.
이 글은 모델 호출을 트레이스로 묶는 요청 헤더 3개를 설명한 LLM 에이전트 트레이싱을 바탕으로 한다. 해당 가이드에 따라 데모를 설정하고(Python 3.10 이상, virtualenv 활성화), github.com/synthorai-io/use-cases의 같은 디렉터리에서 다음 3가지 사례를 실행한다.
cd use-cases/agent-tracing
python incidents.py serial-checks slow-tool reasoning
각 사례는 수정 전과 수정 후에 한 번씩, 총 두 번 실행된다. 실행마다 트레이스 ID와 함께 한 줄을 출력한다.
serial-checks
  before   3.5 s   3 calls     127 in (     0 cached)     60 out  $0.000110   trace-d2bb96ebcf04
  after    1.5 s   3 calls     127 in (     0 cached)     62 out  $0.000112   trace-5f1e76a2de87
모델 응답 시간은 호출마다 달라지므로 2026년 10월 11일에 각 사례를 5번씩 실행했다. 표에는 중앙값을, 괄호 안에는 가장 빠른 실행과 가장 느린 실행을 표시했다. 세 번째 사례는 수정 후 실행 중 하나가 실패해 4번의 중앙값을 사용했다. 위 출력 예시와 스크린샷의 비교 쌍은 각 사례를 추가로 한 번씩 실행한 결과이며, 앞의 5번에는 포함되지 않는다. 시간은 스크립트가 측정한 전체 경과 시간, 즉 시작부터 종료까지의 시간이다.
| 사례 | 트레이스에 나타나는 모습 | 수정 방법 | 수정 전 | 수정 후 |
|---|---|---|---|---|
serial-checks | 막대가 겹치지 않고 계단 모양으로 배치됨 | 독립적인 호출을 함께 실행 | 3.7 s (3.5부터 4.5) | 1.8 s (1.7부터 2.0) |
slow-tool | your app 행이 길게 표시됨 | 자체 코드 수정 | 11.0 s (9.5부터 12.2) | 9.2 s (6.7부터 11.0) |
reasoning | 출력 토큰 수가 실제 답변보다 훨씬 많음 | 추론 강도 낮추기 | 답변 5개에 25.6 s (19.0부터 31.8) | 10.2 s (7.9부터 12.1) |
에이전트 실행이 느리면 어디부터 봐야 하나?
트레이스 상단의 요약부터 본다. 요약은 전체 경과 시간을 게이트웨이에서 보낸 시간과 앱에서 보낸 시간으로 나눈다. 전체 경과 시간은 사용자가 기다린 시간이다. “In the gateway”는 하나 이상의 모델 요청이 열려 있던 시간이다. “In your app”은 나머지 시간, 즉 요청 사이에 자체 코드만 실행되던 구간이다. 코드와 게이트웨이 사이의 네트워크 시간도 여기에 포함된다. 이 글의 실행에서는 호출당 몇 십분의 1초 정도였다.
이 구분에 따라 다음으로 볼 곳이 정해진다.
- 대부분 게이트웨이에서 소요되고 막대가 계단 모양인 경우: 호출이 서로 기다리고 있다. 첫 번째 사례를 참고한다.
- 앱에서 소요된 시간이 큰 비중을 차지하는 경우: 모델이 문제가 아니다. 두 번째 사례를 참고한다.
- 대부분 게이트웨이에서 소요되고 막대 하나가 긴 경우: 호출 하나가 대부분의 시간을 차지한다. 요약에 “slowest”로 표시된다. 세 번째 사례를 참고한다.
변경 효과를 확인하려면 수정 전 트레이스를 열고 Compare를 선택한 뒤 수정 후 트레이스를 고른다. 콘솔은 두 실행을 한 페이지에 표시한다. 모든 지표는 A, B, 변화량으로 나오고, 이름이 같은 호출끼리 짝지어 비교된다. 두 워터폴도 같은 시간축에 표시된다. 이 글의 모든 이미지는 이 비교 화면이다.
함께 실행할 수 있는 호출을 하나씩 실행하면 어떻게 보이나?
워터폴이 계단 모양으로 나타난다. 앞 막대가 끝나는 지점에서 다음 막대가 시작된다. 데모 에이전트는 DeepSeek V4.1 Flash로 고객 메시지의 감정, 정책, 위험을 각각 한 문장으로 점검한다. 어느 점검도 다른 점검의 결과가 필요하지 않지만, 수정 전 코드는 루프에서 하나씩 기다린다.
for span, question in CHECKS.items():        # each call waits for the one before it
    await check(run, span, question)
수정은 한 줄이면 된다.
await asyncio.gather(*(check(run, span, q) for span, q in CHECKS.items()))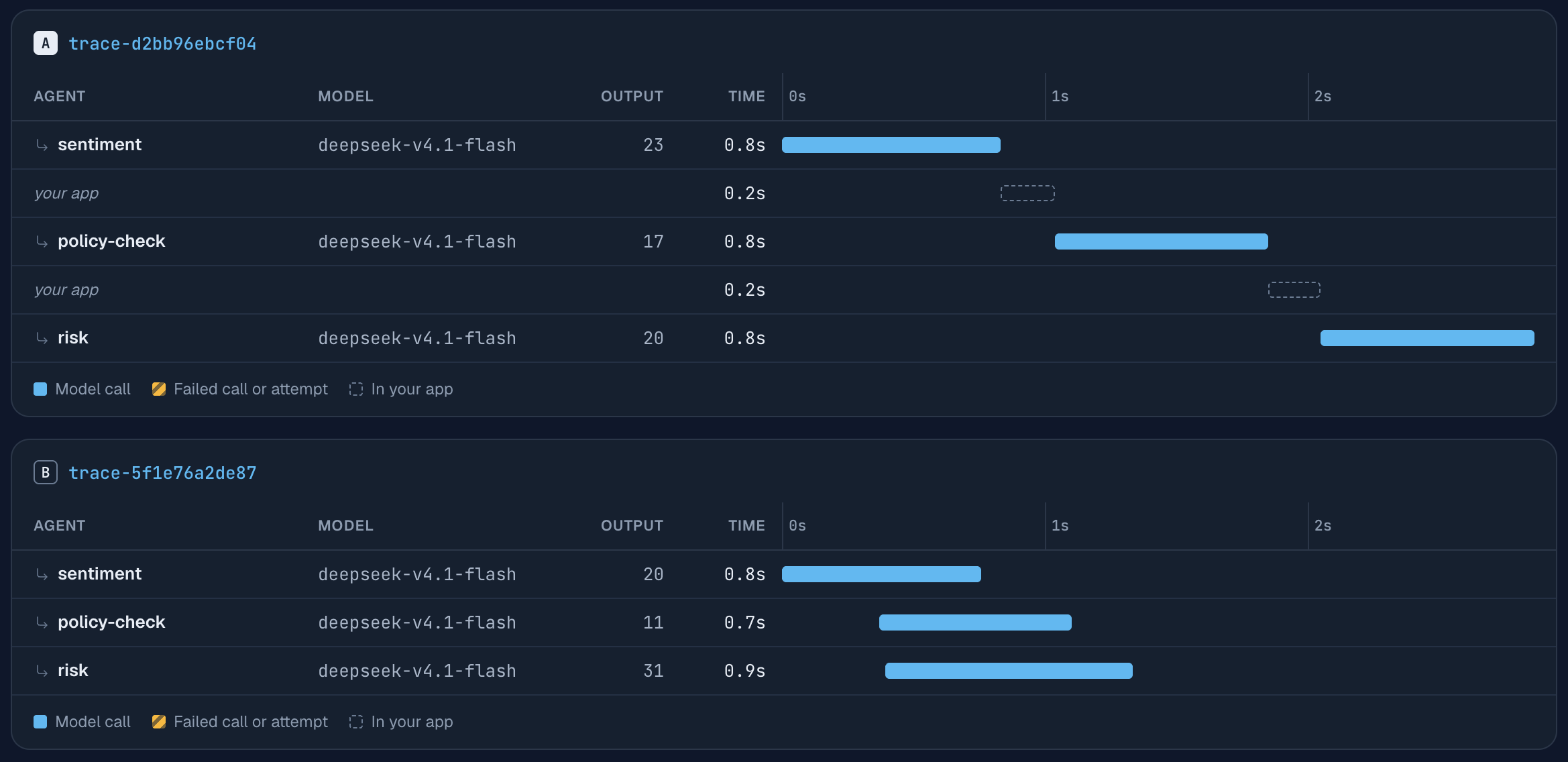
트레이스 A의 전체 경과 시간은 2.9 s다. 각각 0.8 s가 걸리는 호출 3개가 순서대로 실행되고, 호출 사이에는 0.2 s의 공백이 있다. 트레이스 B에서는 막대가 겹치며 전체 경과 시간이 1.3 s다. 같은 콘솔 페이지에서 이미지에 나온 부분 위에 있는 비교 표는 전체 경과 시간이 2.9 s에서 1.3 s로 53.4% 감소했다고 표시한다. 감소율은 반올림 전 시간으로 계산한 값이다. 스크립트는 같은 비교 쌍을 3.5 s와 1.5 s로 측정했다. 각 호출의 연결 설정과 네트워크 시간까지 포함하기 때문이다.
두 실행의 입력은 동일한 127 토큰이다. 비용은 출력에 따라 달라지며, 출력 길이는 실행마다 조금씩 변한다. 이 비교 쌍의 비용은 $0.000110과 $0.000112였다. 5번 실행한 중앙값은 순차 버전이 $0.000105, 병렬 버전이 $0.000109였다. 병렬 호출도 같은 토큰을 보내고 받으므로 병렬화 자체로 비용이 늘지는 않는다.
자체 에이전트에서는 연속된 막대 쌍마다 두 번째 호출이 첫 번째 호출의 출력을 사용했는지 확인한다. 사용하지 않았다면 두 호출은 겹쳐 실행할 수 있다. 계획을 세우고 그 계획에 따른 단계를 실행하는 경우처럼 앞 호출의 결과를 사용하는 호출은 순서를 유지해야 한다.
느린 구간이 자체 코드인지 어떻게 알 수 있나?
your app 행이 길게 나타난다. 이 사례의 수정 전 버전은 4개 테이블에서 고객을 조회한 뒤 질문에 답한다. 쿼리는 하나씩 실행한다. 각 쿼리는 데이터베이스 호출을 대신하는 1.1 s의 sleep이다.
rows = [await lookup(t) for t in tables] # four queries, one at a time쿼리 4개를 함께 실행하는 수정도 한 줄이다.
rows = await asyncio.gather(*(lookup(t) for t in tables))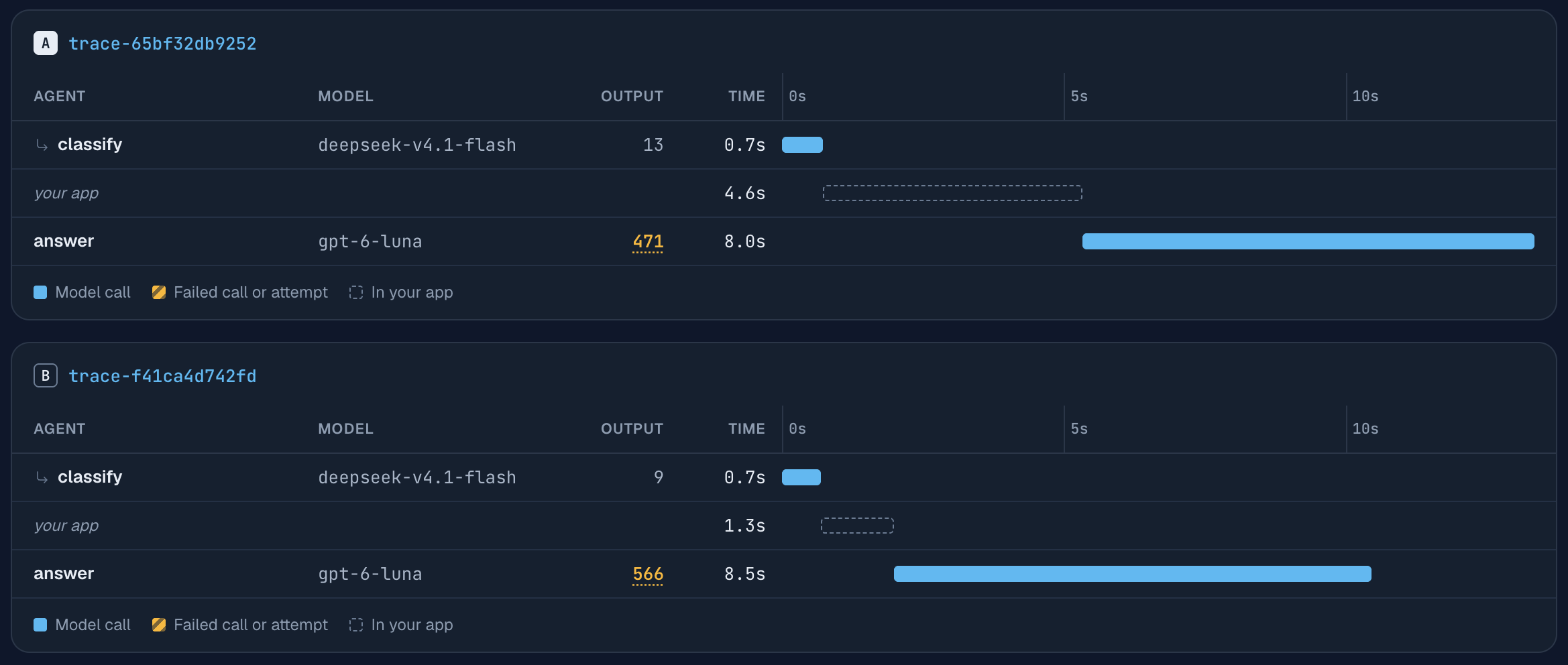
수정한 행의 시간은 4.6 s에서 1.3 s로 줄었다. 비교 표의 “In your app” 감소율은 71.8%이며, 이 역시 반올림 전 시간으로 계산한 값이다. 이 구간은 모델이나 프롬프트를 바꿔도 줄일 수 없다. 열려 있는 모델 요청이 없었고, 에이전트는 자체 조회 작업을 기다리고 있었다.
전체 시간은 이렇게 깔끔하게 줄지 않는다. 이 비교 쌍의 전체 경과 시간은 13.3 s에서 10.5 s로 줄었다. 수정한 구간에서 3.3 s를 줄였지만 전체 절감 시간은 2.8 s였다. 차이인 0.5초는 GPT-6 Luna의 answer 호출에서 발생했다. 첫 실행에서는 출력 토큰 471개를 생성하는 데 8.0 s가 걸렸고, 두 번째 실행에서는 566개를 생성하는 데 8.5 s가 걸렸다. 표에 있는 5번의 실행에서도 두 버전의 시간 범위는 겹쳤다. 수정 후에는 6.7부터 11.0 s, 수정 전에는 9.5부터 12.2 s가 걸렸다. 따라서 수정 후 실행 하나가 수정 전 실행 하나보다 느릴 수 있다.
그래서 단일 실행의 전체 시간이 아니라 수정한 행을 비교해야 한다. 비교 화면의 호출별 표는 각 호출을 대응하는 호출과 나란히 놓고 시간, 출력, 비용을 A와 B로 보여준다. 전체 실행 시간이 개선됐다고 판단하려면 각 버전의 트레이스를 여러 개 모아 실행 시간을 비교해야 한다. Logs의 p95 지연 시간, 즉 요청의 95%가 완료되는 시간으로는 이 수정 효과를 볼 수 없다. 이 지표는 개별 요청을 측정하며, 여기서 줄인 시간은 요청 사이에 있었기 때문이다.
게이트웨이는 공백 동안 코드가 무엇을 했는지는 볼 수 없고, 얼마나 걸렸는지만 알 수 있다. 공백이 큰데 이유를 모르겠다면 자체 함수에 OpenTelemetry span을 추가할 시점이다.
모델 호출 하나가 느리다면?
해당 호출이 생성한 토큰 수를 확인한다. 출력을 생성하는 데 시간이 걸리기 때문이다. 추론 모델은 답하기 전에 추론하며, 화면에 보이는 답변이 한 문장이더라도 추론은 출력 토큰으로 과금되고 실행 시간에도 포함된다. 이 사례의 수정 전 버전은 GPT-6 Luna에 짧은 정책 질문 5개를 보내면서 “한 문장으로 답하세요”라고 지시하고, 추론 강도는 기본값으로 둔다. 수정 후 버전은 매개변수 하나를 추가한다.
await call(run, "answer", model=PLANNER_MODEL, messages=messages, reasoning_effort="none")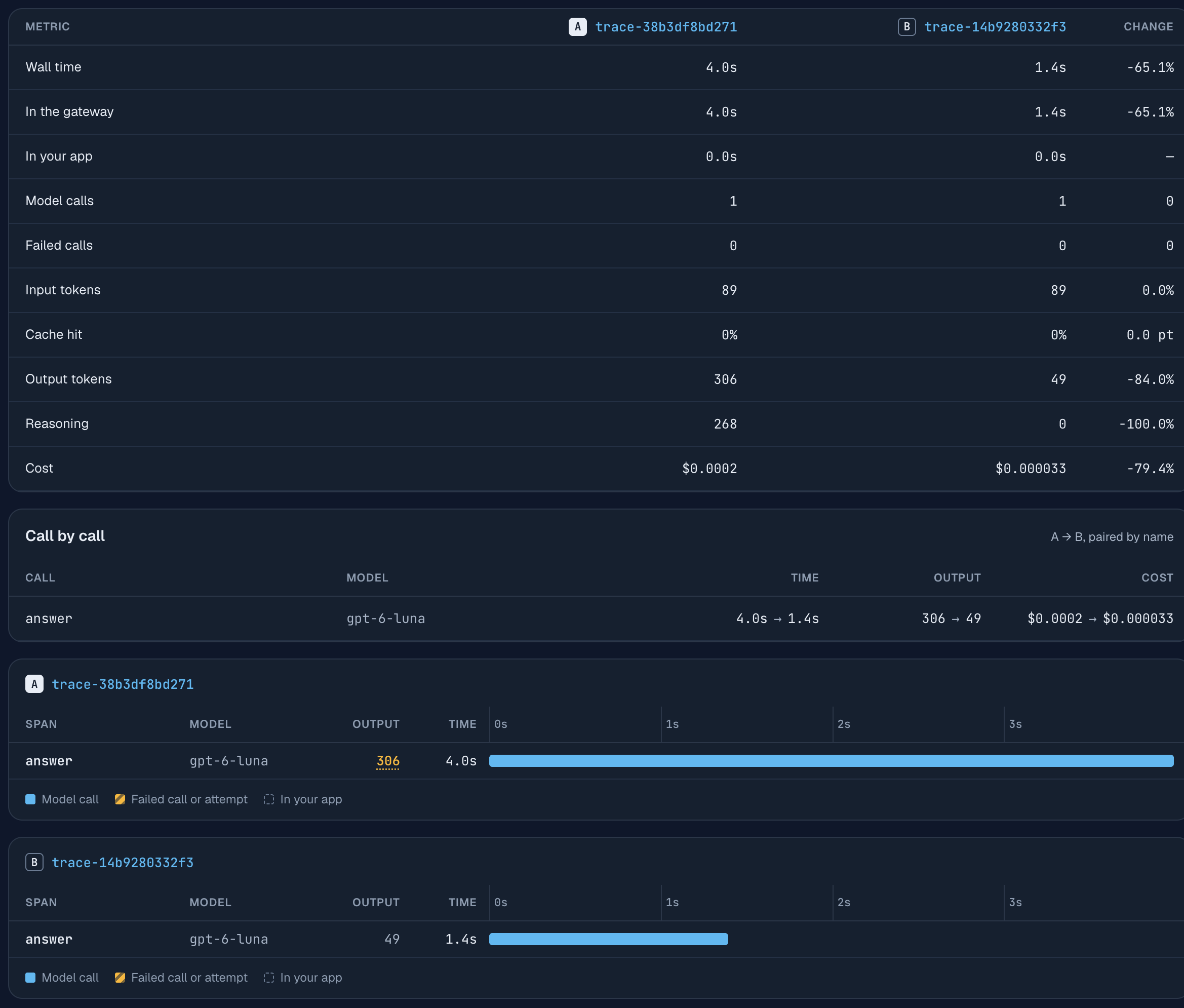
5개 질문 중 첫 번째 질문의 수정 전후 결과다. 답변은 두 경우 모두 한 문장이다. 기본 추론 강도에서는 모델이 답변을 만들기 위해 출력 토큰 306개를 생성했고, 그중 268개가 추론 토큰이었다. 걸린 시간은 4.0 s다. 추론을 끄면 49개를 생성하는 데 1.4 s가 걸렸다. 호출 비용은 $0.00016에서 $0.000033으로 줄었다. 콘솔은 $0.00016을 $0.0002로 반올림해 표시한다.
| 한 문장 답변 5개(5번 실행의 중앙값, 두 번째 행은 4번) | 시간 | 출력 토큰 | 비용 |
|---|---|---|---|
| 기본 추론 강도 | 25.6 s | 1,150 | $0.000614 |
reasoning_effort="none" | 10.2 s | 190 | $0.000134 |
이 문제는 비교 화면 없이도 찾을 수 있다. 워터폴에는 Output 열이 있으며, 출력량이 많고 그 대부분이 추론인 호출은 토큰 수에 밑줄을 표시한다. 위의 306이 그 예다. 호출을 선택하면 패널에서 출력 토큰 아래에 추론 토큰을 별도 행으로 보여준다.
조회, 분류, 도구 결과를 다시 표현하는 단계에는 추론을 끄는 것이 적절하다. 여러 단계의 추론이 필요한 작업에는 적절하지 않으며, 이 데모는 그런 작업을 테스트하지 않는다. GPT-6 Luna 측정 결과에는 설정별 추론 토큰과 답변당 비용이 있고, 추론 강도 가이드에는 모델마다 지원하는 값이 정리돼 있다. 단계별로 설정을 바꾸고, 변경 전후의 답변을 확인한다.
이 글에서 다루지 않는 것은?
두 가지를 다루지 않는다. 첫 번째는 사용자가 느끼는 응답 속도다. Streaming은 호출 시간을 줄이지 않지만, 사용자가 텍스트를 더 일찍 볼 수 있게 한다. 채팅 답변에서는 이쪽이 더 중요할 때가 많다. 호출 패널의 First token 항목으로 확인할 수 있다. 데모는 streaming을 사용하지 않으므로 이 트레이스에서는 해당 항목이 비어 있다.
두 번째는 에이전트 외부의 원인이다. 특정 시간대에 제공업체가 느리거나, rate limit 때문에 클라이언트가 기다렸다가 재시도하는 경우다. 이런 문제는 긴 막대 하나 또는 실패한 호출 뒤의 재시도로 나타나며, 코드 구조를 바꿔서는 해결되지 않는다.
FAQ
LLM 에이전트에서 가장 느린 단계를 어떻게 찾나?
실행의 트레이스를 열고 요약을 확인한다. 가장 느린 호출의 이름과 함께 전체 경과 시간을 게이트웨이 시간과 앱 시간으로 나눠 보여준다. 아래 워터폴은 모든 호출을 막대로 표시하므로, 가장 긴 막대나 가장 긴 your app 행부터 살펴보면 된다.
LLM 호출을 병렬로 실행하면 순차 실행보다 비용이 더 드나?
아니다. 데모의 점검 3개는 순차 실행 비용 중앙값이 $0.000105, 병렬 실행이 $0.000109였고, 입력은 동일한 127 토큰이었다. 비용 차이는 실행마다 출력 길이가 달라져서 생겼다. 비용은 토큰 수에 따라 정해지며, 병렬 호출도 같은 토큰을 보내고 받는다. 병렬 호출은 한꺼번에 도착하므로 rate limit은 확인해야 한다.
답변이 짧은데 모델 호출이 느린 이유는?
대개 모델이 먼저 추론했기 때문이다. 추론은 답변에 보이지 않는 출력 토큰으로 생성된다. GPT-6 Luna의 한 문장 답변 5개는 기본 추론 강도에서 출력 토큰 중앙값이 1,150이었고, reasoning_effort="none"에서는 190이었다.
수정 후 에이전트가 빨라졌는지 어떻게 측정하나?
전체 시간 하나가 아니라 변경한 구간을 비교한다. 데모에서 조회 4개를 함께 실행하자 자체 코드 시간은 4.6 s에서 1.3 s로 줄었다. 하지만 모델 호출 하나의 시간이 달라져 수정 후 단일 실행의 전체 경과 시간은 6.7 s부터 11.0 s까지 분포했다. 각 버전을 여러 번 실행하고 트레이스 실행 시간을 비교한다.
게이트웨이에서 두 모델 호출 사이에 코드가 무엇을 했는지 볼 수 있나?
your app 행으로 공백의 길이는 볼 수 있지만, 그 안에서 무슨 일이 있었는지는 볼 수 없다. 자체 코드 내부에 span을 추가하려면 OpenTelemetry SDK를 사용하고, SDK의 traceparent 헤더를 전달해 두 화면이 같은 트레이스 ID를 사용하도록 한다.
관련 글
- LLM 에이전트 트레이싱: 이 글에서 사용하는 헤더와 워터폴.
- LLM 에이전트 비용이 높은 이유: 같은 방법으로 비용 분석하기.
- LLM 에이전트 디버깅: 사용자 불만에서 문제가 발생한 호출까지 추적하기.
- 하위 에이전트별 Claude Code 비용: 직접 작성하지 않은 코딩 에이전트에 같은 화면 적용하기.
- Claude에 LLM 로그 질문하기: MCP로 요청 로그에 관한 질문에 답하기.
- 에이전트에 로그 도구 제공하기: 직접 만든 프로그램으로 같은 로그를 읽고 모델 토큰 비용 확인하기.
- GPT-6 Luna와 GPT-5.6 Luna 비교: 추론 강도별 추론 토큰과 답변당 비용.