
LLM 에이전트 디버깅: 트레이스 속 장애 3가지, 하나는 상태 200
라벨을 기준으로 특정 사용자 한 명의 에이전트 실행을 찾은 뒤 트레이스에 기록된 세 가지 실패를 살펴봅니다. 재시도가 발생한 404 오류, HTTP 상태 200이지만 중간에 잘린 응답, 두 번째 턴에서 발생한 400 오류를 각각 확인합니다.
추천 모델
실시간 가격| 모델 | 평가 | 가격 |
|---|---|---|
| GPT-6 Luna 저장된 대화 기록에서 도구 호출이 누락되자, 대화의 두 번째 턴을 0.5 s 만에 400으로 거부했으며 요금은 부과하지 않았다. | 데모의 메인 에이전트 | $0.1/100만부터 |
| DeepSeek V4.1 Flash max_tokens가 40일 때 연속 세 번의 호출이 상태 코드 200과 정확히 40개의 출력 토큰을 반환했지만, 사용 가능한 응답은 없었다. 한도를 높이고 추론을 끄자, 한 번의 호출이 49개의 토큰으로 응답했다. | 데모의 하위 에이전트 | $0.3/100만부터 |
목차
에이전트 버그 제보는 대개 “어제 오후에 어시스턴트가 쓸모없는 답을 줬어요”라는 식으로 들어옵니다. 사용자 한 명과 대략적인 시간만 있고 요청 ID는 없습니다. 해당 실행을 찾으려면 요청에 라벨이 있어야 하고, 원인을 파악하려면 트레이스가 필요합니다. 여러 호출 중 하나만 잘못되는 경우가 많고, 오류로 보이지 않는 장애도 흔하기 때문입니다. 이 글에서는 사용자 제보에서 문제가 생긴 호출까지 찾아가는 과정을 살펴봅니다. 이어서 작은 지원 에이전트로 장애 3가지를 재현하고 Synthorai 콘솔에서 각각 어떻게 보이는지 확인합니다.
TL;DR
- 모든 요청에
_user라벨을 붙이면 Traces 목록에서 검색 한 번으로 특정 사용자의 에이전트 실행을 찾을 수 있습니다. - 재시도할 때 트레이스 ID를 유지하면 실패한 호출과 재시도가 나란히 표시됩니다. 데모의 404 호출은 95 ms가 걸렸고 비용은 $0였습니다.
- 추론 모델에
max_tokens=40을 설정하자 호출 3개가 모두 상태 200과 출력 토큰 40개를 반환했지만 답변은 없었습니다. - 저장한 대화 이력에서 도구 호출이 빠지면 두 번째 턴이 400으로 실패합니다. 비용은 청구되지 않았습니다.
이 글은 여기서 사용하는 요청 헤더를 설명한 LLM 에이전트 트레이싱의 후속 글입니다. 해당 글에 따라 데모를 준비한 뒤(Python 3.10 이상, virtualenv 활성화), github.com/synthorai-io/use-cases의 같은 디렉터리에서 다음 명령을 실행하세요.
cd use-cases/agent-tracing
python run.py --fail                    # a failed call with a retry
python incidents.py cut-off bad-history
이 페이지의 수치는 2026년 10월 11일에 각 사례를 한 번씩 실행한 결과입니다.
| 트레이스에 보이는 현상 | 의미 | 사례 |
|---|---|---|
| 상태 코드가 붙은 빗금 표시 뒤에 비슷한 호출이 있음 | 호출이 실패한 뒤 재시도됨 | run.py --fail |
| 같은 스팬이 여러 번 나타나고 모두 200이며 Output 열 값이 설정한 상한과 같음 | 쓸 수 있는 답변이 나오기 전에 응답이 잘림 | cut-off |
| 세션의 두 번째 턴에서 400, 토큰 0개, $0 | 코드가 구성한 요청이 유효하지 않음 | bad-history |
특정 사용자의 실행은 어떻게 찾나요?
요청과 함께 보낸 라벨로 찾습니다. 모든 요청의 X-Synthorai-Metadata에 _user 키를 넣었다면 필터 하나로 해당 사용자의 요청만 볼 수 있습니다.
labels = {"feature": "support-agent", "release": "v2", "_user": "u_1002"}- Traces를 열고 검색창에
metadata._user = u_1002를 입력한 뒤 Enter를 누릅니다. 제보된 시간이 포함되도록 조회 기간을 설정합니다. - 목록을 확인합니다. 이제 해당 사용자의 세션과 트레이스만 표시되며, 각각의 호출 수, 오류 수, 소요 시간, 비용을 볼 수 있습니다. Calls, Errors, Duration, Cost 열은 정렬할 수 있습니다. 오류가 있거나 주변 트레이스보다 호출 수가 훨씬 많은 항목부터 확인하세요.
- 해당 트레이스를 엽니다. 전체 실행을 볼 수 있고, “Open session”에서는 전후 대화를, “See the calls in Logs”에서는 개별 요청 목록을 볼 수 있습니다.
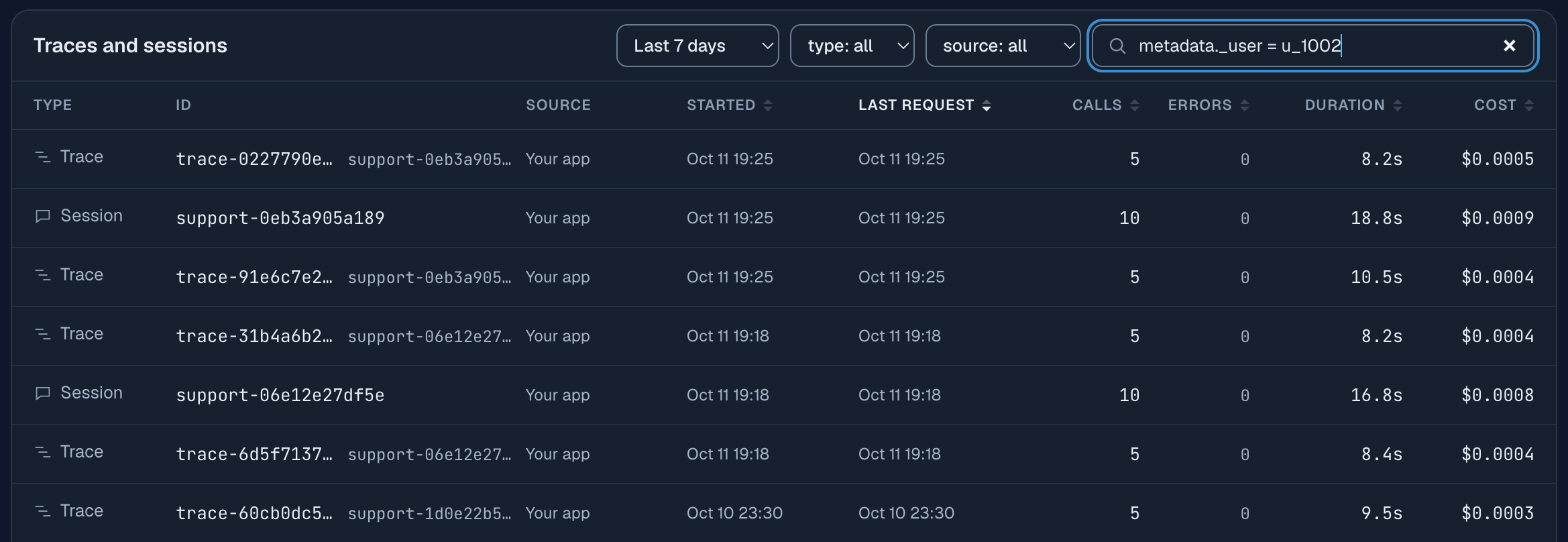
실행 대신 개별 요청을 검색하려면 Logs의 필터에 같은 라벨을 사용하면 됩니다. status(error, success, 4xx, 5xx 또는 상태 코드), latency, cost, model, session, trace도 함께 사용할 수 있습니다.
라벨이 없다면 확보한 정보로 검색을 시작합니다. 자체 로그에 있는 트레이스 ID는 Traces 검색창에 넣고, 응답 헤더에서 얻은 요청 ID는 Logs 필터에 request_id로 넣습니다. 그래서 x-request-id 응답 헤더를 자체 사용자 ID 및 대화 ID와 함께 로그에 남겨야 합니다.
_user에는 이메일 주소나 이름이 아닌 내부 사용자 ID를 사용하세요. 라벨은 요청과 함께 저장됩니다.
실패한 호출과 재시도는 어떻게 보이나요?
상태 코드가 붙은 빗금 표시 옆에 이를 대신한 호출이 나타납니다. 트레이싱 가이드에서는 병렬 검사 3개 중 하나가 존재하지 않는 모델 ID를 요청합니다. 트레이스에서 policy-check는 404가 붙은 95 ms 표시로, policy-check.retry는 그 옆의 일반 막대로 나타납니다. 트레이스 요약에는 “6 model calls, 1 failed”가, 세션 페이지에는 “1 × 404 Not found”가 표시됩니다. 실패한 호출의 비용은 $0였습니다.
이렇게 알아보기 쉬운 이유는 두 가지이며, 둘 다 코드에서 정하는 사항입니다. 재시도에서 트레이스 ID를 유지하므로 실패와 재시도가 한 화면에 담깁니다. 또 재시도에 별도의 스팬 이름을 붙여 각 시도를 구분할 수 있습니다. 재시도가 새 트레이스를 시작하면 서로 관계없는 실행 두 개처럼 보이고, 그중 하나는 실패 이유를 알 수 없는 채로 남습니다.
트레이스에 실패가 있다고 해서 항상 문제가 되는 것은 아닙니다. 이 실행은 복구됐고 고객은 답변을 받았습니다. 트레이스는 실패로 얼마나 손해를 봤는지 보여줍니다. 여기서는 95 ms가 추가됐고 청구 비용은 없었습니다. 재시도만으로 충분한지, 원인을 수정해야 하는지 판단하려면 이 정보가 필요합니다.
모든 호출이 성공했는데 왜 에이전트가 아무 답도 주지 않았나요?
상태 200은 요청 처리가 끝났다는 뜻일 뿐이므로 답변이 없을 수 있습니다. 이 사례에서는 DeepSeek V4.1 Flash를 사용하는 하위 에이전트에게 메시지가 어떤 정책 주제와 관련되는지 묻습니다. max_tokens=40은 이전의 더 단순한 프롬프트에서 쓰던 값이 그대로 남아 있습니다. 데모의 다른 하위 에이전트 호출과 달리, 문제가 있는 이 검사는 추론 설정을 모델 기본값으로 둡니다(코드의 think). 모델이 답변 전에 추론하면서 토큰 40개를 모두 소모합니다. 그 결과 응답은 비어 있고 finish_reason은 length로 반환됩니다. 코드는 빈 응답을 보고 총 3번 시도합니다.
for attempt in range(1, 4):
    resp = await check(run, f"policy-check-{attempt}", prompt, think=variant == "before", max_tokens=limit)
    choice = resp.choices[0]
    if choice.finish_reason != "length" and (choice.message.content or "").strip():
        break                                    # a usable reply; otherwise try again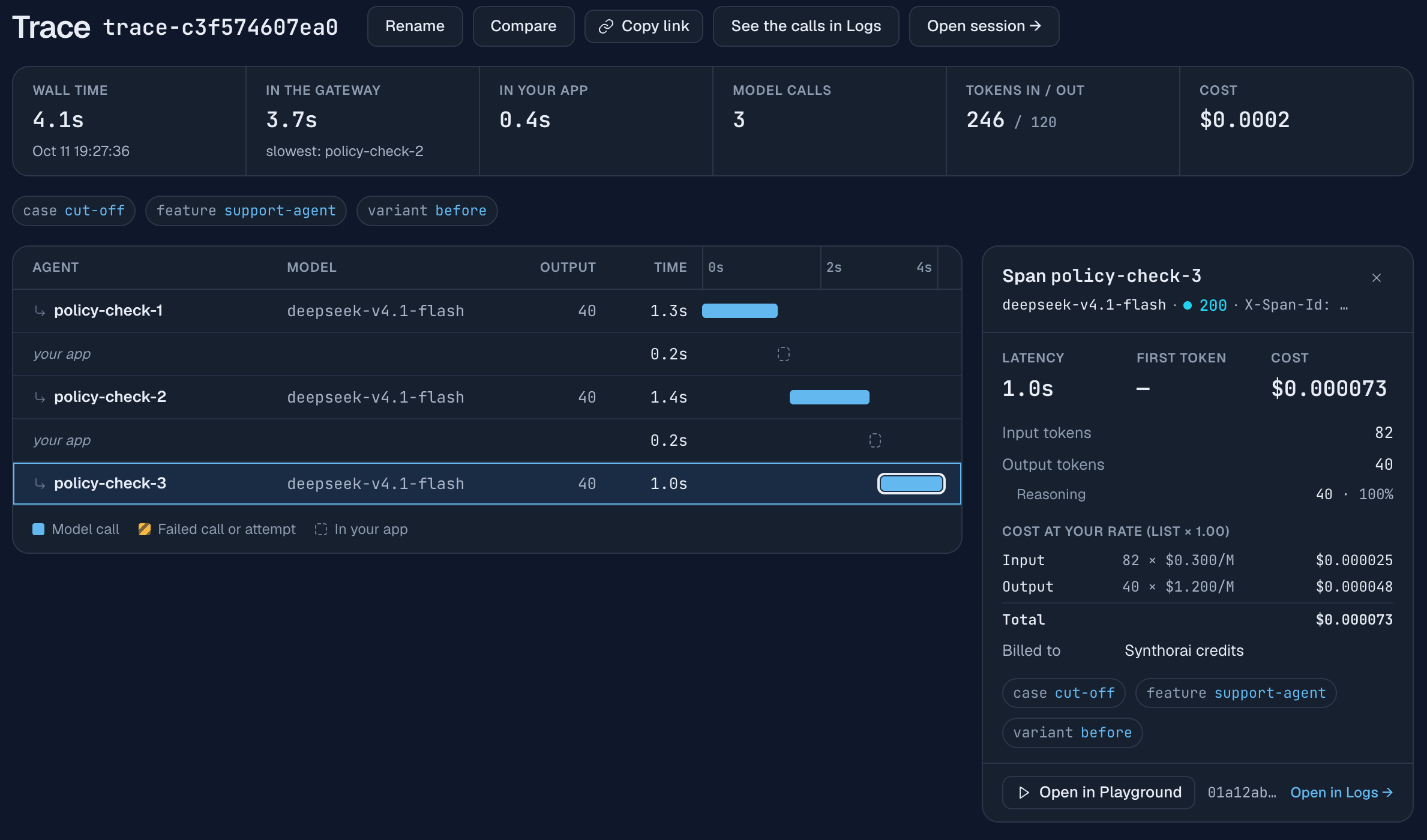
워터폴에는 실패 표시가 전혀 없습니다. 단서는 반복되는 스팬과 Output 열입니다. 값이 40, 40, 40으로 모두 상한과 정확히 같습니다. 호출을 선택하면 오른쪽 패널에서 이를 확인할 수 있습니다. 상태 200, 출력 토큰 40개, 그 아래 줄에 “Reasoning 40 · 100%“가 표시됩니다.
출력 토큰 수가 설정한 상한과 같으면 응답이 잘렸다는 신호입니다. 수정한 버전에서는 상한을 2,000으로 올리고, 이 검사에는 필요 없는 추론을 끕니다. 그러면 호출 한 번으로 출력 토큰 49개의 답변을 받고, 트레이스의 막대도 3개에서 1개로 줄어듭니다. 상한만 올려도 재시도는 사라졌지만, 그 호출은 추론에 출력 토큰 1,876개를 사용했고 22 s가 걸렸습니다.
자신의 에이전트에도 다음을 적용하세요.
- 모든 호출의
finish_reason을 확인하세요.length는 응답이 잘렸다는 뜻입니다. 상태가 200이어도 자체 로그에서는 실패로 처리하세요. - 추론과 답변을 모두 고려해
max_tokens를 정하세요. 추론 모델에서는 둘 다 상한에 포함됩니다. 화면에 보이는 답변만 기준으로 잡으면 답변에 쓸 토큰이 남지 않을 수 있습니다. - 응답이 잘렸다면 같은 상한으로 재시도하지 마세요. 두 번째 시도도 같은 한도에 걸립니다. 상한을 올리거나 추론 강도를 낮추거나 둘 다 조정하세요.
첫 번째 턴은 성공했는데 두 번째 턴은 왜 실패하나요?
대개 턴 사이에 코드가 저장한 내용이 원인입니다. 모델 요청에는 전체 대화가 포함되므로, 이력을 저장하거나 다시 구성하는 코드의 버그는 두 번째 턴부터 드러납니다. 이 사례의 첫 번째 턴은 메모리에 있는 메시지로 실행됩니다. GPT-6 Luna가 도구를 호출하고 결과를 받은 뒤 답변하며, 여기까지는 문제가 없습니다. 이후 코드가 해당 턴을 저장합니다. 이때 어시스턴트 메시지를 텍스트로만 저장해 도구 호출이 사라지고, 도구 결과는 그 옆에 저장됩니다.
# What the app stores for the next turn.
saved = msg.model_dump(exclude_none=True)
if variant == "before":
    saved.pop("tool_calls", None)                # the bug: the assistant message is saved as text only
    saved["content"] = saved.get("content") or ""
history = [saved, *results, {"role": "assistant", "content": answer.choices[0].message.content or ""}]
고객이 다시 메시지를 보내면 저장된 이력으로 두 번째 턴을 구성합니다. 요청에는 도구 결과가 있지만, 그 결과에 대응하는 호출은 이력에 없습니다. 다음 오류와 함께 요청이 거부됩니다(“function call output”은 제공업체가 도구 결과를 부르는 이름입니다).
400 No tool call found for function call output with call_id call_Nqc1zUFvwLLuF5oGMEE9WheQ.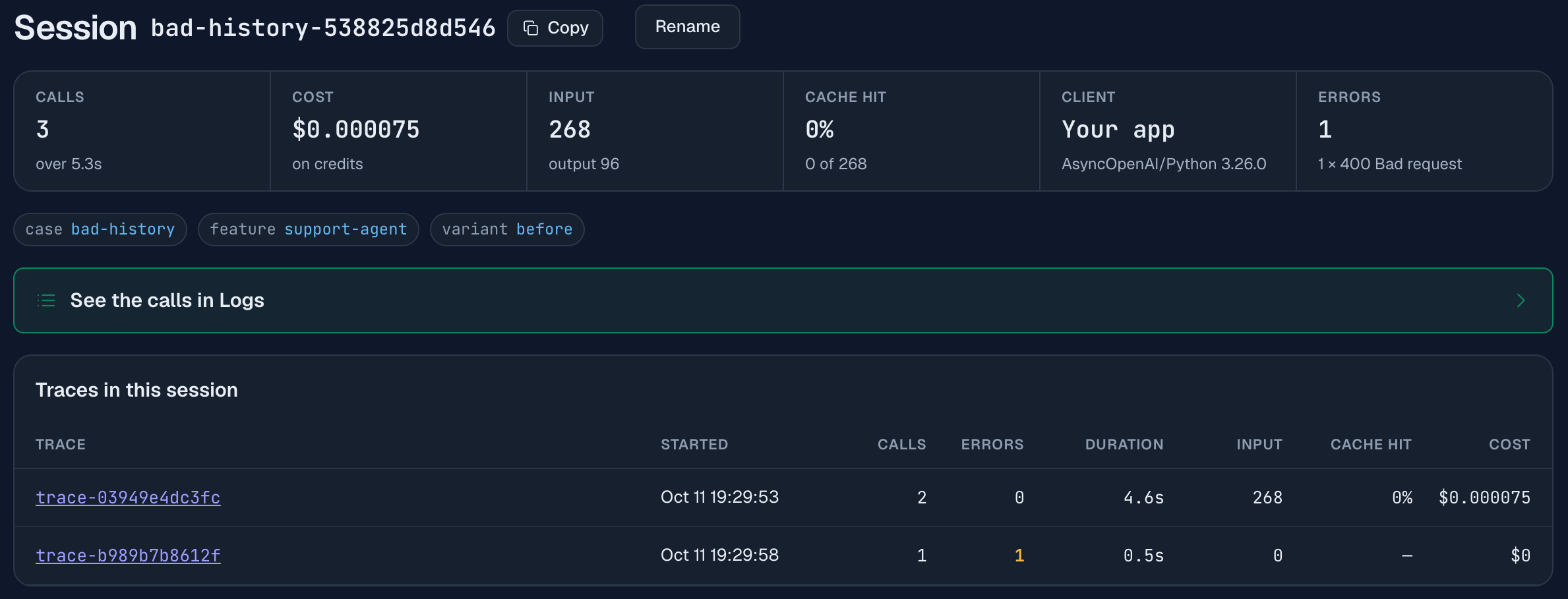
세션 페이지에서 패턴을 확인할 수 있습니다. 트레이스는 2개이고, 첫 번째는 호출 2개에 오류가 없으며 두 번째는 호출 1개에 오류 1개가 있습니다. 오류 카드에는 “1 × 400 Bad request”가 표시됩니다. 실패한 트레이스의 입력 토큰은 0개, 소요 시간은 0.5 s, 비용은 $0입니다. 이 세 값은 모델이 실행되기 전에 유효하지 않은 요청으로 거부됐다는 뜻입니다. 토큰이 사용되거나, 시간이 더 오래 걸리거나, 상태 5xx가 나타나는 모델 또는 제공업체 문제와 구분할 수 있습니다.
400은 요청의 버그이므로 재시도해도 해결되지 않습니다. 오류 메시지에 수정할 부분이 나와 있습니다. 어시스턴트 메시지를 통째로 저장하면 두 번째 턴도 성공합니다.
첫 번째 턴은 정상인데 이후 턴이 거부되는 패턴은 다른 이력 버그에서도 나타납니다. 도구 결과를 호출 ID 없이 저장하거나, 메시지를 잘못된 순서로 저장하거나, 도구 호출과 결과 사이에서 이력을 잘라 결과만 남기는 경우입니다. 비용을 줄이려고 이력을 자른다면 턴과 턴 사이에서 자르고, 한 턴 안에서는 자르지 마세요.
이런 디버깅을 하려면 모든 에이전트가 무엇을 기록해야 하나요?
다음 5가지를 기록하세요.
- 실행별 트레이스 ID와 대화별 세션 ID.
X-Trace-Id와X-Session-Id로 보내고 자체 로그에도 기록합니다. - 단계와 시도를 나타내는 호출별 스팬 이름.
plan-2나policy-check.retry같은 이름을 사용합니다. - 사용자, 기능, 릴리스 라벨.
X-Synthorai-Metadata로 보냅니다. - 모든 호출의
x-request-id응답 헤더. 자체 ID와 함께 기록합니다. - 모든 호출의
finish_reason과 출력 토큰 수.length는 실패로 처리합니다.
모든 호출에 클라이언트 타임아웃과 max_tokens도 설정하고, 둘 다 충분히 여유를 주세요. 둘 다 없으면 모델이 계속 생성하는 동안 호출이 끝나지 않고 코드도 기다립니다. 하지만 눈에 보이는 답변만 기준으로 상한을 잡으면 두 번째 사례의 버그가 발생합니다. 타임아웃을 긴 생성 시간보다 짧게 잡으면 정상적으로 진행 중인 호출을 중단하게 됩니다. 추론 모델에서는 호출 하나에 몇 분이 걸릴 수 있습니다. 데모는 300 s까지 기다리며, 호출에서 별도로 지정하지 않으면 모든 호출의 출력 토큰 상한을 2,000으로 둡니다.
FAQ
운영 환경의 LLM 에이전트는 어떻게 디버깅하나요?
먼저 실행을 찾습니다. 사용자 또는 대화 라벨로 요청 로그를 필터링한 뒤, 일치하는 요청의 트레이스를 엽니다. 트레이스에는 해당 실행의 모든 모델 호출이 순서대로 표시되고 실패한 호출에는 표시가 붙습니다. 코드를 읽기 전에 어느 단계에서 문제가 생겼는지 알 수 있습니다.
LLM이 상태 200으로 빈 응답을 반환하는 이유는 무엇인가요?
대개 모델이 답변을 쓰기 전에 출력 상한에 도달했기 때문입니다. 추론 모델에서 max_tokens는 추론과 답변을 모두 포함합니다. finish_reason을 확인하세요. 값이 length이고 출력 토큰 수가 상한과 같다면 응답이 잘린 것입니다. 데모에서는 연속된 호출 3개가 모두 200과 정확히 출력 토큰 40개를 반환했지만 쓸 수 있는 답변은 없었습니다.
”No tool call found for function call output”은 왜 발생하나요?
대화 이력에 도구 결과는 있지만 대응하는 도구 호출이 없기 때문입니다. 호출한 어시스턴트 메시지를 tool_calls 없이 저장하거나, 호출과 결과 사이에서 이력을 자르면 발생합니다. 어시스턴트 메시지는 통째로 저장하고 이력은 턴 사이에서만 자르세요.
실패한 LLM 호출은 재시도해야 하나요?
상태에 따라 다릅니다. 429(요청 제한)나 5xx(서버 오류)는 재시도하면 성공할 수 있습니다. 400은 요청 자체의 문제라 같은 방식으로 실패합니다. max_tokens 때문에 잘린 응답도 상한을 바꾸지 않으면 다시 잘립니다. 재시도할 때는 트레이스 ID를 유지해 두 시도가 한 트레이스에 나타나게 하세요.
관련 글
- LLM 에이전트 트레이싱: 헤더, 워터폴, 호출 실패 예제.
- LLM 에이전트가 느린 이유: 같은 트레이스에서 지연 시간을 분석하는 방법.
- LLM 에이전트 비용이 많이 드는 이유: 세션에서 비용을 분석하는 방법.
- 하위 에이전트별 Claude Code 비용: 직접 작성하지 않은 코딩 에이전트에도 같은 화면을 활용하는 방법.
- Claude에게 LLM 로그에 대해 질문하기: “이 사용자의 요청 중 실패한 것이 있나요?”에 MCP로 답하기.
- 에이전트에 로그 도구 제공하기: 직접 만든 프로그램으로 같은 로그를 읽는 방법과 모델 토큰 비용.
- 요청 헤더 레퍼런스: ID, 라벨, 각 항목의 제한.