
Gemini 2.5 Flash Image, noto come Nano Banana, è il modello di generazione ed editing di immagini di Google che la pagina ufficiale definisce il suo miglior motore per la creazione visiva ad alta velocità, con velocità ed efficienza allo stato dell'arte.
- Input
- testo immagine $0.3/M
- Output
- immagine testo $30/M
- Knowledge cutoff
- 2025-06
Benchmark
gemini-2.5-flash-image: 22 pubblicati, ma nessun benchmark in comune con abbastanza altri modelli per fare un confronto.
Il prezzo a confronto
Dove si colloca il prezzo tra 9 modelli confrontabili
La barra mostra dove si colloca il prezzo di questo modello tra tutti i modelli dello stesso tipo su Synthorai. Alle due estremità sono indicati il più economico e il più caro. Sono tariffe base; gli sconti per batch, regione e scrittura in cache sono nella pagina dei prezzi.
Specifiche e limiti
Token
| Output massimo (specifica del provider) | 32.768 |
|---|---|
| Knowledge cutoff | 2025-06 |
Immagine
| Dimensioni |
|
|---|---|
| Modalità di input | text-to-image, editing conversazionale delle immagini (immagine + testo in input) |
| Funzionalità per le immagini |
|
Modello
| Modalità | testo + immagine → immagine + testo |
|---|
- Insolitamente per un modello di immagini, pubblica un cutoff di conoscenza (giugno 2025)
- function calling e thinking non supportati
Un solo prompt, misurato attraverso il gateway
gemini-2.5-flash-image
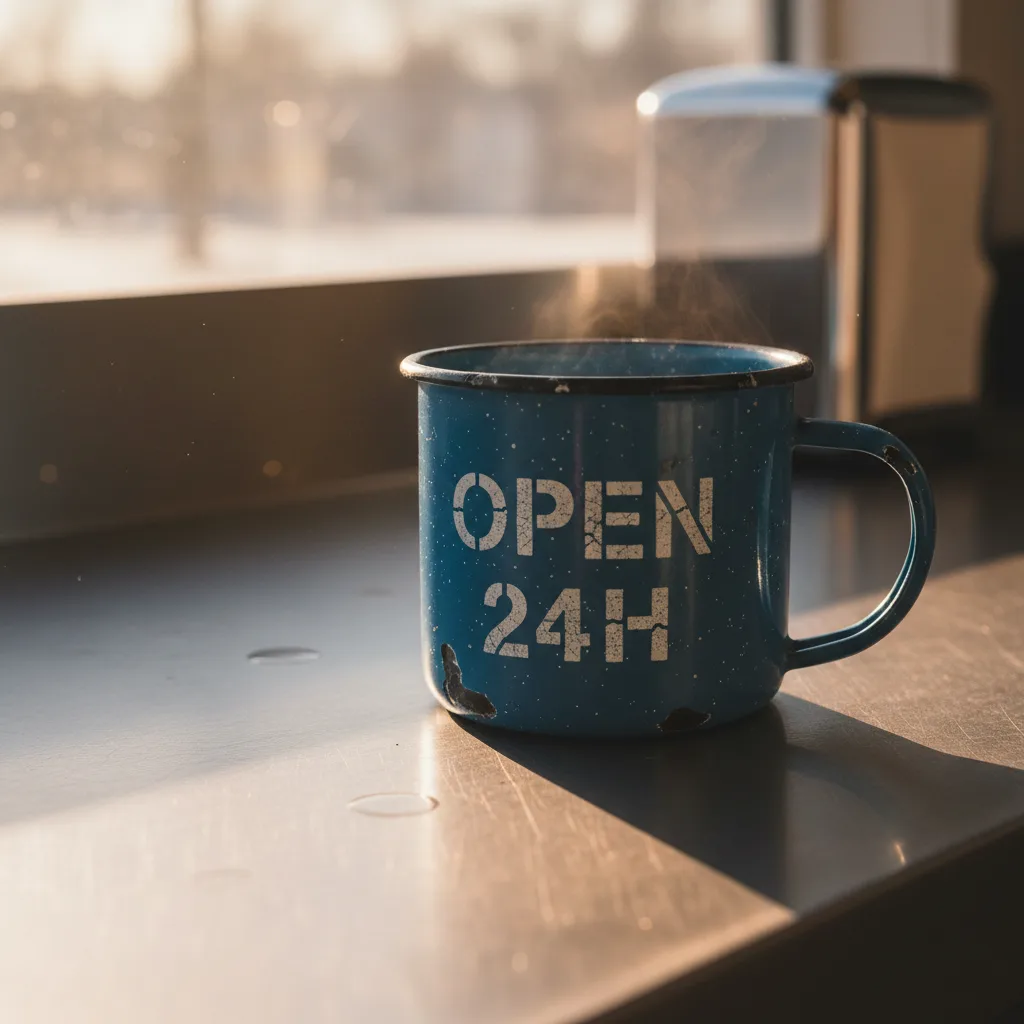
Restituito dal modello 1024×1024 latenza 7 s
Un prompt, una richiesta per modello, nessun nuovo tentativo e nessuna selezione: è il primo risultato restituito da ciascun modello. Non abbiamo fissato né le dimensioni né la durata: ogni modello ha usato il proprio default, perché una richiesta costruita per andare bene a tutti non avrebbe valorizzato nessuno. I file sono stati ricodificati per il web, quindi valuta la composizione e l'aderenza al prompt, non la compressione.
Usa gemini-2.5-flash-image in 30 secondi
Compatibile con OpenAI: cambi base_url e tieni il tuo SDK. POST /v1/images/generations
from openai import OpenAI

client = OpenAI(
    base_url="https://synthorai.io/v1",
    api_key="sk-syn-...",
)

resp = client.images.generate(
    model="gemini-2.5-flash-image",
    prompt="a watercolor lighthouse at dawn",
    size="1024x1024",
)
print(resp.data[0].b64_json[:80])
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://synthorai.io/v1",
apiKey: "sk-syn-...",
});
const resp = await client.images.generate({
model: "gemini-2.5-flash-image",
prompt: "a watercolor lighthouse at dawn",
size: "1024x1024",
});
console.log(resp.data?.[0]?.b64_json?.slice(0, 80));curl https://synthorai.io/v1/images/generations \
-H "Authorization: Bearer sk-syn-..." \
-H "Content-Type: application/json" \
-d '{
"model": "gemini-2.5-flash-image",
"prompt": "a watercolor lighthouse at dawn",
"size": "1024x1024"
}'package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/option"
)
func main() {
client := openai.NewClient(
option.WithBaseURL("https://synthorai.io/v1"),
option.WithAPIKey("sk-syn-..."),
)
resp, _ := client.Images.Generate(context.TODO(), openai.ImageGenerateParams{
Model: "gemini-2.5-flash-image",
Prompt: "a watercolor lighthouse at dawn",
Size: "1024x1024",
})
fmt.Println(resp.Data[0].B64JSON[:80])
}import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.images.*;
OpenAIClient client = OpenAIOkHttpClient.builder()
.baseUrl("https://synthorai.io/v1")
.apiKey("sk-syn-...")
.build();
ImagesResponse resp = client.images().generate(
ImageGenerateParams.builder()
.model("gemini-2.5-flash-image")
.prompt("a watercolor lighthouse at dawn")
.size("1024x1024")
.build());
System.out.println(resp.data().orElseThrow().get(0).b64Json().orElseThrow().substring(0, 80));Informazioni su gemini-2.5-flash-image
- È progettato per scenari ad alto volume, editing conversazionale delle immagini e flussi di lavoro a bassa latenza, e combina la comprensione multimodale nativa di input di immagini e testo con output di immagini e testo a 1K, 2K e 4K, con il controllo delle proporzioni aggiunto quando il modello è arrivato in disponibilità generale.
- L'editing segue lo schema della famiglia: raffinamento conversazionale multi-turno che porta avanti l'interazione precedente, aggiunta, rimozione o modifica di elementi, mascheratura semantica per l'inpainting, style transfer e composizione a partire da più immagini di riferimento.
- I limiti di token sono 65.536 in input e 32.768 in output, e sono supportati output strutturati, caching, elaborazione batch e inferenza Flex e Priority, mentre function calling, grounding con Search e thinking no, il che costituisce il tetto pratico di quanto ragionerà su un layout prima di disegnarlo.
- Ogni generazione porta un watermark SynthID.
- Google ora lo descrive come il pioniere legacy della serie Nano Banana e raccomanda di spostare il lavoro nuovo su Nano Banana 2 Lite per qualità migliore, velocità superiori e costo inferiore, quindi va trattato come l'opzione di compatibilità anziché come predefinito.
- Il suo cutoff di conoscenza è giugno 2025.
- Synthorai lo serve dietro lo stesso endpoint compatibile OpenAI dei suoi modelli di chat.
FAQ
L'API di gemini-2.5-flash-image si può provare gratis?
Sì: i nuovi account ricevono 10 chiamate di prova e fino a $1 di credito gratuito, senza bisogno di carta. Abbastanza per provare gemini-2.5-flash-image sul tuo carico di lavoro reale prima di aggiungere un metodo di pagamento.
In cosa eccelle gemini-2.5-flash-image?
Miglior motore per la creazione visiva ad alta velocità; editing conversazionale delle immagini a bassa latenza; velocità ed efficienza allo stato dell'arte. Il quadro completo è nella sezione «Informazioni», ripreso dalle note di rilascio ufficiali del provider.
Quanto costa gemini-2.5-flash-image?
Su Synthorai gemini-2.5-flash-image costa $0.3 per milione di token di input e $30 per milione di token di output: è il prezzo di listino del provider, senza sovrapprezzo di piattaforma.
Come genero immagini con l'API di gemini-2.5-flash-image?
Invia una POST a /v1/images/generations su Synthorai con model="gemini-2.5-flash-image": il formato è quello dell'API images di OpenAI, quindi non serve alcun SDK del provider. Dimensioni supportate: 1024x1024 (1:1), 832x1248 (2:3), 1248x832 (3:2), 864x1184 (3:4), 1184x864 (4:3), 896x1152 (4:5), 1152x896 (5:4), 768x1344 (9:16), 1344x768 (16:9), 1536x672 (21:9).
Come ottengo l'accesso a gemini-2.5-flash-image?
Fai puntare l'SDK OpenAI che usi già a base_url="https://synthorai.io/v1", imposta model="gemini-2.5-flash-image" e hai finito: una sola chiave API vale per tutti i modelli del gateway.
Modelli correlati
Confronta
Ogni valore di questa pagina è ripreso dalla documentazione del provider (il link è qui sopra) e riporta la data dell'ultima verifica. I prezzi sono confrontati sull'intero catalogo; per le specifiche che ogni provider definisce a modo suo indichiamo la differenza invece di metterle in un grafico. Qui non c'è nulla di misurato da noi e non assegniamo punteggi.