
gemini-3.1-flash-lite-image vs Seedream 5.0 Lite
Quale scegliere e quando
Questi due fatturano in unità diverse - gemini-3.1-flash-lite-image addebita per token ($0.25 per milione in ingresso, $30 per milione in uscita) mentre seedream-5-0-260128 addebita un costo fisso di $0.035 per chiamata - quindi nessuna conversione singola tra loro è onesta; calcola il budget in base alle dimensioni del tuo prompt e al volume di chiamate. Scegli il modello Google quando hai bisogno di ricevere testo insieme alle immagini, poiché emette sia testo che immagine (fino a 4096 token di output) da input di testo o immagine. Scegli il modello ByteDance per lavori puramente text-or-image-to-image a un costo prevedibile per chiamata.
Prezzi
| gemini-3.1-flash-lite-image | Seedream 5.0 Lite | Δ | |
|---|---|---|---|
| Per immagine generata | - | $0.035 | - |
| Input / 1M token | $0.25 | - | - |
| Output / 1M token | $30 | - | - |
Questi due modelli si pagano in unità diverse, quindi non mostriamo alcun Δ: per convertirle servirebbe un'ipotesi che non abbiamo misurato. Qui sopra ogni listino è riportato nella propria unità.
Specifiche
| gemini-3.1-flash-lite-image | Seedream 5.0 Lite | |
|---|---|---|
| Modalità di input | testo immagine | testo immagine |
| Modalità di output | testo immagine | immagine |
| Rilascio | 2026-06-30 | 2026-01 |
| Knowledge cutoff | 2025-01 | - |
| Dimensioni di output | solo 1K (1:1 = 1024x1024) |
|
| Modalità di input | text-to-image, generazione + editing interleaved, fino a 14 immagini di riferimento | text-to-image, image-to-image da singola immagine, image-to-image multi-riferimento (2-14 riferimenti), set di immagini batch/sequenziali |
| Immagini per richiesta | - | 15 |
| Formati | - | png, jpeg |
| Note | Output solo 1K (1024px) 10 proporzioni (1:1, 3:2, 2:3, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 21:9) e fino a 14 immagini di riferimento generazione ed editing interleaved con modifiche locali rapide su più turni latenza end-to-end sotto i 2 s watermarking SynthID + C2PA sempre attivo | Output 2K/3K/4K, png/jpeg text-to-image + editing di immagini a riferimento singolo/multiplo generazione batch con immagini di riferimento + generate <=15 500 IPM massimi |
Le specifiche sono riprese dalla documentazione di ciascun provider; se un provider non pubblica un dato, la riga viene omessa e non dedotta. Fonti complete: gemini-3.1-flash-lite-image · Seedream 5.0 Lite
Un solo prompt, entrambi i modelli, misurati attraverso il gateway
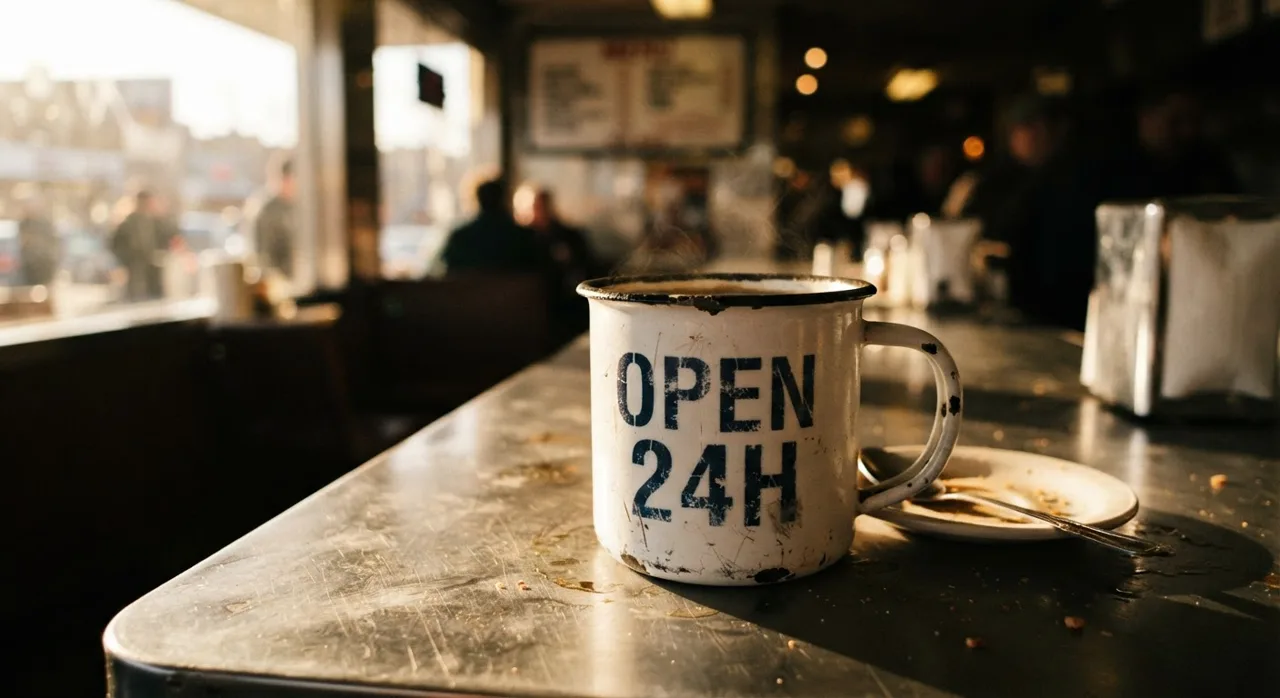
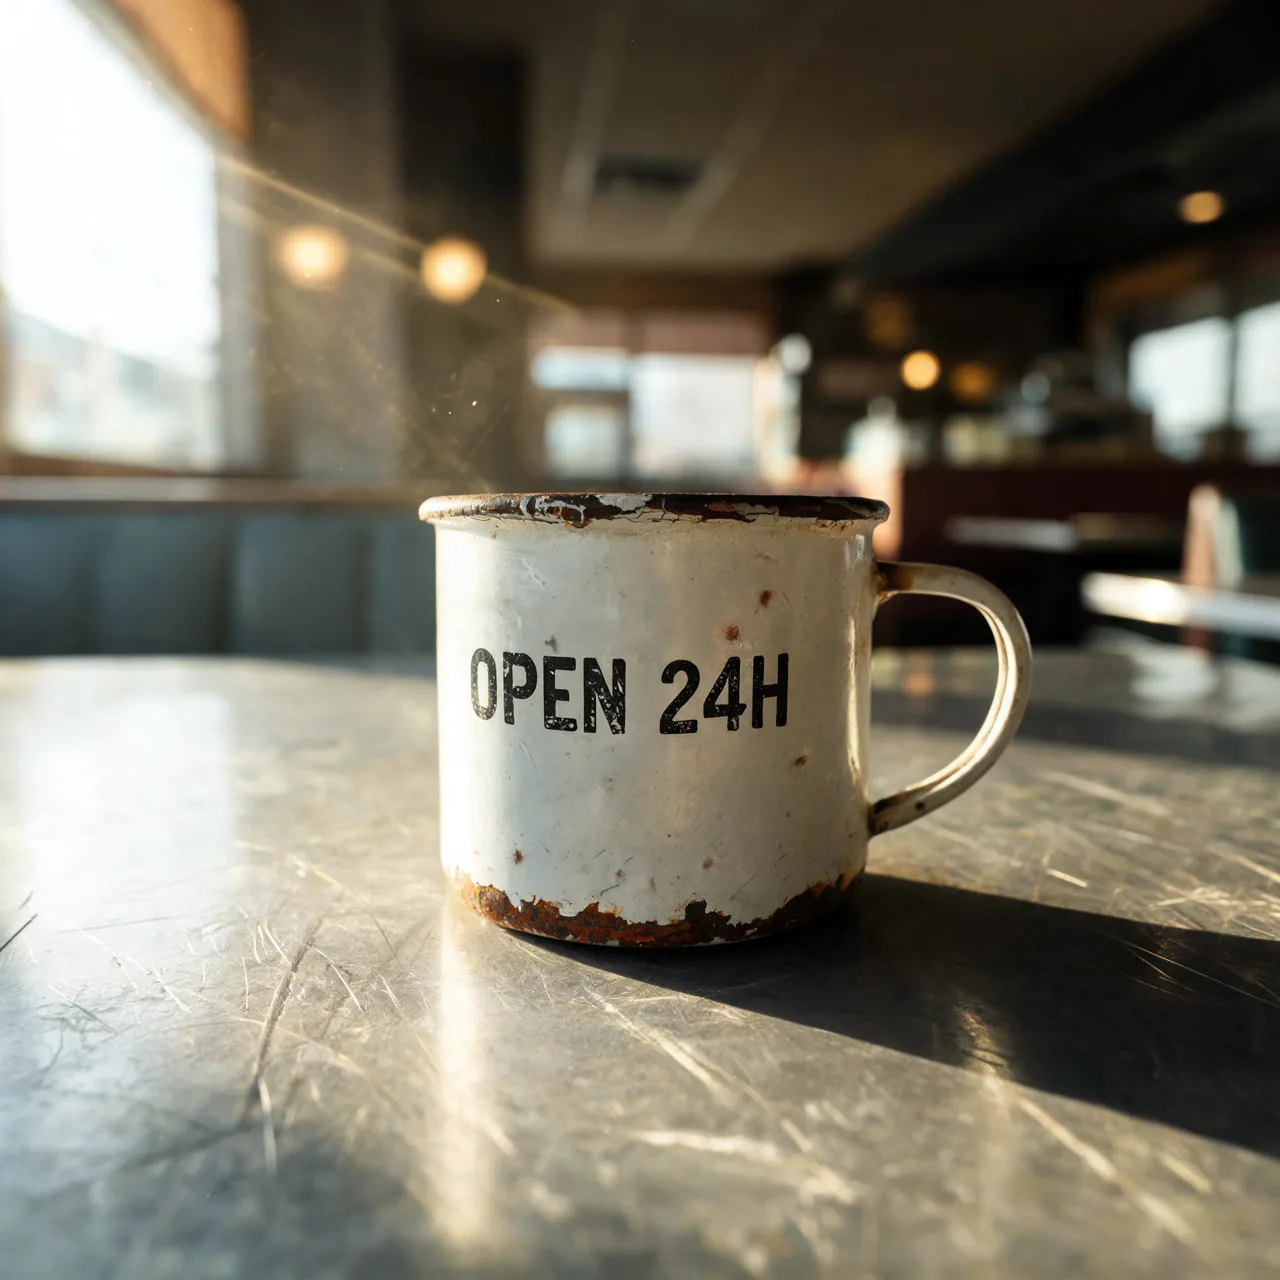
Un prompt, una richiesta per modello, nessun nuovo tentativo e nessuna selezione: è il primo risultato restituito da ciascun modello. Non abbiamo fissato né le dimensioni né la durata: ogni modello ha usato il proprio default, perché una richiesta costruita per andare bene a tutti non avrebbe valorizzato nessuno. I file sono stati ricodificati per il web, quindi valuta la composizione e l'aderenza al prompt, non la compressione.
Passa dall'uno all'altro cambiando una sola riga
In ogni scheda qui sotto ci sono entrambi gli id: le due righe evidenziate sono l'unica modifica. Stesso endpoint, stessa chiave, stessa struttura della richiesta.
from openai import OpenAI

client = OpenAI(
    base_url="https://synthorai.io/v1",
    api_key="sk-syn-...",
)

resp = client.images.generate(
    model="gemini-3.1-flash-lite-image",
    # model="seedream-5-0-260128",  # decommenta questa riga, commenta quella sopra
    prompt="a watercolor lighthouse at dawn",
    size="1024x1024",
)
print(resp.data[0].b64_json[:80])
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://synthorai.io/v1",
apiKey: "sk-syn-...",
});
const resp = await client.images.generate({
model: "gemini-3.1-flash-lite-image",
// model: "seedream-5-0-260128", // decommenta questa riga, commenta quella sopra
prompt: "a watercolor lighthouse at dawn",
size: "1024x1024",
});
console.log(resp.data?.[0]?.b64_json?.slice(0, 80));curl https://synthorai.io/v1/images/generations \
-H "Authorization: Bearer sk-syn-..." \
-H "Content-Type: application/json" \
-d '{
"model": "gemini-3.1-flash-lite-image",
# "model": "seedream-5-0-260128", # decommenta questa riga, commenta quella sopra
"prompt": "a watercolor lighthouse at dawn",
"size": "1024x1024"
}'package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/option"
)
func main() {
client := openai.NewClient(
option.WithBaseURL("https://synthorai.io/v1"),
option.WithAPIKey("sk-syn-..."),
)
resp, _ := client.Images.Generate(context.TODO(), openai.ImageGenerateParams{
Model: "gemini-3.1-flash-lite-image",
// Model: "seedream-5-0-260128", // decommenta questa riga, commenta quella sopra
Prompt: "a watercolor lighthouse at dawn",
Size: "1024x1024",
})
fmt.Println(resp.Data[0].B64JSON[:80])
}import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.images.*;
OpenAIClient client = OpenAIOkHttpClient.builder()
.baseUrl("https://synthorai.io/v1")
.apiKey("sk-syn-...")
.build();
ImagesResponse resp = client.images().generate(
ImageGenerateParams.builder()
.model("gemini-3.1-flash-lite-image")
// .model("seedream-5-0-260128") // decommenta questa riga, commenta quella sopra
.prompt("a watercolor lighthouse at dawn")
.size("1024x1024")
.build());
System.out.println(resp.data().orElseThrow().get(0).b64Json().orElseThrow().substring(0, 80));FAQ
Qual è il più economico, gemini-3.1-flash-lite-image o Seedream 5.0 Lite?
Si pagano in unità diverse, quindi non esiste un numero unico che sia corretto. Nella tabella qui sopra gemini-3.1-flash-lite-image e Seedream 5.0 Lite compaiono ciascuno nella propria unità. Confrontali sul tuo carico di lavoro: il compromesso pratico è descritto nel verdetto in cima alla pagina.
Posso fare un A/B test di gemini-3.1-flash-lite-image contro Seedream 5.0 Lite senza due integrazioni?
Sì. Si chiamano entrambi dallo stesso endpoint compatibile con OpenAI, con una sola chiave API. Per passare dall'uno all'altro basta cambiare la stringa del modello in una riga, quindi puoi mandare una parte del traffico a ciascuno e confrontare direttamente i costi.
Il prezzo cambia in base alla dimensione dell'immagine?
Dipende da come viene fatturato il modello. Quelli fatturati per immagine costano lo stesso a prescindere dalla dimensione del prompt o dell'output; in quelli fatturati a token il costo cresce con la risoluzione generata, quindi un'immagine 4K costa un multiplo di una piccola. La tabella qui sopra indica quale criterio vale per ciascun modello.