
gemini-3.1-flash-lite-image vs GPT Image 2
Quale scegliere e quando
Entrambi sono modelli di immagini che addebitano gli stessi $30 per milione di token di output, quindi la vera differenza è sull'input: gemini-3.1-flash-lite-image accetta testo e immagini a $0.25 per milione contro i $5 di gpt-image-2, rendendolo 20x più economico per fornire prompt e immagini di riferimento. Scegli gemini-3.1-flash-lite-image per pipeline ricche di prompt o image-in-image-out in cui il volume di input domina la fattura, e nota che può anche restituire testo insieme alle immagini, con un limite in output di 4096 token e il thinking che non può essere disattivato. Scegli gpt-image-2 quando desideri un endpoint puramente image-out da OpenAI e il costo di input è una voce di spesa minore.
Prezzi
| gemini-3.1-flash-lite-image | GPT Image 2 | Δ | |
|---|---|---|---|
| Input / 1M token | $0.25 | $5 | 0.05× |
| Output / 1M token | $30 | $30 | = |
Tariffe lette dal catalogo live al momento della build; il listino aggiornato è sulla pagina di ciascun modello.
Dove si collocano: prezzo di output per 1M di token tra tutti i modelli di generazione di immagini con questa unità di fatturazione (9, scala logaritmica)
Specifiche
| gemini-3.1-flash-lite-image | GPT Image 2 | |
|---|---|---|
| Modalità di input | testo immagine | testo immagine |
| Modalità di output | testo immagine | immagine |
| Rilascio | 2026-06-30 | 2026-04-21 |
| Knowledge cutoff | 2025-01 | - |
| Dimensioni di output | 1K only (1:1 = 1024x1024) |
|
| Modalità di input | text-to-image, interleaved generation + editing, up to 14 reference images | text-to-image, image edit with mask inpainting |
| Immagini per richiesta | - | 10 |
| Formati | - | png, jpeg, webp |
| Note | 1K (1024px) output only 10 aspect ratios (1:1, 3:2, 2:3, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 21:9) and up to 14 reference images interleaved generation and editing with fast multi-turn local edits sub-2s end-to-end latency SynthID + C2PA watermarking always on | Flexible resolutions: edges up to 3840px in multiples of 16, ratio <=3:1, ~0.65-8.3MP total (incl. 4K 3840x2160) editing with mask inpainting all image inputs processed at high fidelity significantly improved text rendering (precise placement can still struggle) |
Le specifiche sono riprese dalla documentazione di ciascun provider; se un provider non pubblica un dato, la riga viene omessa e non dedotta. Fonti complete: gemini-3.1-flash-lite-image · GPT Image 2
Un solo prompt, entrambi i modelli, misurati attraverso il gateway
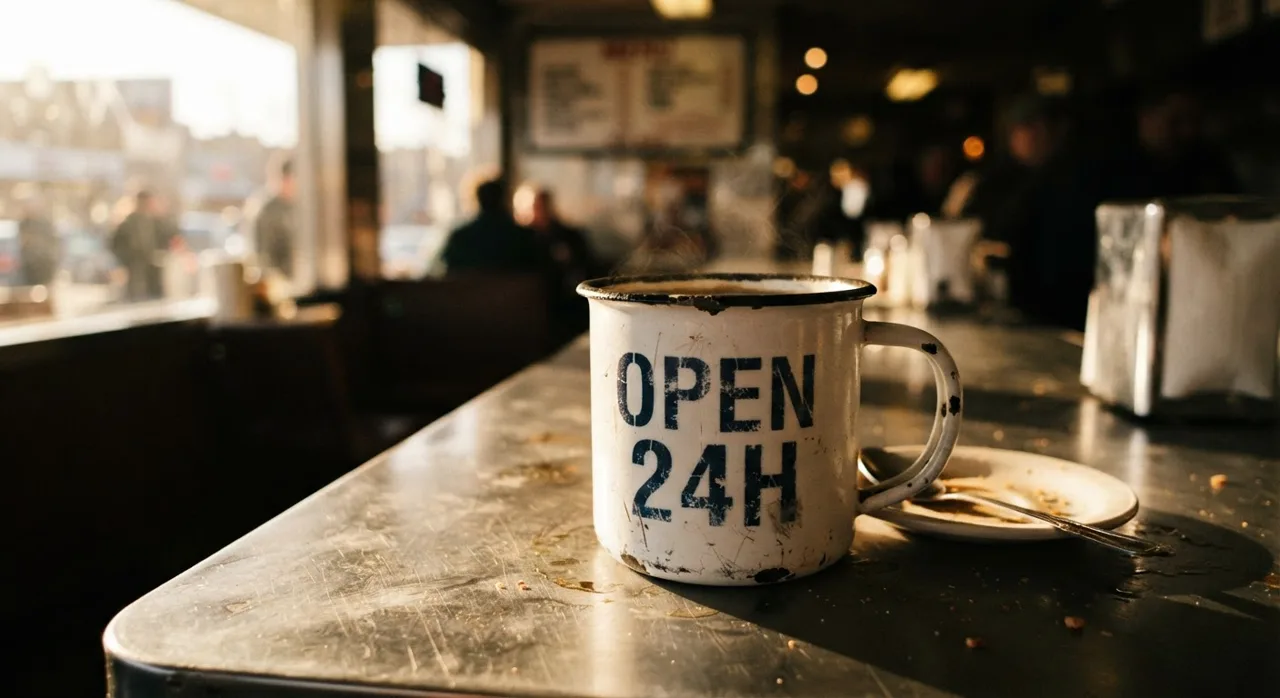
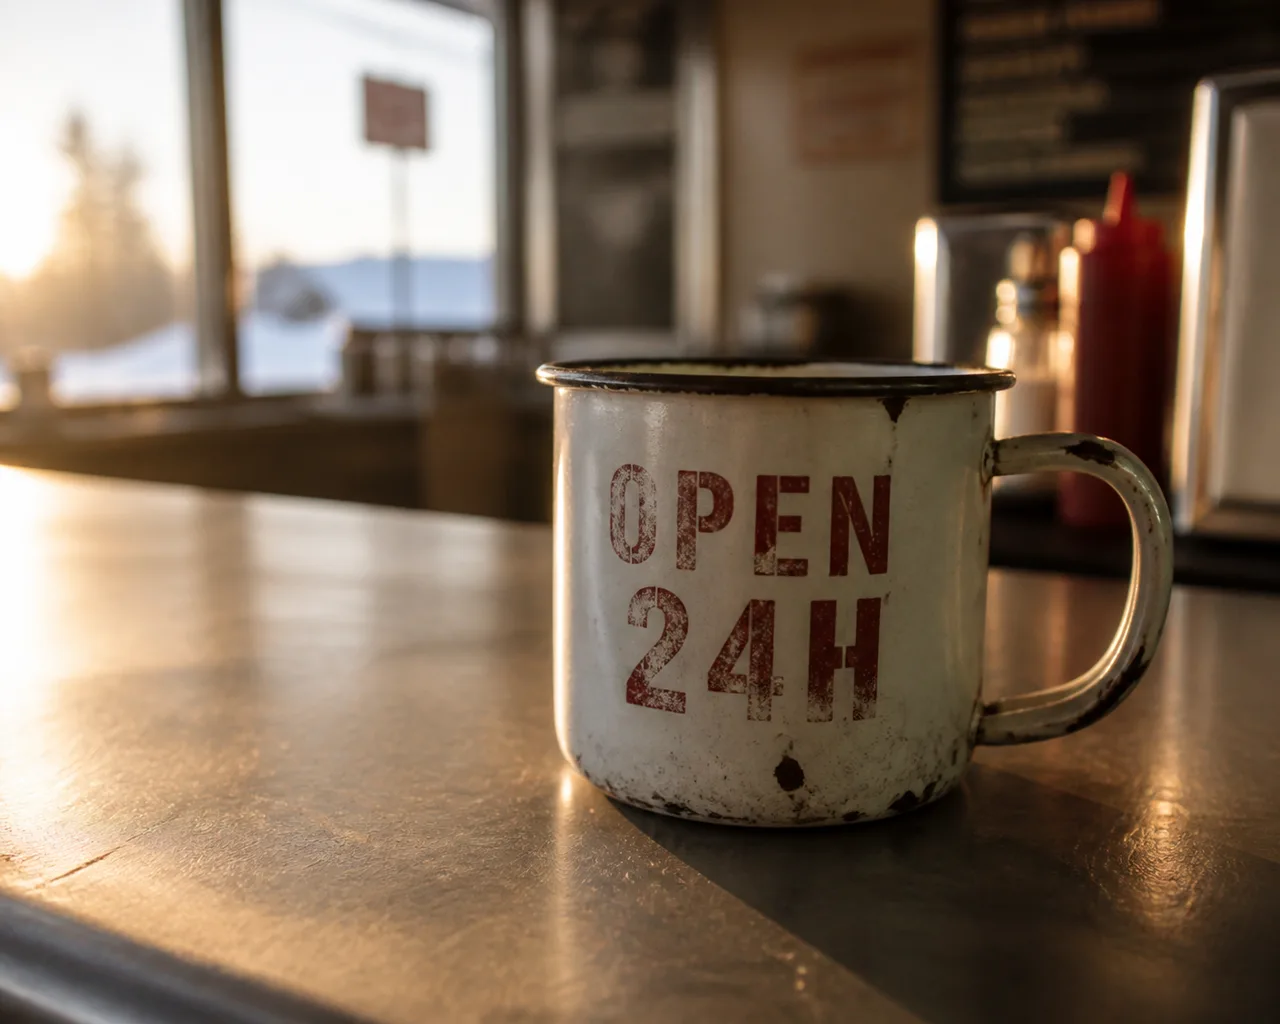
Un prompt, una richiesta per modello, nessun nuovo tentativo e nessuna selezione: è il primo risultato restituito da ciascun modello. Non abbiamo fissato né le dimensioni né la durata: ogni modello ha usato il proprio default, perché una richiesta costruita per andare bene a tutti non avrebbe valorizzato nessuno. I file sono stati ricodificati per il web, quindi valuta la composizione e l'aderenza al prompt, non la compressione.
Passa dall'uno all'altro cambiando una sola riga
In ogni scheda qui sotto ci sono entrambi gli id: le due righe evidenziate sono l'unica modifica. Stesso endpoint, stessa chiave, stessa struttura della richiesta.
from openai import OpenAI

client = OpenAI(
    base_url="https://synthorai.io/v1",
    api_key="sk-syn-...",
)

resp = client.images.generate(
    model="gemini-3.1-flash-lite-image",
    # model="gpt-image-2",  # decommenta questa riga, commenta quella sopra
    prompt="a watercolor lighthouse at dawn",
    size="1024x1024",
)
print(resp.data[0].b64_json[:80])
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://synthorai.io/v1",
apiKey: "sk-syn-...",
});
const resp = await client.images.generate({
model: "gemini-3.1-flash-lite-image",
// model: "gpt-image-2", // decommenta questa riga, commenta quella sopra
prompt: "a watercolor lighthouse at dawn",
size: "1024x1024",
});
console.log(resp.data?.[0]?.b64_json?.slice(0, 80));curl https://synthorai.io/v1/images/generations \
-H "Authorization: Bearer sk-syn-..." \
-H "Content-Type: application/json" \
-d '{
"model": "gemini-3.1-flash-lite-image",
# "model": "gpt-image-2", # decommenta questa riga, commenta quella sopra
"prompt": "a watercolor lighthouse at dawn",
"size": "1024x1024"
}'package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/option"
)
func main() {
client := openai.NewClient(
option.WithBaseURL("https://synthorai.io/v1"),
option.WithAPIKey("sk-syn-..."),
)
resp, _ := client.Images.Generate(context.TODO(), openai.ImageGenerateParams{
Model: "gemini-3.1-flash-lite-image",
// Model: "gpt-image-2", // decommenta questa riga, commenta quella sopra
Prompt: "a watercolor lighthouse at dawn",
Size: "1024x1024",
})
fmt.Println(resp.Data[0].B64JSON[:80])
}import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.images.*;
OpenAIClient client = OpenAIOkHttpClient.builder()
.baseUrl("https://synthorai.io/v1")
.apiKey("sk-syn-...")
.build();
ImagesResponse resp = client.images().generate(
ImageGenerateParams.builder()
.model("gemini-3.1-flash-lite-image")
// .model("gpt-image-2") // decommenta questa riga, commenta quella sopra
.prompt("a watercolor lighthouse at dawn")
.size("1024x1024")
.build());
System.out.println(resp.data().orElseThrow().get(0).b64Json().orElseThrow().substring(0, 80));FAQ
Qual è il più economico, gemini-3.1-flash-lite-image o GPT Image 2?
gemini-3.1-flash-lite-image costa meno alla voce Input / 1M token ($0.25 contro $5, 20× di differenza). Altre voci potrebbero dire il contrario: la tabella qui sopra riporta il listino completo, e il costo reale dipende dal tuo mix di utilizzo.
Posso fare un A/B test di gemini-3.1-flash-lite-image contro GPT Image 2 senza due integrazioni?
Sì. Si chiamano entrambi dallo stesso endpoint compatibile con OpenAI, con una sola chiave API. Per passare dall'uno all'altro basta cambiare la stringa del modello in una riga, quindi puoi mandare una parte del traffico a ciascuno e confrontare direttamente i costi.
Il prezzo cambia in base alla dimensione dell'immagine?
Dipende da come viene fatturato il modello. Quelli fatturati per immagine costano lo stesso a prescindere dalla dimensione del prompt o dell'output; in quelli fatturati a token il costo cresce con la risoluzione generata, quindi un'immagine 4K costa un multiplo di una piccola. La tabella qui sopra indica quale criterio vale per ciascun modello.