
GPT-4 e GPT-3.5 Turbo chiusi il 23/10: sostituire 3.5 costa quasi 5x
Indice
Il 2026-10-23 OpenAI disattiva GPT-4, GPT-4 Turbo, GPT-3.5 Turbo, GPT-4.1 nano, o1, o3-mini e o4-mini. Tutti i modelli di testo indicati come sostituti appartengono alla famiglia GPT-5.6: la lista è stata scritta cinque mesi prima dell’arrivo di GPT-6. Per chi usa GPT-3.5 Turbo, seguire quella lista significa pagare circa cinque volte di più. Nei nostri test, GPT-5.6 Terra, il sostituto indicato, è costato $0.75 per 1.000 chiamate brevi, contro circa $0.15 ai prezzi di GPT-3.5 Turbo. GPT-6 Luna ha completato le stesse chiamate per $0.037, senza errori.
TL;DR
- Il 2026-10-23 OpenAI disattiva GPT-4, GPT-4 Turbo, GPT-3.5 Turbo, GPT-4.1 nano, gpt-4o-2024-05-13, o1, o1-pro, o3-mini e o4-mini.
- GPT-5.6 Terra, indicato da OpenAI come sostituto di GPT-3.5 Turbo, ha un prezzo di listino di $2 / $12 per milione di token, contro $0.50 / $1.50.
- Tutti e cinque i candidati alla sostituzione hanno risolto correttamente i 96 task brevi.
- Costo per 1.000 chiamate: GPT-5.6 Sol $1.41, GPT-6.1 Sol $0.72, GPT-5.6 Terra $0.75, GPT-5.6 Luna $0.075, GPT-6 Luna $0.037.
Quali modelli OpenAI vengono disattivati il 23 ottobre e cosa li sostituisce?
Il 2026-10-23 smettono di rispondere nove famiglie di modelli di testo. La pagina sui modelli deprecati di OpenAI associa ciascuna a un modello GPT-5.6. Ogni riga comprende gli snapshot datati del modello (versioni fissate come gpt-4-0613) e le versioni fine-tuned (copie addestrate su misura). I prezzi sono quelli di listino per milione di token, input / output, riportati nella pagina dei prezzi e nelle pagine dei modelli OpenAI.
| Modello ritirato | Prezzo di listino | Sostituto indicato da OpenAI | Prezzo di listino |
|---|---|---|---|
| GPT-4 | $30 / $60 | GPT-5.6 Sol | $4 / $20 |
| GPT-4 Turbo | $10 / $30 | GPT-5.6 Sol | $4 / $20 |
| gpt-4o-2024-05-13 | $5 / $15 | GPT-5.6 Sol | $4 / $20 |
| o1 | $15 / $60 | GPT-5.6 Sol | $4 / $20 |
| o1-pro | $150 / $600 | GPT-5.6 Sol | $4 / $20 |
| o3-mini | $1.10 / $4.40 | GPT-5.6 Sol | $4 / $20 |
| GPT-4.1 nano | $0.10 / $0.40 | GPT-5.6 Luna | $0.20 / $1.20 |
| GPT-3.5 Turbo | $0.50 / $1.50 | GPT-5.6 Terra | $2 / $12 |
| o4-mini | $1.10 / $4.40 | GPT-5.6 Terra | $2 / $12 |
Nella stessa data vengono ritirati anche gpt-image-1 (sostituito da gpt-image-2.5-sunburst o gpt-image-2.5-flare) e le versioni fine-tuned di babbage-002 e davinci-002. GPT-4o e i suoi snapshot più recenti non sono nella lista. Sono già previste altre due disattivazioni: tts-1 e tts-1-hd il 2027-01-06; gpt-5.1, gpt-5.3-codex e gpt-5.4-nano il 2027-04-01.
OpenAI ha annunciato questo gruppo di disattivazioni il 2026-04-22. GPT-6 è uscito il 2026-09-22, quindi non poteva comparire tra i sostituti indicati. In quattro dei nove casi il prezzo di listino aumenta: o3-mini, GPT-4.1 nano, GPT-3.5 Turbo e o4-mini.
Il sostituto indicato da OpenAI è il più economico?
No, in nessuna riga: i modelli della famiglia GPT-6 hanno prezzi di listino pari a circa la metà di quelli GPT-5.6, ma non compaiono nella tabella. Sol, Terra e Luna sono rispettivamente le fasce alta, media e bassa. Il prezzo dell’input in cache si applica alla parte del prompt che OpenAI recupera dalla propria prompt cache.
| Input | Input in cache | Output | |
|---|---|---|---|
| GPT-5.6 Sol | $4.00 | $0.40 | $20.00 |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 |
| GPT-5.6 Terra | $2.00 | $0.20 | $12.00 |
| GPT-5.6 Luna | $0.20 | $0.02 | $1.20 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 |
Il prezzo di $4 / $20 di GPT-5.6 Sol è promozionale e, secondo OpenAI, resterà disponibile almeno fino al 2026-11-21. GPT-6 non ha una fascia Terra. GPT-5.6 Terra costa più delle alternative su entrambi i fronti: GPT-6.1 Sol, di fascia superiore, ha lo stesso prezzo di input e un prezzo di output inferiore; GPT-6 Luna costa venti volte meno.
Come abbiamo condotto il test?
Il listino dice quanto costa un token. Per scegliere un sostituto bisogna sapere anche se il modello più economico svolge comunque il lavoro e se consuma token aggiuntivi per il reasoning. Tutti e cinque i candidati sono modelli di reasoning. reasoning.effort è il parametro della Responses API che regola quanto reasoning nascosto il modello esegue prima di rispondere. Quei token vengono fatturati come output. Se non si imposta il parametro, si usa il valore predefinito del modello (medium su GPT-6.1 Sol e GPT-6 Luna); none disattiva il reasoning.
Abbiamo eseguito 96 task brevi, tipici degli utilizzi di GPT-3.5 Turbo e GPT-4.1 nano. Per ciascuno c’era una sola risposta corretta, verificata via codice:
- Classificazione: 40 messaggi di assistenza, 8 etichette e regole per i messaggi compatibili con due etichette.
- Estrazione: 30 e-mail sugli ordini trasformate in un oggetto JSON con 6 campi, con elementi fuorvianti come l’ID di un ordine precedente e un subtotale.
- Chiamate ai tool: 26 richieste di assistenza da convertire in una chiamata di funzione con gli argomenti corretti, scegliendo tra 5 tool.
Altre quattro richieste di tool non sono valutate. Pongono una domanda prima di indicare la modifica («L’ordine A-88643 non è ancora stato spedito, vero? Il nuovo indirizzo di consegna è a Graz»), e 18 risposte su 56 hanno consultato l’ordine prima di cambiare l’indirizzo: 9 su 12 con GPT-6 Luna, 4 su 12 con GPT-5.6 Luna, 3 su 12 con GPT-5.6 Terra e 1 con ciascuno dei due modelli Sol. Entrambe le letture sono difendibili, quindi queste quattro mettono alla prova la formulazione più che il modello.
Ogni modello ha eseguito i task con il reasoning disattivato, a low e al valore predefinito (GPT-6.1 Sol solo a low e al valore predefinito, perché non accetta none): 1.344 chiamate, ciascuna con una stringa casuale univoca per evitare risultati dalla cache. Per i costi abbiamo usato i prezzi di listino OpenAI. Non possiamo chiamare i modelli in dismissione, quindi il loro costo è una stima: abbiamo applicato i rispettivi prezzi di listino ai token misurati nei test (234 di input e 24 di output per chiamata). I tokenizer, che suddividono il testo in token, cambiano tra una generazione e l’altra: queste cifre sono approssimative.
Quanto costa ogni sostituto per 1.000 chiamate?
Per questi task brevi la scelta dipende dal prezzo: i modelli hanno avuto tutti la stessa accuratezza, con 96 risposte corrette su 96 a ogni impostazione. La tabella mostra il costo per 1.000 chiamate con il reasoning disattivato (low su GPT-6.1 Sol).
| Modello attuale | Costo attuale stimato | Sostituto indicato da OpenAI | Alternativa GPT-6 |
|---|---|---|---|
| GPT-4 | $8.48 | GPT-5.6 Sol, $1.41 | GPT-6.1 Sol, $0.72 |
| GPT-4 Turbo | $3.07 | GPT-5.6 Sol, $1.41 | GPT-6.1 Sol, $0.72 |
| gpt-4o-2024-05-13 | $1.53 | GPT-5.6 Sol, $1.41 | GPT-6.1 Sol, $0.72 |
| GPT-3.5 Turbo | $0.15 | GPT-5.6 Terra, $0.75 | GPT-6 Luna, $0.037 |
| GPT-4.1 nano | $0.033 | GPT-5.6 Luna, $0.075 | GPT-6 Luna, $0.037 |
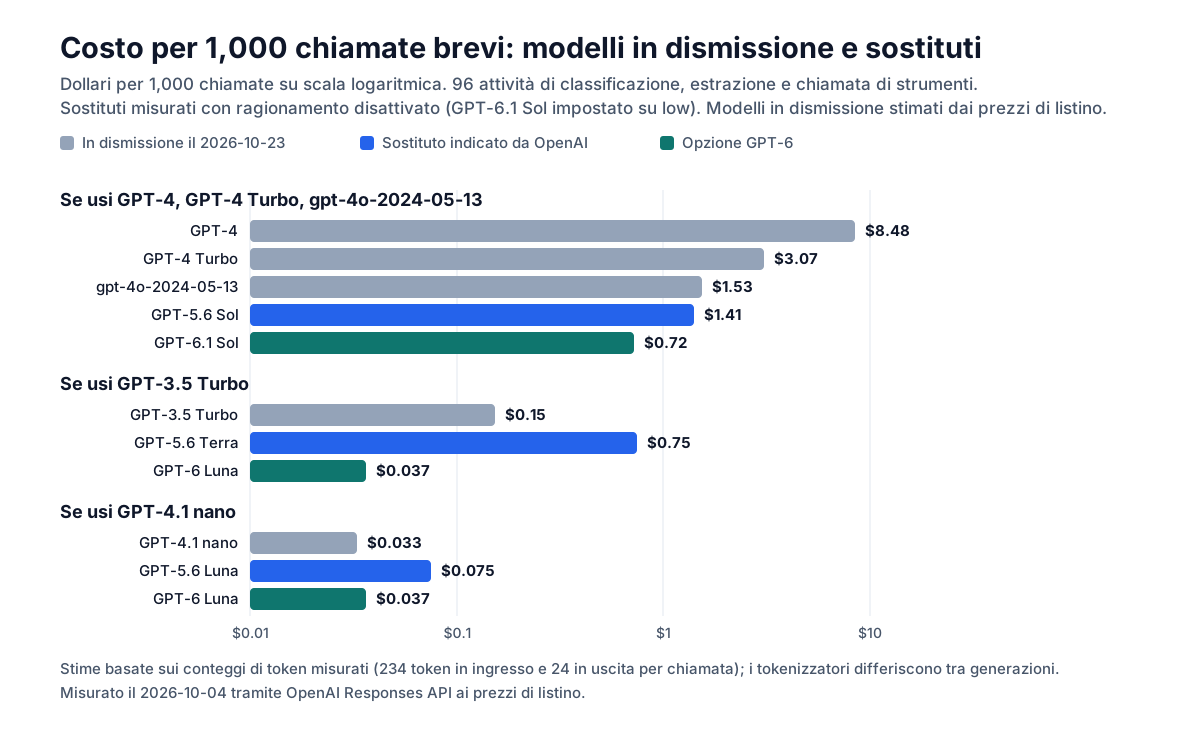
Per GPT-4 e GPT-4 Turbo, qualunque sostituzione riduce la spesa. Per gpt-4o-2024-05-13, GPT-5.6 Sol costa più o meno uguale e GPT-6.1 Sol costa la metà. Per GPT-3.5 Turbo, il sostituto indicato costa 4,9 volte tanto, mentre GPT-6 Luna costa un quarto. Per GPT-4.1 nano, il sostituto indicato costa 2,3 volte tanto e GPT-6 Luna costa circa uguale.
I modelli della serie o non compaiono in questa tabella. Non possiamo misurare i token di reasoning consumati da o1, o3-mini e o4-mini, quindi per loro valgono solo i prezzi di listino della prima tabella. Per i carichi di lavoro che richiedono reasoning, le nostre misurazioni di GPT-6.1 Sol coprono 13 task per ogni impostazione di effort.
Il reasoning predefinito fa aumentare il costo?
L’impostazione predefinita aumenta poco il costo sui modelli Sol e di più su quelli economici. Nei nostri test, lasciare reasoning.effort al valore predefinito ha aumentato il costo delle chiamate del 5% su GPT-5.6 Sol e GPT-6.1 Sol, del 22% su GPT-5.6 Terra, del 34% su GPT-6 Luna e del 42% su GPT-5.6 Luna, senza migliorare l’accuratezza. I token di reasoning erano pochi, al massimo 25 per chiamata. Ma se la risposta è di soli 24 token, raddoppiano i token di output.
from openai import OpenAI

client = OpenAI()
resp = client.responses.create(
    model="gpt-6-luna",
    reasoning={"effort": "none"},  # no hidden reasoning; use "low" on gpt-6.1-sol
    max_output_tokens=64,
    input="Classify the customer message into exactly one label: ...",
)
print(resp.output_text)
print(resp.usage.output_tokens, resp.usage.output_tokens_details.reasoning_tokens)
Un limite di output basso, comune nel codice di classificazione scritto per GPT-3.5 Turbo, non ha creato problemi in questo test: con max_output_tokens impostato a 64, tutte le 200 chiamate hanno restituito l’etichetta, anche con l’impostazione di effort predefinita. Un task che richiede più reasoning potrebbe comunque esaurire un limite basso prima che il modello scriva la risposta. Controllate output_tokens_details.reasoning_tokens sulle vostre chiamate.
Quattro modelli su cinque hanno avuto una latenza simile, con una mediana tra 2,2 e 2,4 secondi per chiamata. GPT-6.1 Sol ha impiegato tra 2,9 e 3,2 secondi.
La guida alla migrazione di OpenAI elenca le modifiche alle richieste: temperature, top_p e top_logprobs vanno rimossi, a meno che l’effort non sia none; GPT-6.1 Sol non accetta none; per chiamare i tool con il reasoning serve la Responses API.
Quale sostituto scegliere?
La scelta dipende dall’uso del modello in dismissione. Il sostituto indicato da OpenAI è una delle opzioni, non l’unica.
| Modello attuale | Scelta | Motivo |
|---|---|---|
| GPT-3.5 Turbo per classificazione, estrazione, routing | GPT-6 Luna con reasoning.effort: "none" | $0.037 per 1.000 chiamate contro $0.75 con GPT-5.6 Terra; entrambi corretti su 96 task su 96 |
| GPT-4.1 nano | GPT-6 Luna con effort none | $0.037 contro gli attuali $0.033; GPT-5.6 Luna costa $0.075 |
| GPT-4, GPT-4 Turbo o gpt-4o-2024-05-13 per task brevi | GPT-6.1 Sol a low, oppure GPT-6 Luna se supera i test sui vostri dati | $0.72 contro $1.41 con GPT-5.6 Sol, il cui prezzo è promozionale |
| GPT-4 per documenti lunghi | GPT-6.1 Sol | nel nostro test sui documenti produce testi lunghi quanto quelli di GPT-5.6 Sol, al 59% in meno per documento; GPT-6 Luna scrive circa la metà se il prompt non specifica le sezioni |
| Qualsiasi utilizzo in cui ogni chiamata deve essere rapida | GPT-6 Luna o GPT-5.6 Sol | GPT-6.1 Sol è stato il più lento nel test: tra 2,9 e 3,2 secondi contro 2,2-2,4 |
| o1, o3-mini, o4-mini | GPT-6.1 Sol a medium o superiore | Il prezzo di listino di $2 / $10 è inferiore a quello di entrambi i sostituti indicati ($4 / $20 e $2 / $12), ma superiore ai $1.10 / $4.40 di o3-mini e o4-mini; misurate i costi sui vostri task, perché il costo del reasoning dipende dal task |
Per i modelli fine-tuned non basta cambiare il nome del modello. OpenAI indica un modello base per ciascuno, ma il fine-tune va ricreato o sostituito con un prompt. Non abbiamo testato questo caso.
I nostri task sono brevi e hanno una sola risposta corretta. Prima di cambiare modello, provate i vostri prompt sul candidato e confrontate gli output: un modello di fascia più economica che risolve correttamente tutti i nostri 96 task potrebbe comportarsi diversamente sui vostri.
FAQ
Quando viene disattivato GPT-4 nell’API?
GPT-4, GPT-4 Turbo e lo snapshot gpt-4o-2024-05-13 vengono disattivati nell’API OpenAI il 2026-10-23, insieme a GPT-3.5 Turbo, GPT-4.1 nano, o1, o1-pro, o3-mini e o4-mini. OpenAI ha annunciato la data il 2026-04-22.
Cosa sostituisce GPT-3.5 Turbo? OpenAI indica GPT-5.6 Terra come sostituto di GPT-3.5 Turbo, a $2 / $12 per milione di token contro $0.50 / $1.50. Nel nostro test GPT-6 Luna, a $0.10 / $0.50, ha risolto correttamente gli stessi 96 task brevi a un ventesimo del costo di GPT-5.6 Terra.
GPT-6 Luna costa meno di GPT-3.5 Turbo? Il prezzo di listino di GPT-6 Luna è $0.10 per l’input e $0.50 per l’output per milione di token: un quinto e un terzo dei rispettivi $0.50 e $1.50 di GPT-3.5 Turbo. Con il reasoning disattivato, 1.000 chiamate brevi sono costate $0.037 nel nostro test, contro circa $0.15 ai prezzi di GPT-3.5 Turbo.
Altre misurazioni: GPT-6.1 Sol a confronto con Claude Sonnet 5.5, GPT-6 Luna a confronto con GPT-5.6 Luna e come ridurre i costi di GPT-5.6.