
Claude Opus 5.5 : mêmes réponses qu'Opus 5, sorties divisées par 2
Sommaire
- Qu’est-ce qui a réellement changé dans Claude Opus 5.5 ?
- Que disent les benchmarks de lancement ?
- Le modèle est-il vraiment moins cher en single-shot ?
- Que se passe-t-il dans une boucle d’outils, quand les coûts agentiques s’accumulent ?
- Quelle part de l’économie vient uniquement de la baisse de prix ?
- Un niveau d’effort plus élevé est-il parfois rentable ?
- Qu’est-ce qui casse quand on change l’ID du modèle ?
- Les budgets de prompt restent-ils valables ?
- Quand faut-il migrer ?
- FAQ
Claude Opus 5.5 coûte 20% moins cher que Claude Opus 5 au tarif catalogue, soit $4 par million de tokens en entrée et $20 par million de tokens en sortie, contre $5 et $25. Cette baisse de 20% s’applique indépendamment du comportement du modèle. La vraie question est donc l’économie qui subsiste après l’avoir neutralisée. Sur 13 tâches single-shot avec les réglages par défaut de chaque modèle, Opus 5.5 a coûté 65% de moins. À prix identique, il reste 56% moins cher. Dans une boucle d’outils multi-hop, l’écart se resserre nettement : 37% de moins sur la facture, puis 22% une fois les tarifs alignés.
TL;DR
- Sur 468 appels évalués, Opus 5.5 a coûté $0.0072 par tâche, contre $0.0204 pour Opus 5. Les deux ont répondu correctement à toutes les tâches.
- À tarif identique, Opus 5.5 reste 56% moins cher sur ces tâches : il produit en moyenne 341 tokens de sortie, contre 799.
- Dans une boucle d’outils portant sur quatre questions, l’écart tombe à 22% à prix égal, car les tokens d’entrée dominent et les deux modèles lisent les mêmes fichiers.
- Avec l’effort
max, Opus 5.5 a coûté 3.3x plus que son propre réglage par défaut dans cette boucle, sans rien résoudre de plus. tool_choicedéfini suranyou sur un outil nommé renvoie désormais une erreur HTTP 400. Opus 5 accepte les deux.
Anthropic a lancé Opus 5.5 le 2026-09-22 en affirmant que son exécution « coûte 40% moins cher qu’Opus 5 » sur des workloads typiques. Seule la seconde moitié de cette affirmation, la baisse du nombre de tokens par tâche, dépend du comportement du modèle. C’est donc cette partie que nous avons mesurée.
Qu’est-ce qui a réellement changé dans Claude Opus 5.5 ?
La baisse de prix est le changement le moins important. Le principal changement est la disparition de l’interrupteur du thinking. Avec l’adaptive thinking, le modèle décide lui-même combien de temps consacrer au raisonnement avant de répondre. Ces tokens de raisonnement sont facturés comme des tokens de sortie, même si l’API ne vous les affiche pas. Sur Opus 5.5, ce mode est toujours actif. Le seul contrôle restant est effort, un paramètre de requête proposant cinq niveaux de low à max, qui limite le budget de réflexion du modèle.
Opus 5 acceptait thinking: {"type": "disabled"}. Dans nos mesures d’Opus 5, c’était le seul réglage qui ramenait son coût au niveau d’Opus 4.8. Ce levier n’existe plus.
| Opus 5 | Opus 5.5 | |
|---|---|---|
| Tarif catalogue (entrée / sortie par MTok) | $5 / $25 | $4 / $20 |
| Thinking | adaptatif, désactivable avec un effort high ou inférieur | adaptatif, toujours actif |
| Effort par défaut | high | medium |
| Utilisation forcée d’un outil | acceptée | erreur 400 (mesurée) |
| Fenêtre de contexte / sortie maximale | 1M / 128K | 1M / 128K |
| Knowledge cutoff | mai 2026 | juin 2026 |
| Sortie | 2026-07-24 | 2026-09-22 |
| Texte entre les appels d’outil | blocs text | blocs thinking, vides avec le réglage d’affichage par défaut |
| Catégories de protection | cybersécurité | cybersécurité et biologie, plus un refus lié à l’extraction du raisonnement |
Deux lignes ont des conséquences qui dépassent ce tableau. L’effort par défaut baisse d’un cran, de high à medium. Une requête qui n’envoie aucun paramètre d’effort ne s’exécute donc pas avec la même profondeur que sur Opus 5. Le changement concernant les messages de progression est silencieux : les courtes notes auparavant produites entre les appels d’outil arrivent maintenant sous forme de blocs de thinking dont le texte reste vide sauf demande explicite. Une interface utilisateur qui diffusait ces notes en streaming devient muette, sans erreur à intercepter.
Que disent les benchmarks de lancement ?
Dans le tableau publié par Anthropic, Opus 5.5 devance Fable 5.1 sur tous les benchmarks de programmation et de travail intellectuel. Il devance aussi GPT-6 Astra sur la plupart d’entre eux. Les résultats ci-dessous viennent d’Anthropic. Ils ont été obtenus avec l’adaptive thinking et l’effort maximal, sauf les lignes Terminal-Bench exécutées en xhigh.
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra |
|---|---|---|---|---|
| Terminal-Bench 4.0 (programmation agentique) | 66.4% | 55.8% | 52.3% | 57.9% |
| FrontierCode v1.1 | 54.4% | 50.3% | 48.0% | 53.3% |
| CursorBench 4.0 | 57.8% | 51.8% | 46.6% | non communiqué |
| GDPval-AA v2.1 (travail intellectuel, Elo) | 1846 | 1735 | 1708 | 1542 |
| AutomationBench (workflows métier) | 40.0% | 31.4% | 26.9% | 41.4% |
| Terminal-Bench-Science 0.1 | 58.7% | 52.6% | 29.0% | 64.6% |
| OSWorld 2.0 (utilisation d’un ordinateur) | 81.8% | 80.7% | 74.0% | non communiqué |
Anthropic ajoute une réserve inhabituelle à son propre tableau : à ce niveau, « les écarts entre benchmarks sont devenus moins fiables pour estimer les différences en conditions réelles ». En pratique, l’écart avec Fable 5.1 serait donc plus faible que ne le suggèrent les scores. Deux notes doivent être prises en compte avant de citer ces chiffres. Zapier a exécuté AutomationBench sans modèle de fallback, si bien que chaque intervention des protections a été comptée comme un échec. Par ailleurs, l’ensemble du tableau a été produit avec les protections de production actives. Lorsqu’un classifieur intervenait, les tâches de cybersécurité étaient confiées à Opus 4.8 et les tâches de biologie à Opus 5.
Ces résultats ne disent rien du coût d’une tâche. Nous l’avons donc mesuré.
Le modèle est-il vraiment moins cher en single-shot ?
Oui, et l’essentiel de l’écart vient d’un réel gain d’efficacité, pas de la grille tarifaire. Single-shot signifie une requête, une réponse et aucun outil. Notre jeu de test comprend des problèmes d’arithmétique et de comptage, comme une règle d’itération en 200 étapes ou le calcul du nombre de chemins dans une grille contenant des cellules bloquées. Nous avons exécuté 13 tâches, avec 3 répétitions chacune, aux cinq niveaux d’effort ainsi qu’avec le réglage par défaut, sur Opus 5.5 et Opus 5. Cela représente 468 appels évalués. Toutes les réponses attendues ont été calculées en force brute avec Python avant l’exécution. Chaque prompt contenait aussi une chaîne aléatoire unique afin qu’aucune couche entre le modèle et nous ne puisse répondre depuis une copie en cache. Le coût par tâche est calculé à partir des tarifs catalogue d’Anthropic et des tokens facturés par chaque appel, thinking compris, plutôt que lu dans la réponse.
| Effort | Sortie médiane d’Opus 5.5 | Opus 5.5 $/tâche | Sortie médiane d’Opus 5 | Opus 5 $/tâche |
|---|---|---|---|---|
| par défaut | 193 | 0.0072 | 448 | 0.0204 |
| low | 185 | 0.0060 | 439 | 0.0201 |
| medium | 218 | 0.0085 | 538 | 0.0200 |
| high | 223 | 0.0094 | 542 | 0.0206 |
| xhigh | 233 | 0.0111 | 525 | 0.0197 |
| max | 762 | 0.0240 | 532 | 0.0220 |
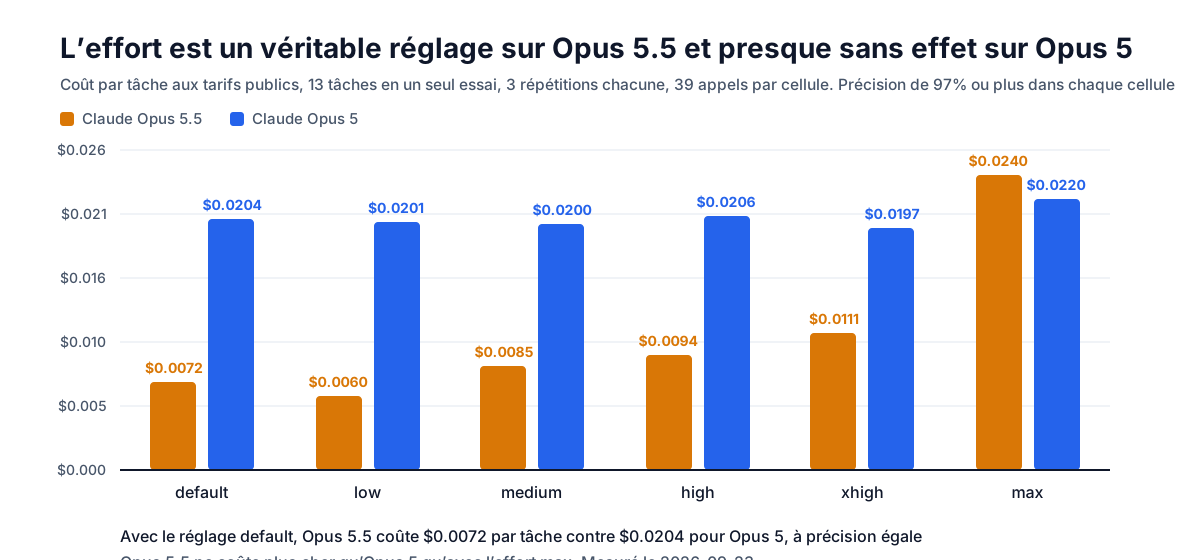
Avec le réglage par défaut, les deux modèles atteignent 100% de précision. Tous les autres niveaux restent à 97% ou plus. Les trois erreurs sont réparties entre différentes tâches et différents niveaux, au lieu de se concentrer en bas de l’échelle. Ce jeu de tâches ne présente aucune chute brutale de précision. Toute la différence se situe donc au niveau du coût.
L’échelle d’effort se comporte différemment sur les deux modèles. Le coût d’Opus 5 reste stable, de $0.0197 à $0.0220 entre low et max, soit une variation de 12%. Celui d’Opus 5.5 varie d’un facteur 4x, de $0.0060 à $0.0240. L’effort est un vrai réglage sur Opus 5.5, alors qu’il est presque sans effet sur Opus 5. Une migration qui reprend le même réglage peut donc aboutir très loin du point de départ.
L’écart augmente sur les cinq tâches les plus difficiles. Avec son réglage par défaut, Opus 5.5 a coûté $0.0113 par tâche, contre $0.0375 pour Opus 5. La sortie médiane était de 585 tokens contre 1,145.
Que se passe-t-il dans une boucle d’outils, quand les coûts agentiques s’accumulent ?
L’économie reste présente dans une boucle, mais l’écart se resserre. Une boucle d’outils constitue le test le plus réaliste entre Opus 5.5 et Opus 5. Un tour correspond à une requête : le modèle demande un outil, votre code l’exécute, puis vous renvoyez l’intégralité de la conversation. Une conversation de cinq tours paie donc cinq fois pour un transcript qui s’allonge. Le nombre de tours, et non le prix par token, détermine le coût. Nous avons fourni aux deux modèles trois outils permettant de lister les fichiers, de lire un fichier et d’effectuer une recherche dans un petit service synthétique. Les quatre questions exigeaient de suivre une chaîne d’appels à travers trois ou quatre fichiers. Nous avons ensuite lancé 12 exécutions par configuration sur la même interface, avec les mêmes outils et le même prompt.
| Configuration | Résultats corrects | Tours médians | Appels d’outil médians | Tokens de sortie médians | $/exécution |
|---|---|---|---|---|---|
| Opus 5.5, par défaut | 12/12 | 4 | 5 | 427 | 0.0326 |
Opus 5.5, low | 12/12 | 4.5 | 5 | 430 | 0.0330 |
Opus 5.5, max | 12/12 | 5 | 12 | 3,124 | 0.1087 |
| Opus 5, par défaut | 11/12 | 5 | 7 | 666 | 0.0519 |
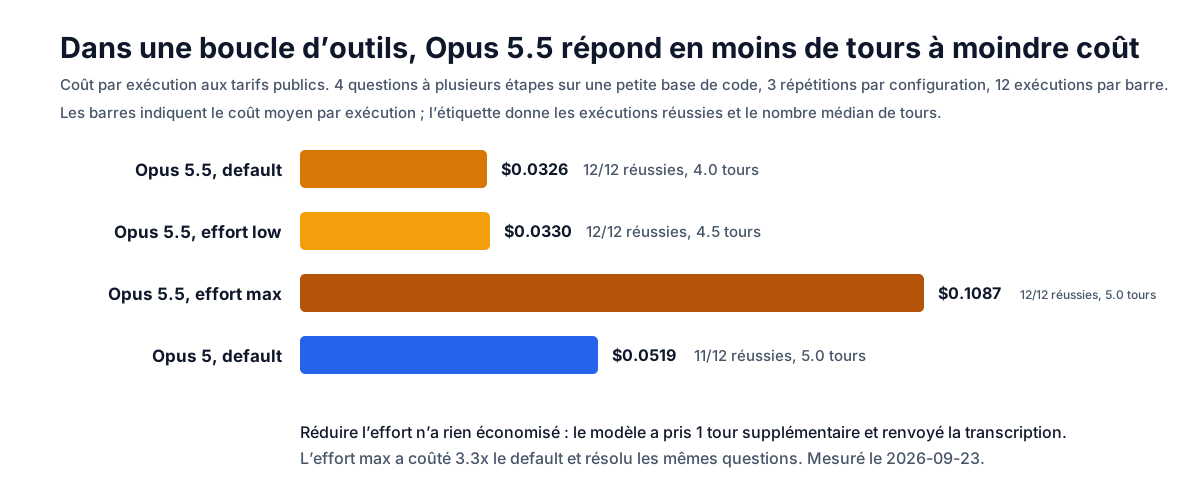
Avec le réglage par défaut, Opus 5.5 coûte 37% de moins par exécution qu’Opus 5, avec 12% de tours en moins et 30% de tokens de sortie en moins. L’écart par question résolue atteint 43%, car Opus 5 a échoué sur une exécution. Ce résultat est proche des « 40% de moins à l’exécution » annoncés par le fournisseur. C’est aussi le chiffre qui apparaît sur la facture.
Sur ce workload, la grille tarifaire produit l’essentiel de l’économie. La raison est simple : une boucle renvoie tout le transcript à chaque tour, les deux modèles lisent les mêmes fichiers, et le nombre total de tokens ne baisse que de 19%, contre 30% pour les tokens de sortie. Réduire la sortie aide donc le moins là où la dépense est la plus élevée. La section suivante chiffre cet effet.
Passer Opus 5.5 à low n’apporte aucune économie dans la boucle. Le modèle demande en moyenne un tour supplémentaire, et le renvoi du transcript annule la baisse du nombre de tokens. Le réglage d’effort, efficace sur les tâches single-shot, ne réduit plus la facture dans une boucle. Le coût dépend du nombre de tours, pas de la profondeur du raisonnement.
Quelle part de l’économie vient uniquement de la baisse de prix ?
Entre un septième et deux cinquièmes, selon la forme du workload. La colonne centrale recalcule le coût des tokens mesurés pour Opus 5.5 avec les tarifs d’Opus 5. Elle montre donc ce qu’économise Opus 5.5 en produisant moins de texte, à grille tarifaire identique à celle d’Opus 5.
| Workload | Écart facturé | À prix identique | Tokens de sortie |
|---|---|---|---|
| 13 tâches single-shot, par défaut | -65% | -56% | -57% |
| cinq tâches les plus difficiles | -70% | -62% | -63% |
| boucle d’outils multi-hop, par défaut | -37% | -22% | -30% |
Les lignes single-shot correspondent à un vrai gain d’efficacité. La baisse de prix ne représente que 14% de l’économie, le reste venant d’une sortie plus courte. La ligne de la boucle d’outils est celle à utiliser pour la planification, car elle correspond à la forme de la plupart des trafics agentiques. Dans ce cas, la baisse de prix représente 41% du gain annoncé.
Un niveau d’effort plus élevé est-il parfois rentable ?
Pas sur ce workload, et le surcoût est élevé. Dans la boucle d’outils, Opus 5.5 avec max a coûté $0.1087 par exécution, soit 3.3x son propre réglage par défaut, pour résoudre exactement les mêmes 12 questions. Le budget supplémentaire est parti dans les appels d’outil : une médiane de 12 contre 5 par défaut, avec 3,124 tokens de sortie contre 427. Sur les tâches single-shot, max est le seul niveau auquel il coûte plus cher qu’Opus 5, soit $0.0240 contre $0.0220.
Ce budget est consacré au raisonnement. Sur ces tâches à réponse unique, le thinking représente 98.4% des tokens de sortie d’Opus 5.5 par défaut et 99.6% avec max. Tous ces tokens sont facturés au tarif de sortie, même si le réglage d’affichage par défaut ne vous les montre jamais. Anthropic recommande de réserver max aux problèmes situés à la frontière des capacités du modèle. Nos mesures donnent une règle simple : sur une tâche que le modèle sait déjà résoudre, chaque niveau supplémentaire ne fait qu’augmenter le coût.
Qu’est-ce qui casse quand on change l’ID du modèle ?
Deux formats de requête acceptés par Opus 5 renvoient une erreur 400 avec Opus 5.5. Les deux sont courants dans du code existant.
L’utilisation forcée d’un outil est refusée. Tout client qui impose un appel d’outil, une technique courante pour obtenir du JSON structuré depuis un modèle de chat, reçoit cette erreur :
tool_choice: type "tool" and "any" are not supported for this model.La même erreur est renvoyée via un client compatible OpenAI, où la requête utilise tool_choice: "required" ou une fonction nommée. auto et none fonctionnent toujours. Pour migrer, indiquez explicitement dans le prompt quand l’outil doit être utilisé, puis employez des schémas d’outil stricts ou des sorties structurées pour obtenir un JSON conforme au schéma.
Le thinking ne peut plus être désactivé. thinking: {"type": "disabled"} et un budget_tokens manuel échouent tous les deux. Sur une interface compatible OpenAI, l’équivalent reasoning_effort: "none" est également refusé. Il faut désormais utiliser le paramètre d’effort :
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=4096,
    messages=[{"role": "user", "content": "Summarize this incident report in five bullets."}],
    output_config={"effort": "low"},   # low | medium | high | xhigh | max; medium is the default
)

# Thinking is billed as output whether or not you can read it.
print(response.usage.input_tokens, response.usage.output_tokens)
low est le réglage qui se rapproche le plus de l’ancien mode sans thinking. Dans notre jeu de tâches single-shot, c’est aussi le moins cher, sans perte de précision. Le thinking reste toutefois actif et ses tokens sont toujours facturés comme sortie.
Les budgets de prompt restent-ils valables ?
Les budgets en tokens restent strictement identiques. Les quatre entrées produisent les mêmes comptages sur les deux modèles : 1,277 tokens contre 1,275 pour un texte en anglais, 583 contre 581 pour du Python, 482 contre 480 pour un objet JSON contenant les arguments d’un outil, et 500 contre 498 pour un texte en chinois. L’écart constant de deux tokens vient du framing de la requête, pas du texte. Un budget de contexte ou un seuil de découpage ajusté sur Opus 5 n’a donc pas besoin d’être recalibré pour Opus 5.5.
Quand faut-il migrer ?
Pour réduire les coûts, passez à Opus 5.5 dès que les deux formats de requête décrits plus haut sont corrigés. Même en neutralisant la baisse de prix, obtenir la même précision pour 56% de moins sur les tâches single-shot et 22% de moins dans une boucle d’outils représente un écart conséquent. La comparaison entre les réglages par défaut est aussi celle que la plupart des déploiements rencontreront réellement.
L’effort doit être recalibré, pas repris tel quel. Le niveau par défaut passe de high à medium, et la plage du réglage est quatre fois plus large que sur Opus 5. Le meilleur niveau dépend du workload : low était le moins cher tout en restant précis sur les tâches single-shot, tandis que le réglage par défaut battait low et max dans la boucle d’outils.
FAQ
Claude Opus 5.5 est-il vraiment 40% moins cher qu’Opus 5 ? Sur la facture, le résultat est proche : Opus 5.5 coûte 37% de moins par exécution qu’Opus 5 dans notre boucle d’outils et 65% de moins par tâche single-shot. Vingt points de cet écart viennent de la baisse du tarif, indépendamment du comportement du modèle. Une fois cet effet retiré, le gain d’efficacité est de 22% dans la boucle et de 56% sur les tâches single-shot.
Puis-je encore désactiver le thinking sur Opus 5.5 ?
Non. thinking: {"type": "disabled"} et les budgets manuels de tokens renvoient tous deux une erreur 400 sur Opus 5.5. Utilisez plutôt output_config.effort, dont low est le réglage le moins cher. Les tokens de thinking sont facturés comme sortie à tous les niveaux.
Par quoi remplacer l’utilisation forcée d’un outil ?
Conservez tool_choice: {"type": "auto"} et décrivez explicitement dans le prompt les conditions de déclenchement de l’outil. Utilisez ensuite des schémas d’outil stricts ou des sorties structurées lorsque vous avez besoin d’un JSON conforme au schéma. Sur Opus 5.5, les formes any et outil nommé renvoient une erreur 400 au lieu d’être dégradées silencieusement. Le problème apparaît donc comme une requête en échec, pas comme une mauvaise réponse.
Dois-je mesurer à nouveau la taille de mes prompts ? Non. Un texte identique produit les mêmes comptages de tokens sur Opus 5 et Opus 5.5 pour du texte, du code, du JSON et du chinois. Les budgets de contexte restent donc inchangés.
Opus 5.5 remplace-t-il Fable 5.1 ? Dans le tableau de benchmarks d’Anthropic, Opus 5.5 devance Fable 5.1 sur tous les benchmarks présentés, avec un prix par token égal à 40% de celui de Fable 5.1. Anthropic continue pourtant de positionner Fable 5.1 pour le raisonnement exigeant et les tâches agentiques de longue durée. L’entreprise précise aussi que l’écart réel est plus faible que ne le suggèrent les scores. La bonne réponse consiste donc à relancer vos propres evals plutôt qu’à vous fier au tableau.
Mesures associées : Claude Opus 5 vs Opus 4.8, l’échelle d’effort de GPT-6 Astra et les contrôles du thinking selon les fournisseurs.
Mesures effectuées le 2026-09-23, un jour après la sortie, via une gateway vers l’API Claude et une interface compatible OpenAI. Le test comprend 468 appels single-shot évalués (13 tâches avec réponses calculées localement en force brute, 3 répétitions, 6 niveaux d’effort et 2 modèles), plus 48 exécutions de boucles d’outils (4 questions multi-hop, 3 répétitions et 4 configurations). Un sel aléatoire a été ajouté aux prompts. Chaque modèle a été appelé via l’interface exposant son paramètre d’effort. Les coûts ont été calculés à partir des tarifs catalogue d’Anthropic plutôt que lus dans les réponses.