
GPT Image 2.5 Flare vs GPT Image 2.6 Flare
Cuál usar y cuándo
Las tarifas sin caché de texto, imagen de referencia y salida son iguales. Prueba gpt-image-2.6-flare si necesitas complexity y compara el consumo real antes de migrar desde gpt-image-2.5-flare.
Precios
| GPT Image 2.5 Flare | GPT Image 2.6 Flare | Δ | |
|---|---|---|---|
| Entrada / 1M tokens | $5 | $5 | = |
| Salida / 1M tokens | $30 | $30 | = |
| Tokens de imagen de referencia / millón | $8 | $8 | = |
| Lectura de caché / 1M tokens | - | $1.25 | - |
| Tokens de imagen de referencia en caché / millón | - | $2 | - |
Tarifas tomadas del catálogo en vivo al generar el sitio; la página de cada modelo tiene la ficha de precios actualizada.
Dónde queda cada uno: precio de salida por 1M de tokens entre los 15 modelos de generación de imágenes que se facturan en esta unidad (escala logarítmica)
Especificaciones
| GPT Image 2.5 Flare | GPT Image 2.6 Flare | |
|---|---|---|
| Modalidades de entrada | texto imagen | texto imagen |
| Modalidades de salida | imagen | imagen |
| Lanzamiento | 2026-09-08 | 2026-11-04 |
| Tamaños de salida |
|
|
| Modos de entrada | Generación a partir de texto y edición con imágenes de referencia | Generación a partir de texto y edición con imágenes de referencia |
| Imágenes por solicitud | 4 | 4 |
| Formatos | png, jpeg, webp | png, jpeg, webp, gif, svg |
| Notas | El ancho y el alto personalizados deben ser múltiplos de 16 y la relación de aspecto debe estar entre 1:3 y 3:1. quality añade xhigh y max por encima de high. En Synthorai, envía la imagen de referencia en base64 en el campo image de una solicitud JSON a /v1/images/generations. | El ancho y el alto personalizados deben ser múltiplos de 16 y la relación de aspecto debe estar entre 1:3 y 3:1. En Synthorai, envía la imagen de referencia en base64 en el campo image de una solicitud JSON a /v1/images/generations. Ajusta complexity a low, medium o high independientemente de quality. |
Las especificaciones se transcriben de la documentación de cada proveedor; si un proveedor no publica un dato, la fila se omite en vez de deducirlo. Fuentes completas: GPT Image 2.5 Flare · GPT Image 2.6 Flare
Un mismo prompt en los dos modelos, medido a través de la pasarela
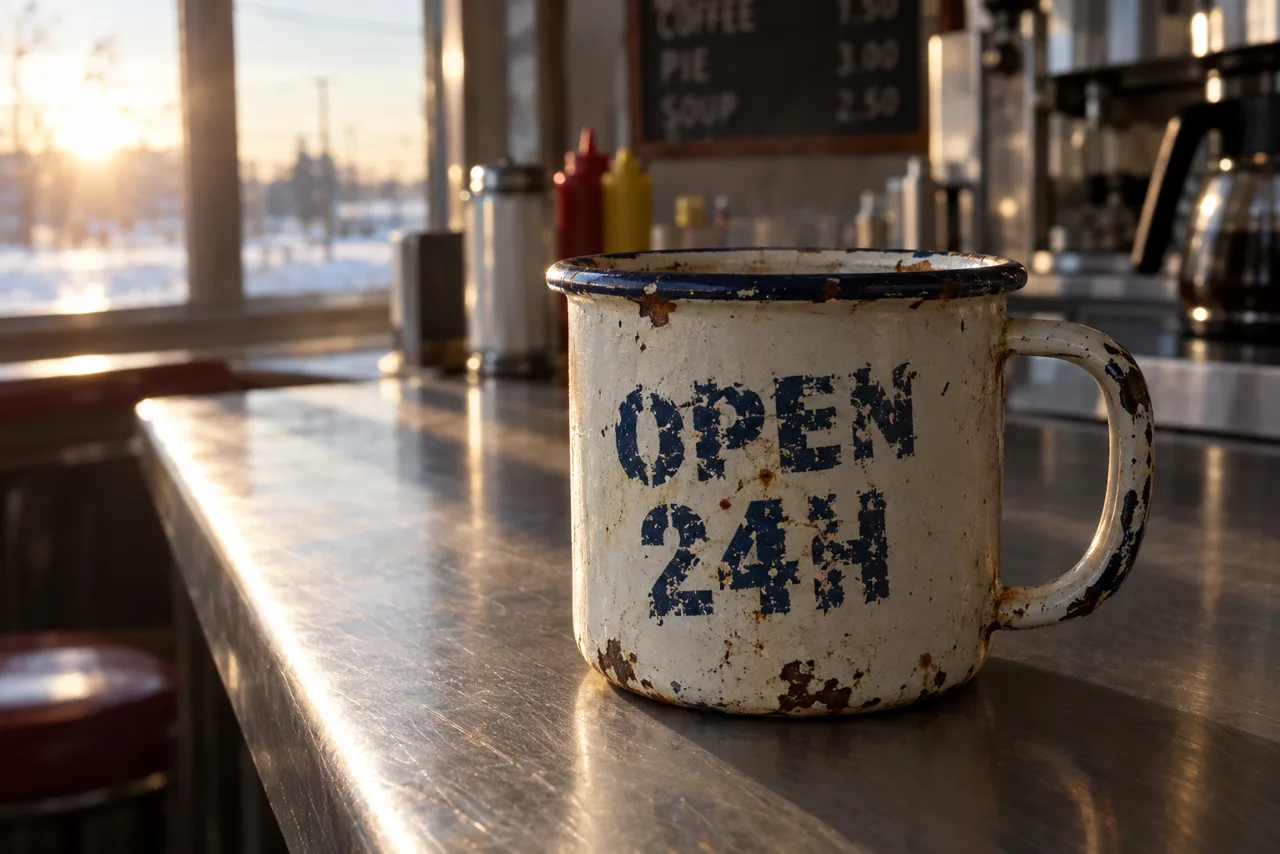
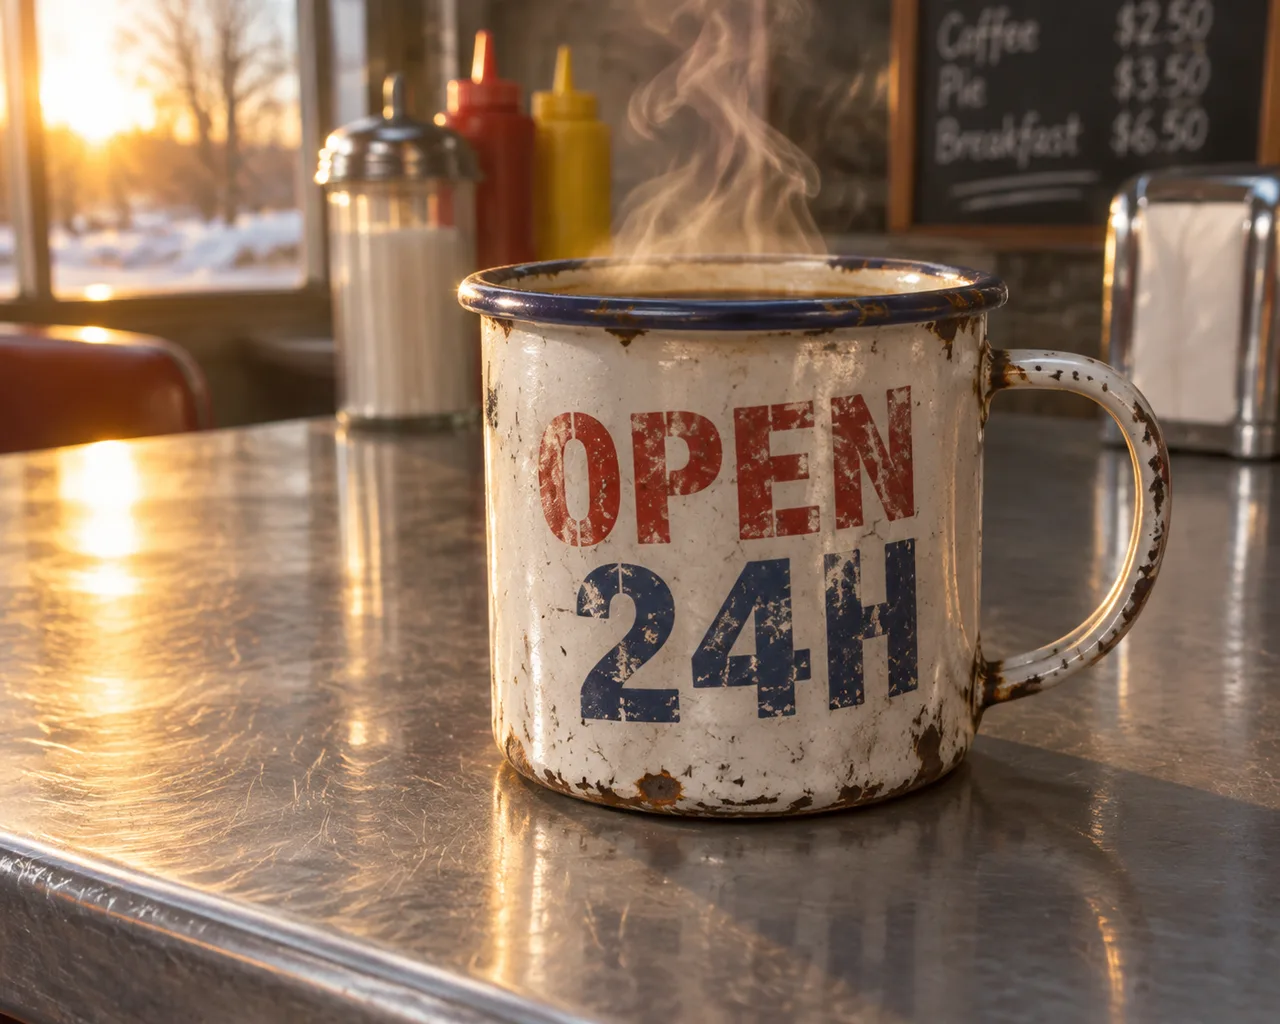
Un prompt y una solicitud por modelo, sin reintentos y sin escoger el mejor resultado: lo que ves es lo primero que devolvió cada modelo. No fijamos ni el tamaño ni la duración; cada modelo usó sus valores por defecto, porque una solicitud hecha a la medida de todos no dejaría en buen lugar a ninguno. Los archivos se han recodificado para la web, así que fíjate en la composición y en la fidelidad al prompt, no en la compresión.
Cambia de uno a otro con una sola línea
Los dos ids aparecen en todas las pestañas de abajo; lo único que cambia es el par de líneas resaltadas. El endpoint, la clave y la estructura de la solicitud son los mismos.
from openai import OpenAI

client = OpenAI(
    base_url="https://synthorai.io/v1",
    api_key="sk-syn-...",
)

resp = client.images.generate(
    model="gpt-image-2.5-flare",
    # model="gpt-image-2.6-flare",  # descomenta esta línea, comenta la de arriba
    prompt="a watercolor lighthouse at dawn",
    size="1024x1024",
)
print(resp.data[0].b64_json[:80])
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://synthorai.io/v1",
apiKey: "sk-syn-...",
});
const resp = await client.images.generate({
model: "gpt-image-2.5-flare",
// model: "gpt-image-2.6-flare", // descomenta esta línea, comenta la de arriba
prompt: "a watercolor lighthouse at dawn",
size: "1024x1024",
});
console.log(resp.data?.[0]?.b64_json?.slice(0, 80));curl https://synthorai.io/v1/images/generations \
-H "Authorization: Bearer sk-syn-..." \
-H "Content-Type: application/json" \
-d '{
"model": "gpt-image-2.5-flare",
# "model": "gpt-image-2.6-flare", # descomenta esta línea, comenta la de arriba
"prompt": "a watercolor lighthouse at dawn",
"size": "1024x1024"
}'package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/option"
)
func main() {
client := openai.NewClient(
option.WithBaseURL("https://synthorai.io/v1"),
option.WithAPIKey("sk-syn-..."),
)
resp, _ := client.Images.Generate(context.TODO(), openai.ImageGenerateParams{
Model: "gpt-image-2.5-flare",
// Model: "gpt-image-2.6-flare", // descomenta esta línea, comenta la de arriba
Prompt: "a watercolor lighthouse at dawn",
Size: "1024x1024",
})
fmt.Println(resp.Data[0].B64JSON[:80])
}import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.images.*;
OpenAIClient client = OpenAIOkHttpClient.builder()
.baseUrl("https://synthorai.io/v1")
.apiKey("sk-syn-...")
.build();
ImagesResponse resp = client.images().generate(
ImageGenerateParams.builder()
.model("gpt-image-2.5-flare")
// .model("gpt-image-2.6-flare") // descomenta esta línea, comenta la de arriba
.prompt("a watercolor lighthouse at dawn")
.size("1024x1024")
.build());
System.out.println(resp.data().orElseThrow().get(0).b64Json().orElseThrow().substring(0, 80));Preguntas frecuentes
¿Cuál es más barato, GPT Image 2.5 Flare o GPT Image 2.6 Flare?
Ambos cobran $5 en «Entrada / 1M tokens». Otras tarifas y la cantidad de unidades consumidas pueden cambiar el coste total.
¿Puedo hacer pruebas A/B de GPT Image 2.5 Flare frente a GPT Image 2.6 Flare sin dos integraciones?
Sí. Los dos se sirven desde el mismo endpoint compatible con OpenAI y con una sola clave API. Para cambiar de uno a otro basta con tocar una línea, el nombre del modelo, así que puedes mandar una parte del tráfico a cada uno y comparar directamente las facturas.
¿Cambia el precio con el tamaño de la imagen?
Depende de cómo se facture el modelo. Los que cobran por imagen cuestan lo mismo sea cual sea el prompt o el tamaño de salida; en los que se facturan por tokens, el precio sube con la resolución que generes, así que una imagen 4K cuesta varias veces lo que una pequeña. La tabla de arriba indica qué caso es el de cada modelo.