
GPT Image 2.6 Sunburst vs Flare vs GPT Image 2 al editar
Contenido
- ¿Qué cambió en GPT Image 2.6?
- ¿Cómo se comparan GPT Image 2, 2.5 y 2.6 en Arena?
- ¿Cómo resolvieron GPT Image 2, Sunburst y Flare las mismas ediciones?
- ¿Cuánto tardaron los tres modelos en devolver el programa editado?
- ¿La complejidad alta mejoró la edición del programa?
- ¿Cuándo ayuda el marcado a GPT Image 2.6 a elegir el objeto correcto?
- ¿Cómo probamos las ediciones?
- Preguntas frecuentes
- ¿La comparación con GPT Image 2 utiliza el mismo esfuerzo de planificación?
- ¿Probasteis GPT Image 2.5 a través de Synthorai?
- ¿Cuándo conviene usar marcado para editar una imagen?
- ¿La complejidad alta hizo más fiables las ediciones del programa?
GPT Image 2 y las dos variantes de GPT Image 2.6 actualizaron tres campos de una misma etiqueta alimentaria sin alterar el texto circundante. Al editar un programa de conferencias, Sunburst superó 2/4 generaciones con complejidad media. Flare con complejidad media y GPT Image 2 con su planificación predeterminada obtuvieron 0/4. La tarea consistía en intercambiar dos charlas y hacer que la insignia FULL siguiera a una de ellas.
TL;DR
- GPT Image 2 y las dos variantes 2.6 superaron la misma edición de una etiqueta alimentaria.
- En el programa, Sunburst logró 2/4 con complejidad media. GPT Image 2 y Flare obtuvieron 0/4.
- Sunburst superó 2/4 generaciones del programa con
complexitymedia y alta. Flare intercambió ambas charlas en 0/4 generaciones con complejidad media y 2/4 con complejidad alta, pero no superó ninguna por completo en ambos ajustes. - Una indicación visual aumentó la selección correcta del objetivo de 1/4 a 4/4 cuando el texto no especificaba su ubicación.
¿Qué cambió en GPT Image 2.6?
OpenAI lanzó Images 2.6 el 4 de noviembre de 2026. Sunburst está orientado a trabajos detallados y a mantener la coherencia entre ediciones, mientras que Flare prioriza iteraciones más rápidas. La versión también añadió anotaciones visuales a la API, un control de planificación y opciones de salida GIF y SVG. Notas de la versión de OpenAI
El ajuste complexity controla la planificación previa a la generación. El ajuste independiente quality controla el nivel de detalle del resultado. OpenAI documenta tres niveles de planificación, low, medium y high, y usa high como valor predeterminado en su API. En las solicitudes a 2.6 especificamos ambos parámetros. Guía de generación de imágenes de OpenAI
¿Cómo se comparan GPT Image 2, 2.5 y 2.6 en Arena?
Los datos de GPT Image 2.5 proceden exclusivamente de la clasificación pública de Arena para la edición de una sola imagen. En la captura del 12 de noviembre de 2026, las dos entradas 2.5 mostraban puntuaciones superiores a las entradas 2.6 Medium de la lista. Las puntuaciones de Arena reflejan las preferencias de los votantes. Las entradas tienen distintos números de votos y etiquetas de configuración. Las puntuaciones siguientes mantienen la incertidumbre que muestra Arena. Clasificación de edición de una sola imagen de Arena
| Entrada de Arena | Puntuación mostrada | Votos |
|---|---|---|
| GPT Image 2.5 Sunburst | 1519 ± 5 | 131,648 |
| GPT Image 2.5 Flare | 1484 ± 4 | 128,720 |
| GPT Image 2.6 Sunburst (Medium) | 1476 ± 11 | 3,493 |
| GPT Image 2 (Medium) | 1462 ± 3 | 364,695 |
| GPT Image 2.6 Flare (Medium) | 1460 ± 10 | 3,534 |
“Medium” es la etiqueta que utiliza Arena para esa entrada. En nuestra prueba a través del gateway, la solicitud a GPT Image 2 omitió el campo complexity.
¿Cómo resolvieron GPT Image 2, Sunburst y Flare las mismas ediciones?
Los tres modelos superaron la edición de la etiqueta alimentaria. GPT Image 2 y las dos variantes 2.6 cambiaron correctamente el valor de sodio, el código de lote y el peso neto. Ninguno alteró el texto circundante. Sunburst y Flare también superaron las seis ediciones sencillas. Además, conservaron los detalles adyacentes en las tareas de la tapa de botella y la insignia de referencia cuando recibieron una ubicación clara.
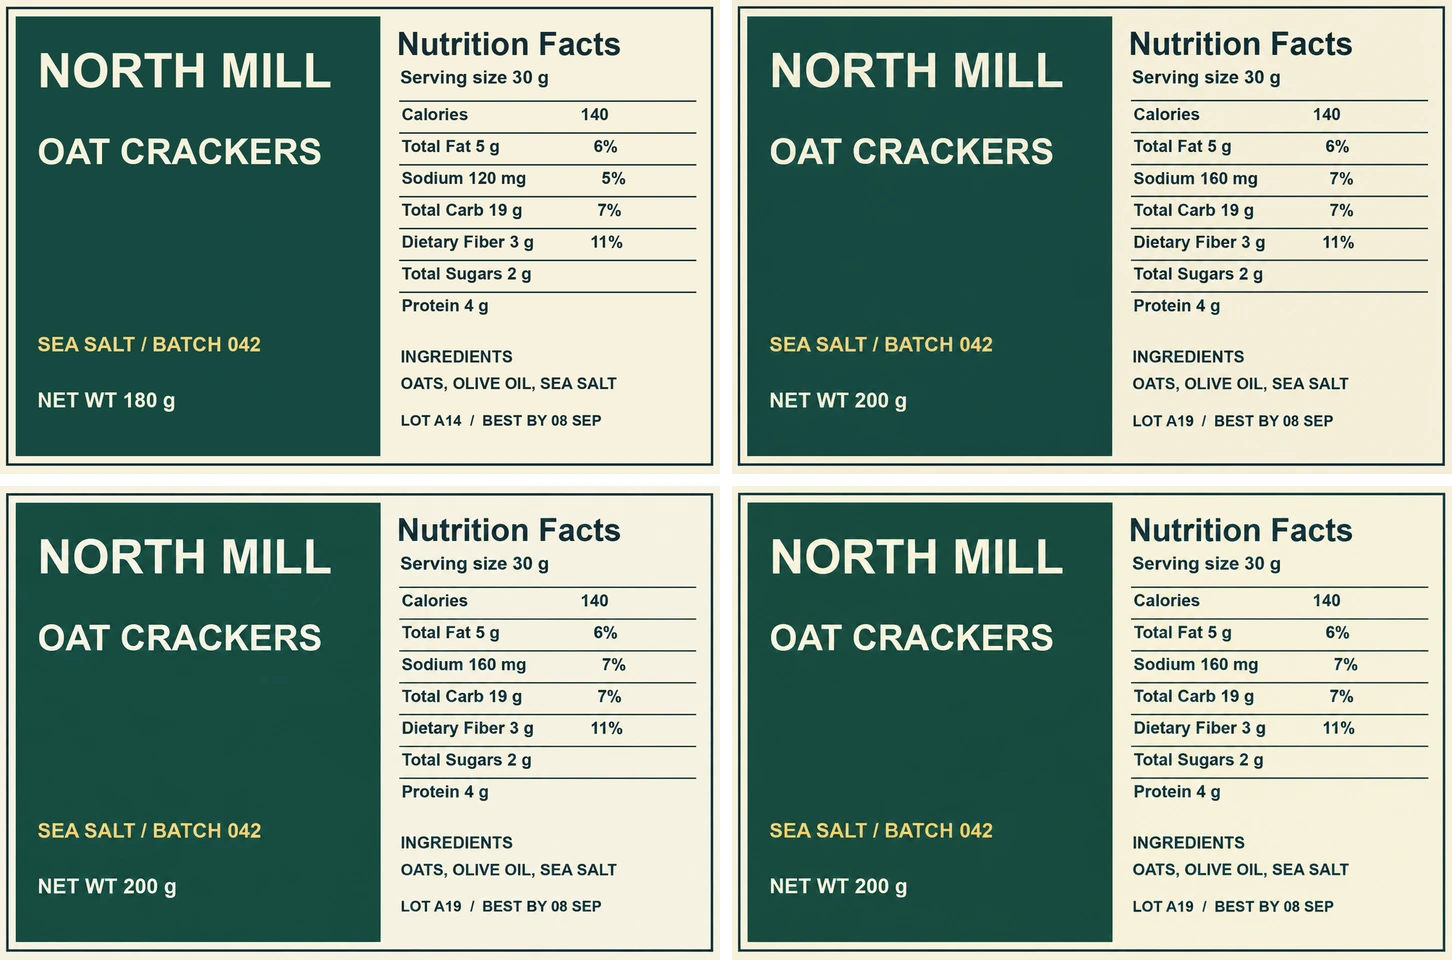
Fila superior: original y GPT Image 2. Fila inferior: Sunburst y Flare. GPT Image 2 utiliza la planificación predeterminada, y las dos variantes 2.6 usan complejidad media.
Para la prueba del programa, pedimos a cada modelo que intercambiara los títulos y ponentes de Studio B a las 10:00 y Studio C a las 11:30. Después debía añadir FULL a Sound Lab en su nueva franja. GPT Image 2 dejó sistemáticamente Sound Lab en su franja original e intercambió otras dos charlas. Sunburst movió correctamente las dos charlas solicitadas en las cuatro generaciones con complejidad media. En dos de ellas, la insignia permaneció en la franja anterior.
| Modelo | Ajuste de planificación | Etiqueta alimentaria, resultado completo | Programa, ambas charlas en las franjas correctas | Programa, resultado completo |
|---|---|---|---|---|
| GPT Image 2 | Predeterminado, campo omitido | 1/1 | 0/4 | 0/4 |
| GPT Image 2.6 Sunburst | Media | 1/1 | 4/4 | 2/4 |
| GPT Image 2.6 Flare | Media | 1/1 | 0/4 | 0/4 |
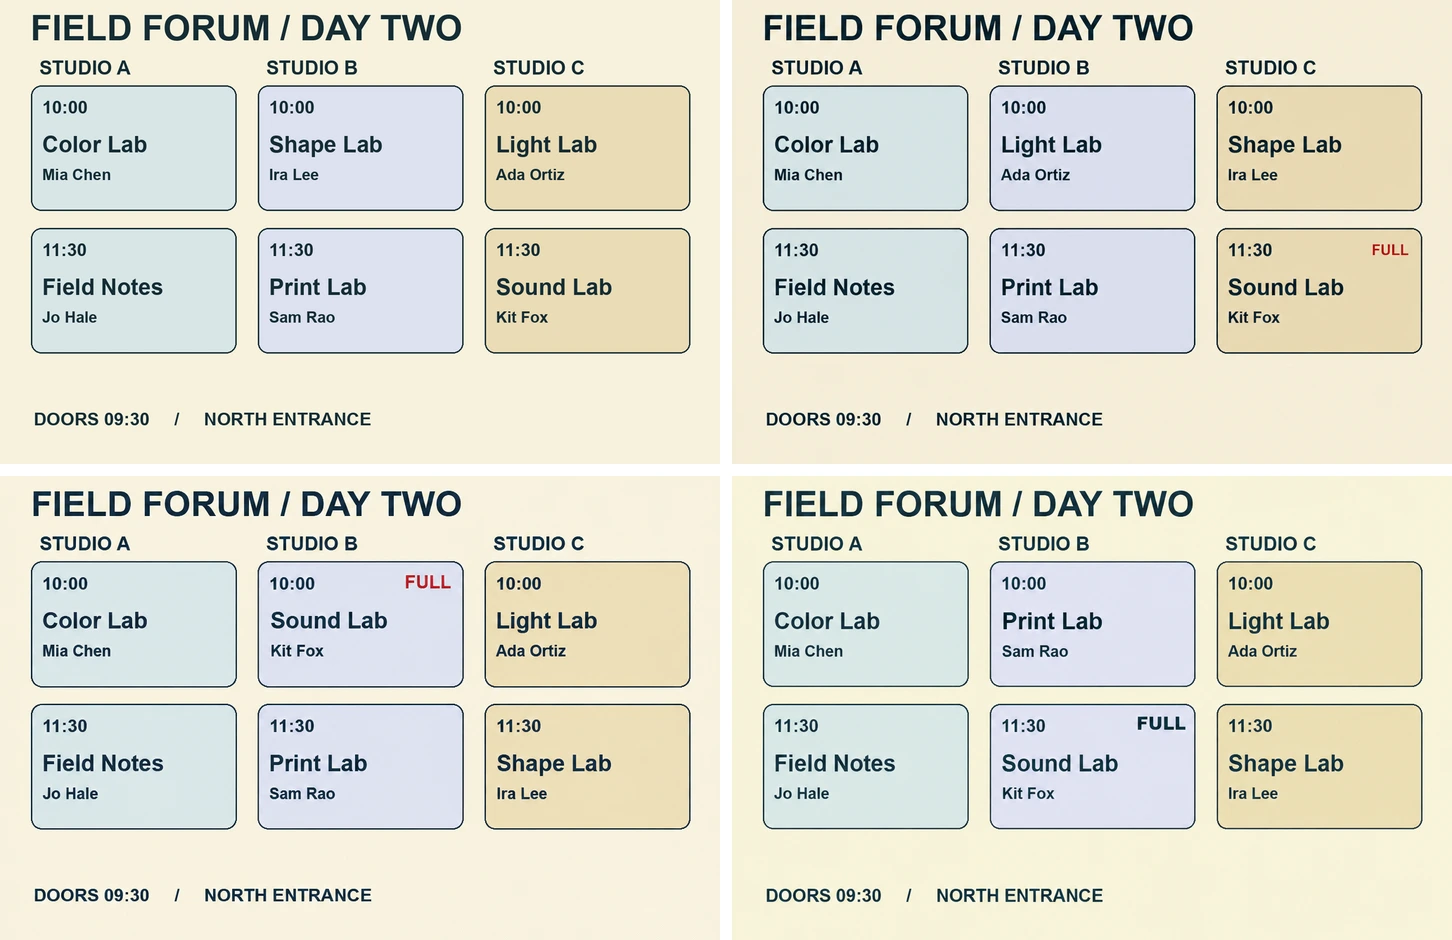
Fila superior: original y GPT Image 2. Fila inferior: una generación de Sunburst y otra de Flare. La tabla incluye las cuatro generaciones de cada modelo. GPT Image 2 utiliza la planificación predeterminada, y las dos variantes 2.6 usan complejidad media.
Los tres modelos recibieron las mismas imágenes de origen y los mismos prompts a través de Synthorai, con idéntico tamaño de salida y quality: "medium". La solicitud a GPT Image 2 omitió complexity. Para esta tabla, las dos solicitudes a 2.6 especificaron complexity: "medium". No conocemos el nivel de planificación efectivo de GPT Image 2, por lo que la tabla compara las tres configuraciones de API tal como se ejecutaron. La puntuación de cada etiqueta alimentaria corresponde a una generación. La puntuación de cada programa corresponde a cuatro intentos sobre un único diseño.
¿Cuánto tardaron los tres modelos en devolver el programa editado?
Con la misma imagen del programa y el mismo prompt, Flare devolvió una imagen en una mediana de 7.5 segundos. Sunburst tardó 18.9 segundos y GPT Image 2 27.0 segundos. Cada mediana cubre cuatro respuestas correctas de la API desde el mismo host de prueba y a través de Synthorai. Medimos desde el envío de la solicitud hasta la recepción de la respuesta completa con la imagen.
| Modelo y ajuste de planificación | Respuestas correctas | Mediana | Intervalo |
|---|---|---|---|
| GPT Image 2, predeterminado | 4 | 27.0 s | 26.0 a 47.5 s |
| GPT Image 2.6 Sunburst, media | 4 | 18.9 s | 18.3 a 21.3 s |
| GPT Image 2.6 Flare, media | 4 | 7.5 s | 7.2 a 8.0 s |
Estos tiempos representan la latencia de extremo a extremo de una edición con calidad de generación media. GPT Image 2 se ejecutó en un lote independiente y sin especificar el campo de planificación.
¿La complejidad alta mejoró la edición del programa?
Flare intercambió correctamente las dos charlas en dos generaciones con complejidad alta y en ninguna con complejidad media. Cada modelo obtuvo el mismo número de resultados completos con ambos ajustes. La edición del programa exigía mantener vinculados dos cambios. Primero había que intercambiar los títulos y ponentes de Studio B a las 10:00 y Studio C a las 11:30, sin cambiar la sala ni la hora de cada franja. Después había que añadir FULL a la tarjeta que ahora contenía Sound Lab. Una generación podía intercambiar correctamente ambas charlas y aun así colocar FULL en la posición anterior.
Eso ocurrió en el siguiente ejemplo de Sunburst. Las dos generaciones movieron Sound Lab a Studio B a las 10:00 y Shape Lab a Studio C a las 11:30. La generación con complejidad media colocó FULL en Sound Lab. La de complejidad alta lo puso en Shape Lab, en la franja donde antes estaba Sound Lab.
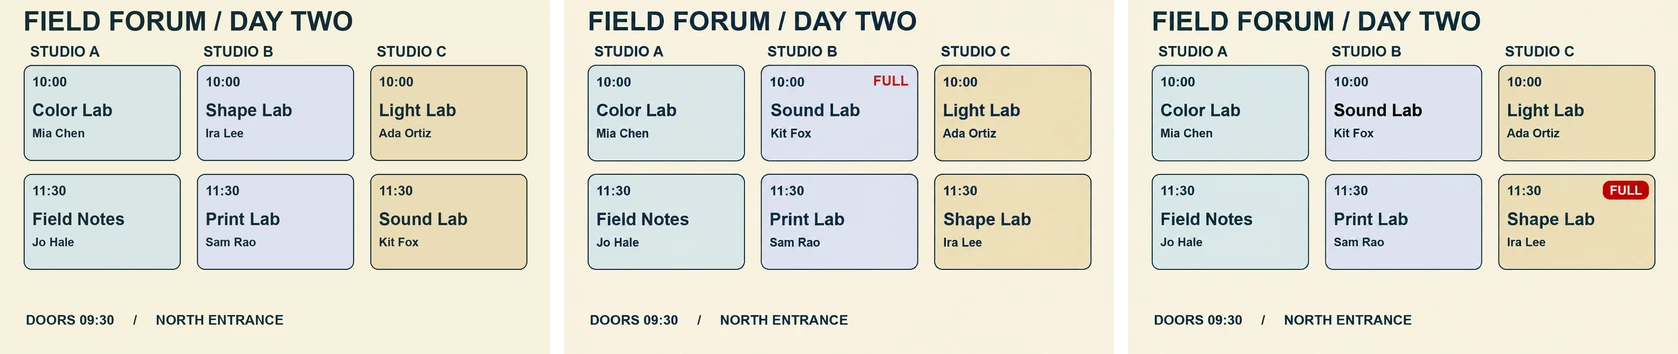
De izquierda a derecha: programa original, una generación correcta de Sunburst con complejidad media y una generación con complejidad alta que dejó la etiqueta en la franja anterior.
Las 16 generaciones utilizaron el mismo programa de origen, con cuatro resultados por modelo y ajuste de complejidad.
| Modelo | Media, ambas charlas intercambiadas correctamente | Media, resultado completo | Alta, ambas charlas intercambiadas correctamente | Alta, resultado completo |
|---|---|---|---|---|
| Sunburst | 4/4 | 2/4 | 4/4 | 2/4 |
| Flare | 0/4 | 0/4 | 2/4 | 0/4 |
Dos generaciones de Sunburst por ajuste colocaron FULL en la tarjeta equivocada. Las dos generaciones de Flare con complejidad alta que intercambiaron correctamente las charlas también colocaron mal la insignia. Solo probamos cuatro generaciones por ajuste sobre un único programa, por lo que los resultados describen esta edición concreta. Las 12 solicitudes repetidas indicaron el mismo número de tokens de entrada y salida en ambos ajustes.
En un flujo de publicación de eventos, comprueba cada franja afectada y vuelve a leer la insignia en la imagen final antes de publicarla. Si el programa procede de datos estructurados, genera el texto y la insignia a partir de esos datos para que la insignia acompañe al evento cuando cambie de franja.
¿Cuándo ayuda el marcado a GPT Image 2.6 a elegir el objeto correcto?
El marcado resultó útil cuando la imagen contenía varios objetivos igual de válidos y el texto no indicaba cuál elegir. Mostramos a GPT Image 2.6 Sunburst y GPT Image 2.6 Flare una cuadrícula con seis botellas idénticas y pedimos que cambiaran exactamente una tapa a un acabado de oro pulido. El texto fue idéntico en todas las condiciones. Indicaba al modelo que editara la tapa rodeada por un círculo si había una anotación, pero no daba ninguna posición por escrito.
Marcamos como objetivos las tapas central superior e inferior derecha. Sin la capa de marcado, cualquier coincidencia con la tapa designada era accidental. En la figura siguiente, Flare eligió la tapa central superior sin marcado. Con la capa de marcado, editó la tapa inferior derecha y mantuvo negras las otras cinco.
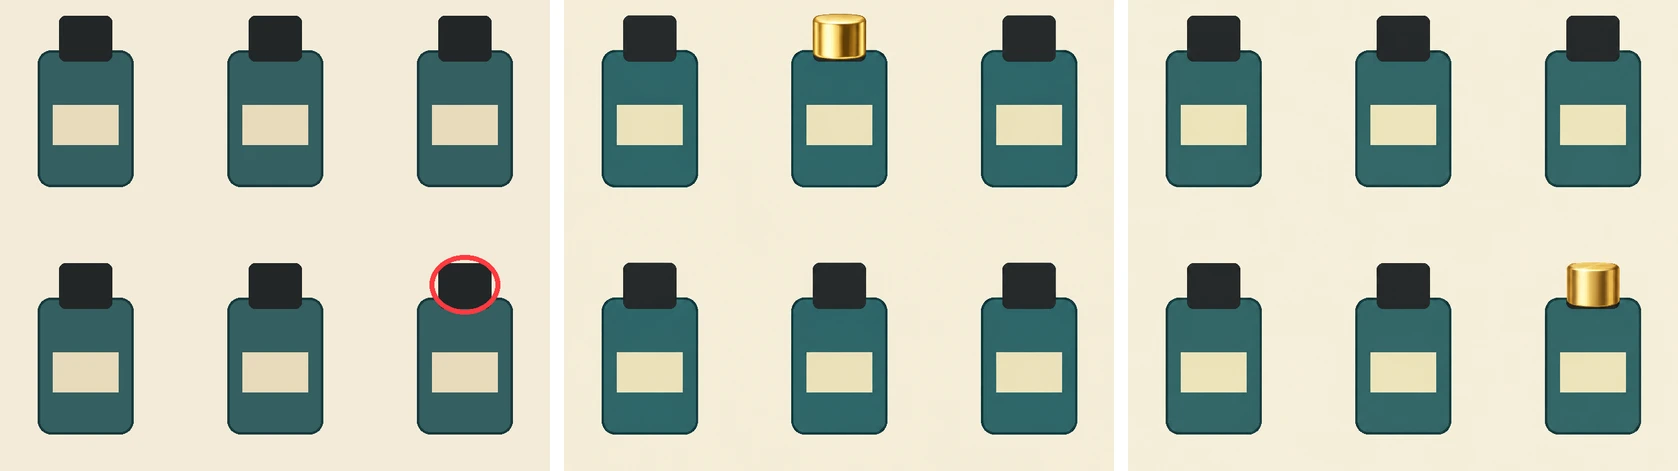
De izquierda a derecha: entrada con la capa de marcado en rojo, Flare sin marcado y Flare con marcado. La solicitud envió la imagen de origen y la capa de marcado como entradas separadas.
| Tapa designada | Sunburst sin marcado | Sunburst con marcado | Flare sin marcado | Flare con marcado |
|---|---|---|---|---|
| Central superior | Central superior | Central superior | Superior derecha | Central superior |
| Inferior derecha | Central superior | Inferior derecha | Central superior | Inferior derecha |
| Objetivos acertados | 1/2 | 2/2 | 0/2 | 2/2 |
En los ocho resultados, los modelos cambiaron una sola tapa, mantuvieron negras las otras cinco y no incluyeron el círculo en la imagen generada. La capa de marcado cambió qué tapa recibió la edición. En otras dos tareas donde el texto ya indicaba la ubicación del objetivo, sustituir determinadas tapas y colocar una insignia en un envase, 4/4 resultados cumplieron los criterios de la prueba en cada condición.
El resultado de ubicación procede de dos objetivos en una única imagen sintética, con una generación por modelo y condición. La figura muestra una aplicación directa para flujos donde una persona selecciona un objeto en un lienzo. Cuando el texto ya identificaba un objetivo único, la capa adicional no aportó ninguna mejora observable en las dos tareas anteriores.
¿Cómo probamos las ediciones?
Enviamos solicitudes JSON a través del endpoint de generación de imágenes de Synthorai. Cada solicitud generó un PNG de 1024 × 1024 con quality fijado en medium. En la comparación de las botellas mantuvimos la complejidad en media y variamos la capa de marcado. Para el programa utilizamos cuatro resultados correctos por modelo y ajuste. Las solicitudes a GPT Image 2 se ejecutaron en un lote independiente, y la persona encargada de evaluarlas conocía el modelo. Para las pruebas repetidas con 2.6, la misma persona evaluó imágenes numeradas y aplicó la misma lista de comprobación. El programa solo se consideró correcto si las dos tarjetas de destino eran las adecuadas, la insignia acompañaba a Sound Lab, se conservaban las otras cuatro tarjetas y las etiquetas de sala y hora, y el pie y la cuadrícula permanecían intactos.
El ejemplo usa el endpoint JSON de Synthorai en /v1/images/generations. OpenAI documenta la edición guiada por marcado en su endpoint nativo /v1/images/edits. Guía de generación de imágenes de OpenAI Synthorai Image API
Para reproducir la solicitud marcada de Flare, guarda ambos archivos junto al script. La capa es un PNG transparente con las mismas dimensiones que la imagen de origen y un círculo alrededor de la tapa inferior derecha. PNG de origen · PNG de la capa de marcado
import base64
import json
import os
from pathlib import Path
from urllib.request import Request, urlopen

def png_data_url(path):
    return "data:image/png;base64," + base64.b64encode(Path(path).read_bytes()).decode()

payload = {
    "model": "gpt-image-2.6-flare",
    "prompt": (
        "Change exactly one bottle cap from black to polished gold. "
        "If a cap is circled in the annotation, change that cap. "
        "Keep all other caps black and preserve the six bottles and layout. "
        "Do not reproduce the circle."
    ),
    "image": png_data_url("bottles.png"),
    "markup": png_data_url("cap-overlay.png"),
    "complexity": "medium",
    "quality": "medium",
    "size": "1024x1024",
    "n": 1,
    "output_format": "png",
}

request = Request(
    "https://synthorai.io/v1/images/generations",
    data=json.dumps(payload).encode(),
    headers={
        "Authorization": f"Bearer {os.environ['SYNTHORAI_API_KEY']}",
        "Content-Type": "application/json",
    },
)
with urlopen(request, timeout=240) as response:
    result = json.load(response)

Path("edited.png").write_bytes(base64.b64decode(result["data"][0]["b64_json"]))
print(result.get("usage"))
Preguntas frecuentes
¿La comparación con GPT Image 2 utiliza el mismo esfuerzo de planificación?
La solicitud a GPT Image 2 omitió complexity. Sunburst y Flare usaron explícitamente complejidad media en la tabla de tres modelos. Las entradas y los ajustes de salida son los mismos, y los resultados corresponden a esas configuraciones concretas de la API.
¿Probasteis GPT Image 2.5 a través de Synthorai?
GPT Image 2.5 Sunburst y Flare solo aparecen en la tabla pública de Arena. En el experimento de Synthorai usamos GPT Image 2, GPT Image 2.6 Sunburst y GPT Image 2.6 Flare. Clasificación de edición de una sola imagen de Arena
¿Cuándo conviene usar marcado para editar una imagen?
Usa markup cuando puedas señalar el objeto que quieres editar en la imagen, sobre todo si hay varios objetos similares. Envía la anotación como un PNG transparente separado y describe la edición en el prompt. En la imagen de las seis botellas, los modelos eligieron la tapa prevista en 4/4 solicitudes con marcado y en 1/4 sin marcado.
¿La complejidad alta hizo más fiables las ediciones del programa?
Con este diseño, Sunburst logró 2/4 con ambos ajustes y Flare obtuvo 0/4 con ambos. Flare colocó correctamente las dos charlas en dos generaciones con complejidad alta, pero en ambas situó mal la insignia FULL.