
Jev vs LLM flash: 7x más barato, mismo coste con una etiqueta
Contenido
- ¿Qué es Jev y en qué se diferencia de un LLM?
- ¿Cómo hicimos las pruebas?
- ¿Cuándo es Jev más barato que un LLM flash?
- ¿Cuánto más rápido es Jev?
- ¿Cómo encajan estos resultados con lo que afirma TypeSafe?
- ¿Es Jev tan preciso como un LLM flash?
- ¿Se puede confiar en la confianza de Jev?
- ¿Conviene usar Jev o un LLM flash?
- Preguntas frecuentes
Que Jev de TypeSafe sea más barato que un LLM flash depende del tipo de tarea. Al hacer 12 preguntas sobre cada transcripción de soporte, Jev costó 7 veces menos que GPT-5.6 Luna sin thinking y tardó 0.12 segundos descontando la red, frente a 1.66. Al asignar una sola etiqueta entre 77 opciones, costó lo mismo que Qwen3.8 Flash y GLM 5.3 Flash. Jev es un modelo de decisión: en lugar de generar texto, devuelve una opción, una puntuación o una probabilidad por cada pregunta definida. Lo comparamos con cinco modelos de chat de gama flash, tanto con la configuración más barata como con el thinking predeterminado, en cuatro pruebas basadas en datasets públicos. Fue el modelo más rápido en todas, pero nunca el más preciso.
TL;DR
- Con 12 preguntas por caso, los LLM flash costaron entre 4.8 y 37 veces más que Jev y tardaron entre 11 y 27 veces más, con una precisión similar.
- Para una etiqueta por mensaje, Jev costó lo mismo que Qwen3.8 Flash y GLM 5.3 Flash sin thinking.
- Con el thinking predeterminado, una etiqueta costó entre 1.5 y 26 veces más en los modelos flash que en Jev.
- GPT-5.6 Luna fue más preciso que Jev en todas las pruebas salvo en la detección de prompt injection.
- Las respuestas de Jev con una probabilidad de 0.99 o superior acertaron el 98% de las veces.
¿Qué es Jev y en qué se diferencia de un LLM?
Jev es el modelo “System One” de TypeSafe. Lee un fragmento de texto o JSON (el estado) y responde preguntas tipadas sobre él, sin generar texto que haya que parsear. Admite tres tipos de pregunta:
| Tipo de pregunta | Qué se pregunta | Qué devuelve |
|---|---|---|
| Noul (el nombre que usa TypeSafe para sí/no) | una pregunta de sí o no | una probabilidad entre 0 y 1 |
| Choice | elegir una de hasta 255 opciones definidas por el usuario | la opción, la probabilidad de cada opción y un nivel de confianza |
| Score | puntuar según una escala ordenada de 2 a 10 niveles definidos por el usuario | una puntuación ponderada por probabilidad y un nivel de confianza |
En cada request, las preguntas se identifican por nombre y se recibe una respuesta por cada nombre. Este ejemplo, con el formato documentado por TypeSafe (referencia de la API), hace tres preguntas de sí o no sobre una breve conversación de soporte:
curl https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": {"transcript": "Customer: My card was declined twice today.\nAgent: One moment.\nCustomer: Also, how do I change my PIN?"},
    "questions": {
      "declined_card": {"type": "noul", "instructions": "In `transcript`, does the customer report a declined card payment?"},
      "change_pin":    {"type": "noul", "instructions": "In `transcript`, does the customer want to change a PIN?"},
      "lost_card":     {"type": "noul", "instructions": "In `transcript`, does the customer report a lost or stolen card?"}
    }
  }'
Al ejecutarlo, recibimos esta respuesta:
{
  "model": "jev-1.13.0",
  "answers": {
    "declined_card": {"type": "noul", "noul": 0.99},
    "change_pin":    {"type": "noul", "noul": 0.98},
    "lost_card":     {"type": "noul", "noul": 0.02}
  },
  "usage": {"input_tokens": 359, "output_tokens": 56}
}
El código lee answers.<question>.noul y lo compara con un umbral, como haría con cualquier otro número. El campo model indica qué versión respondió. jev-latest cambia cuando TypeSafe publica una versión nueva, así que conviene fijar jev-1.13.0 si los umbrales se han ajustado para esa versión.
TypeSafe evalúa las preguntas en paralelo. Jev 1.13 cuesta $0.042 por millón de tokens de entrada y la salida es gratuita (modelos). Por token de entrada, es 3.6 veces más barato que Qwen3.8 Flash, 4.8 veces más barato que GPT-5.6 Luna y 18 veces más barato que Gemini 3.8 Flash. La entrada incluye la plantilla interna de TypeSafe, unos 300 tokens por llamada, además de todas las preguntas y opciones definidas. La llamada anterior facturó 359 tokens de entrada, $0.000015, mientras que sus 56 tokens de salida fueron gratuitos. TypeSafe detalla los puntos débiles de Jev en sus notas sobre irregularidades del modelo: conteo, aritmética, comparación de fechas, preguntas de varios pasos y estados largos cargados de texto irrelevante.
¿Cómo hicimos las pruebas?
Ejecutamos cuatro pruebas una vez cada una, los días 2026-09-21 y 2026-09-22, tanto con Jev como con cinco modelos de chat flash: GPT-5.6 Luna, Qwen3.8 Flash, GLM 5.3 Flash, DeepSeek V4.1 Flash y Gemini 3.8 Flash. Cada modelo de chat se ejecutó con la configuración de thinking operativa más barata, desactivada o en nivel low cuando no se admite desactivarla. En las tres pruebas de clasificación también lo ejecutamos con la configuración predeterminada del proveedor.
- 12 preguntas por caso: 150 transcripciones de soporte al cliente, cada una compuesta por entre uno y seis mensajes del dataset Banking77 (PolyAI, CC BY 4.0), por lo que las respuestas correctas son conocidas. Cada modelo responde 12 preguntas de sí o no por transcripción (“¿indica el cliente que ha perdido la tarjeta o que se la han robado?”), con una probabilidad para cada una. Jev recibe 12 preguntas Noul en una sola llamada y los modelos de chat devuelven un único objeto JSON. Repetimos 60 casos añadiendo antes de la transcripción un documento de referencia de 3,000 y otro de 12,000 tokens, ambos artículos de Wikipedia sobre banca.
- Una etiqueta: 308 mensajes de Banking77, 4 por cada una de las 77 intenciones. Jev recibe una pregunta Choice con 77 opciones. Los modelos de chat reciben la misma lista y responden con la intención.
- 28 etiquetas: 200 comentarios de GoEmotions (Google, Apache 2.0), cada uno con 28 emociones posibles.
- Prompt injection: las 116 filas del dataset de prueba de prompt injection de deepset (Apache 2.0), con una pregunta de sí o no para cada fila.
El coste se calcula multiplicando los tokens facturados por la tarifa pública de cada proveedor. La latencia procede de otra ejecución con 40 llamadas por modelo sobre una conexión persistente y con el tiempo de ida y vuelta de red descontado. La sección de rendimiento explica el método. También ejecutamos GPT-5.6 Terra y Seed 2.0 Mini en las tres pruebas de clasificación. Aparecen en las tablas, pero no en el gráfico.
¿Cuándo es Jev más barato que un LLM flash?
Cuando se hacen muchas preguntas sobre un mismo texto, cuando el texto es largo o cuando el modelo de chat usaría thinking. Para asignar una sola etiqueta a un texto corto con un modelo barato y sin thinking, Jev cuesta lo mismo.
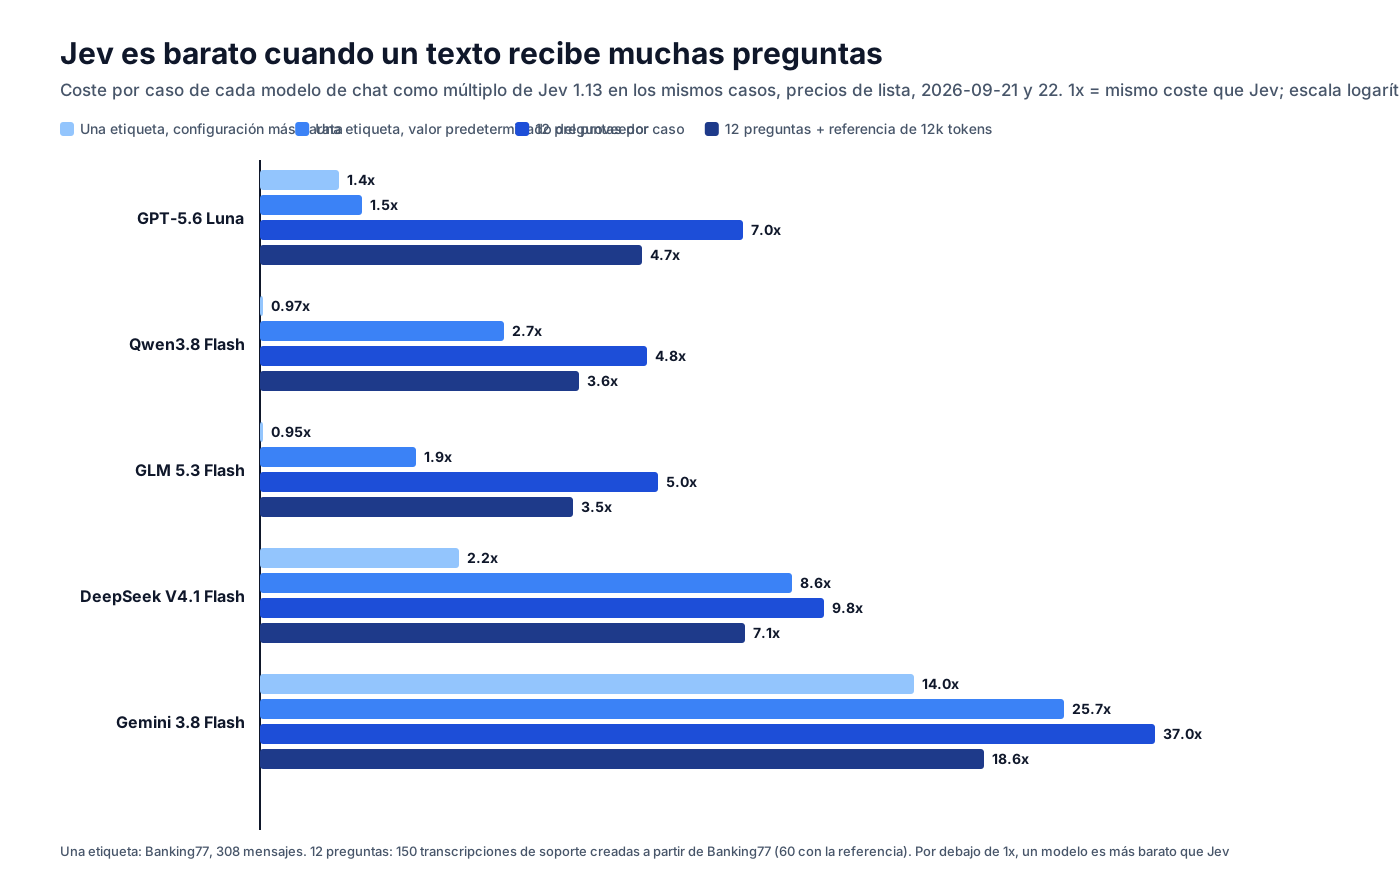
Hay tres factores que modifican ese múltiplo. El primero es el número de preguntas. Un modelo de chat debe generar una respuesta para cada una y la salida es la parte cara, GPT-5.6 Luna cobra $1.20 por millón de tokens de salida frente a $0.20 por los de entrada. En Jev, las respuestas son gratuitas y cada pregunta adicional añade unos 17 tokens de entrada. El segundo es el thinking. Con la configuración predeterminada de los proveedores, los modelos de chat generaron una mediana de hasta 161 tokens de salida por etiqueta, frente a entre 3 y 8 sin thinking. El múltiplo respecto a Jev aumentó en consecuencia. El tercero es la longitud de la entrada. Con una referencia de 12,000 tokens, la plantilla fija y las respuestas apenas influyen, y el múltiplo se aproxima a la relación entre los precios de entrada: desde 3.5 veces para GLM 5.3 Flash hasta 18.6 veces para Gemini 3.8 Flash. DeepSeek V4.1 Flash queda en 7.1 veces.
La prueba de una etiqueta es el caso en que Jev no ahorra nada frente a los modelos más baratos. Las 77 opciones añaden unos 1,400 tokens a cada llamada, por lo que un mensaje de una línea factura unos 1,690 tokens de entrada en Jev frente a 440 en Qwen3.8 Flash.
| Prueba, coste por 1,000 casos | Jev | Luna | Qwen3.8 Flash | GLM 5.3 Flash | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| 12 preguntas por caso | $0.027 | $0.19 | $0.13 | $0.14 | $0.27 | $1.02 |
| 12 preguntas, referencia de 12,000 tokens | $0.43 | $2.02 | $1.57 | $1.53 | $3.06 | $8.06 |
| Una etiqueta, configuración más barata | $0.071 | $0.098 | $0.069 | $0.068 | $0.16 | $0.99 |
| Una etiqueta, configuración predeterminada del proveedor | $0.071 | $0.11 | $0.19 | $0.13 | $0.61 | $1.83 |
¿Cuánto más rápido es Jev?
Entre 7 y 28 veces aproximadamente al descontar la red. La mediana de Jev fue de 0.11 a 0.12 segundos, mientras que los modelos de chat tardaron entre 0.79 y 3.25 segundos.
Cronometramos 40 llamadas por modelo y tarea, una a una sobre una conexión mantenida abierta, y restamos el tiempo de ida y vuelta medido en esa misma conexión con una petición que no hace ningún cálculo de modelo. Queda el tiempo del propio modelo más el trayecto desde nuestro proxy hasta su proveedor, el mismo para todos los modelos.
| Segundos sin la red, mediana (percentil 95) | Jev | GPT-5.6 Luna | Qwen3.8 Flash | GLM 5.3 Flash | DeepSeek V4.1 Flash | Gemini 3.8 Flash |
|---|---|---|---|---|---|---|
| Una etiqueta, configuración más barata | 0.11 (0.21) | 1.33 (1.80) | 0.96 (1.68) | 1.22 (3.06) | 0.79 (1.35) | 1.95 (3.76) |
| Una etiqueta, configuración predeterminada del proveedor | 0.11 (0.21) | 1.45 (5.29) | 3.25 (21.5) | 2.97 (7.32) | 1.19 (10.4) | 2.18 (8.22) |
| 12 preguntas por caso | 0.12 (0.20) | 1.66 (2.56) | 3.21 (5.21) | 3.13 (6.20) | 1.33 (1.70) | 2.14 (2.89) |
El impacto del thinking aparece en el percentil 95. Con la configuración predeterminada del proveedor, una de cada veinte llamadas a Qwen3.8 Flash tardó más de 21 segundos en asignar una sola etiqueta. Las llamadas más lentas de Jev se mantuvieron cerca de 0.2 segundos.
Añadir preguntas no ralentizó Jev: sobre un mismo ticket de soporte, pasar de 1 a 60 preguntas de sí o no movió la mediana menos de 0.1 segundos, y la llamada con 60 preguntas facturó 1,371 tokens de entrada, $0.000058. En las llamadas con 20 preguntas, todas las respuestas fueron correctas en las cinco ejecuciones.
¿Cómo encajan estos resultados con lo que afirma TypeSafe?
La tendencia coincide, aunque nuestras diferencias son menores porque las comparaciones no son las mismas. El artículo de lanzamiento de TypeSafe habla de hasta 444.6 veces menos coste y 193.6 veces más velocidad. La comparación se hizo contra modelos frontier con razonamiento en workflows de varios pasos, y la empresa describe esas cifras como “el extremo superior de las mejoras reales” (artículo de lanzamiento).
Sus evaluaciones de workflows publicadas incluyen GPT-5.6 Luna: Jev obtuvo un 67.8% de precisión, con $0.0004 y 0.4 segundos por caso, frente al 66.8%, $0.0033 y 12.9 segundos de Luna. Esto equivale a unas 8 veces menos coste y 32 veces más velocidad. En nuestra prueba de 12 preguntas, Luna sin thinking costó 7 veces más que Jev y tardó 14 veces más después de descontar la red, cifras del mismo orden de magnitud. Frente a los modelos flash más baratos y con una sola etiqueta, la diferencia de coste desaparece.
¿Es Jev tan preciso como un LLM flash?
Quedó cerca en la prueba de workflow, por detrás en las pruebas de clasificación y nunca en primer lugar. Con 12 preguntas por caso, el micro F1 de Jev, calculado sobre todos los síes y noes de todas las preguntas y donde 1.0 es perfecto, quedó dentro del rango de los modelos de chat. Sus probabilidades también ordenaron las respuestas correctas e incorrectas casi tan bien como los mejores modelos.
| 12 preguntas por caso (150 transcripciones) | Micro F1 con 0.5 | Las 12 respuestas correctas | AUC |
|---|---|---|---|
| Jev 1.13 | 0.909 | 61.3% | 0.990 |
| GPT-5.6 Luna, sin thinking | 0.933 | 71.3% | 0.973 |
| GPT-5.6 Luna, configuración predeterminada | 0.931 | 71.3% | 0.992 |
| Gemini 3.8 Flash, low | 0.919 | 66.7% | 0.974 |
| Qwen3.8 Flash, sin thinking | 0.913 | 62.7% | 0.975 |
| GLM 5.3 Flash, low | 0.906 | 64.7% | 0.975 |
| DeepSeek V4.1 Flash, sin thinking | 0.896 | 60.0% | 0.958 |
El AUC mide la capacidad de ordenar las probabilidades. Un valor de 1.0 significa que cada “sí” verdadero recibió una probabilidad mayor que cualquier “no”. Al añadir antes una referencia de 12,000 tokens, Jev mantuvo su precisión: F1 de 0.914 frente a 0.922 sobre las mismas 60 transcripciones sin la referencia.
En las pruebas de clasificación, los modelos de chat sacaron ventaja, sobre todo con la configuración de thinking predeterminada:
| Modelo y configuración | Una etiqueta (Banking77) | 28 etiquetas (micro F1 de GoEmotions) | Prompt injection |
|---|---|---|---|
| Jev 1.13 | 80.2% | 0.228 | 74.1% |
| GPT-5.6 Luna, sin thinking / predeterminada | 85.1% / 87.3% | 0.301 / 0.342 | 69.6% / 72.2% |
| GPT-5.6 Terra, sin thinking / predeterminada | 83.4% / 85.4% | 0.273 / 0.324 | 80.9% / 79.1% |
| Gemini 3.8 Flash, low / predeterminada | 84.4% / 83.8% | 0.373 / 0.372 | 81.9% / 82.8% |
| Qwen3.8 Flash, desactivado / predeterminada | 77.6% / 81.5% | 0.286 / 0.338 | 81.9% / 80.2% |
| GLM 5.3 Flash, low / predeterminada | 77.9% / 79.9% | 0.255 / 0.310 | 81.9% / 81.9% |
| DeepSeek V4.1 Flash, desactivado / predeterminada | 77.3% / 81.8% | 0.289 / 0.365 | 82.8% / 86.2% |
| Seed 2.0 Mini, sin thinking | 70.8% | 0.245 | 66.4% |
GPT-5.6 Luna y Terra respondieron a 115 de los 116 textos de prompt injection y a 199 de los 200 comentarios. Una request de cada prueba devolvió un error y la precisión se calcula sobre las respuestas recibidas. Las respuestas que no fueran sí o no contaron como incorrectas. En la prueba de emociones, Jev respondió afirmativamente con demasiada frecuencia: solo el 15% de las emociones a las que asignó entre 0.80 y 0.95 figuraban en la etiqueta humana. Las etiquetas de emociones son poco densas, los anotadores eligieron una o dos por comentario, lo que reduce la puntuación de todos los modelos, pero todos recibieron la misma instrucción. En prompt injection, el umbral predeterminado de 0.5 no era el adecuado para Jev, como se explica en la siguiente sección.
¿Se puede confiar en la confianza de Jev?
Sus probabilidades separan bien las respuestas correctas de las incorrectas, pero no están calibradas en el sentido habitual. Cada tarea necesita su propio umbral. Una probabilidad calibrada de 0.8 acertaría el 80% de las veces. En Banking77, Jev acertó el 98% de las respuestas con 0.99 o más, y aproximadamente la mitad de las que quedaron por debajo de 0.8.
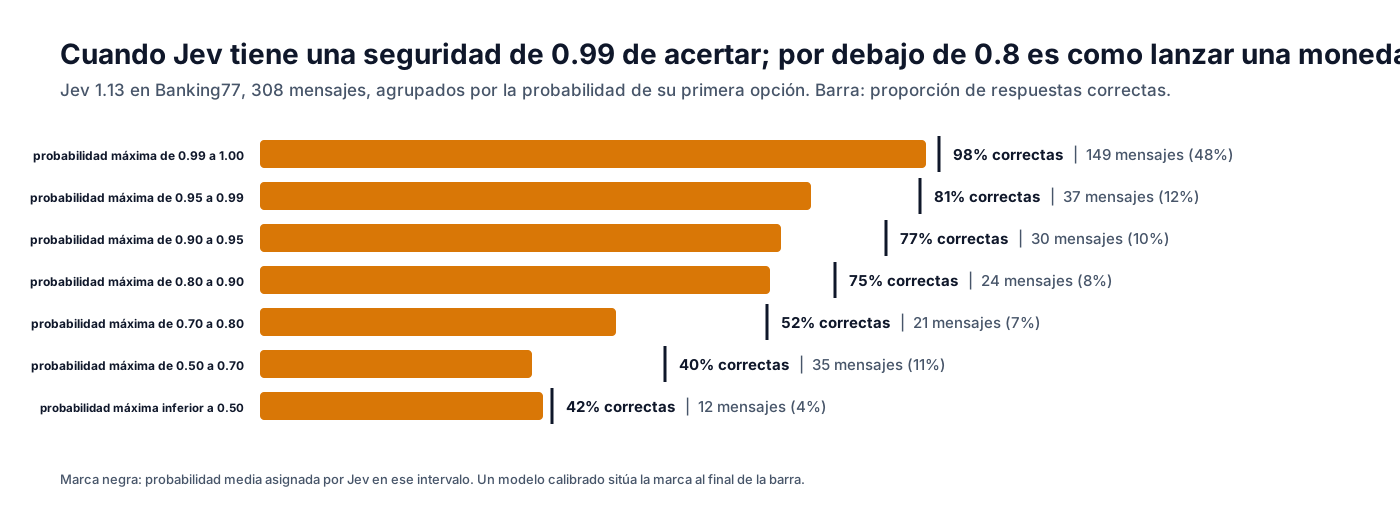
Casi la mitad de los mensajes de Banking77, el 48%, obtuvo una probabilidad máxima de 0.99 o superior. Un pipeline que acepte esos casos y envíe el resto a un modelo mayor mantiene una precisión del 98% para esa parte del tráfico. La prueba de prompt injection muestra la otra cara. Con el umbral predeterminado de 0.5, Jev solo detectó la mitad de los ataques. La otra mitad recibió probabilidades entre 0.03 y 0.5, bajas en términos absolutos, pero casi siempre superiores a las de los textos benignos, cuya mediana fue 0.02. Al ordenar los casos por probabilidad, separó los ataques de los textos benignos con un AUC de 0.984.
| Umbral en el dataset de prompt injection | Precisión de Jev | Ataques detectados | Falsas alarmas (de 56 textos benignos) |
|---|---|---|---|
| 0.5 (predeterminado) | 74.1% | 50.0% | 0 |
| 0.1 | 88.8% | 80.0% | 1 |
| 0.05 | 93.1% | 91.7% | 3 |
Estos umbrales se eligieron sobre los mismos 116 textos, así que deben tratarse como un límite superior. Un modelo de chat también puede proporcionar una probabilidad si su API devuelve log-probabilities de tokens, es decir, la probabilidad que el propio modelo asigna a cada token generado. De los modelos de chat probados, Qwen3.8 Flash y Seed 2.0 Mini las devolvieron en nuestras ejecuciones. La probabilidad de “sí” de Qwen3.8 Flash ordenó los textos de prompt injection con un AUC de 0.977.
¿Conviene usar Jev o un LLM flash?
| Si la tarea consiste en | Usar | Motivo según estas pruebas |
|---|---|---|
| hacer muchas preguntas de sí/no o elegir una opción sobre el mismo texto | Jev | entre 4.8 y 37 veces menos coste, entre 11 y 27 veces más rápido sin contar la red y precisión similar |
| tomar una decisión dentro de un bucle que debe responder en menos de un segundo | Jev | entre 0.11 y 0.12 s sin contar la red |
| evaluar documentos largos unas pocas veces | Jev | el coste se aproxima a la relación de precios de entrada, entre 3.5 y 18.6 veces menos |
| asignar una etiqueta por mensaje corto con el menor coste posible | Jev, Qwen3.8 Flash o GLM 5.3 Flash sin thinking | el coste es el mismo; los LLM no devuelven probabilidades salvo que se lean las log-probabilities |
| obtener la etiqueta más precisa | GPT-5.6 Luna con su configuración predeterminada | 87.3% en Banking77 por $0.11 cada 1,000 casos |
| trabajar con números, fechas, conteo o texto generado | un modelo de chat | TypeSafe los identifica como puntos débiles de Jev |
El patrón que mejor aprovechó Jev en nuestras pruebas fue descomponer la decisión en muchas preguntas concretas sobre el mismo texto, actuar sobre las respuestas que superen un umbral ajustado con datos etiquetados propios y enviar el resto a un modelo de chat.
Preguntas frecuentes
¿Qué es TypeSafe Jev?
Jev es un modelo de decisión de TypeSafe que responde preguntas tipadas sobre un texto, de sí/no, elección de una opción o puntuación en una escala, y devuelve probabilidades en lugar de texto generado. Jev 1.13 es la versión actual, publicada bajo el alias jev-latest, y cuesta $0.042 por millón de tokens de entrada, con la salida gratuita.
¿Es Jev más barato que un LLM? Depende de la tarea. Al hacer 12 preguntas sobre cada transcripción de soporte, GPT-5.6 Luna sin thinking costó 7 veces más que Jev y Gemini 3.8 Flash costó 37 veces más. Al asignar una sola etiqueta entre 77 opciones, Qwen3.8 Flash y GLM 5.3 Flash sin thinking costaron lo mismo que Jev.
¿Es Jev más preciso que GPT-5.6 Luna? No en nuestras pruebas. GPT-5.6 Luna sin thinking obtuvo un micro F1 de 0.933 frente al 0.909 de Jev con 12 preguntas por caso, y un 85.1% frente a un 80.2% en Banking77. Con su umbral predeterminado de 0.5, Jev detectó más prompt injections que Luna sin thinking.
¿Por qué afirma TypeSafe que Jev es 444 veces más barato? Esa cifra compara Jev con modelos frontier que usan razonamiento en workflows de varios pasos, y TypeSafe la presenta como un valor del extremo superior. Frente a modelos flash, medimos entre 4.8 y 37 veces menos coste en un workflow de 12 preguntas y aproximadamente el mismo coste al asignar una sola etiqueta.
¿Están calibradas las probabilidades de Jev? No en el sentido habitual. En Banking77, las respuestas con una probabilidad de 0.99 o superior acertaron el 98% de las veces, pero por debajo de 0.8 solo acertaron aproximadamente la mitad. En prompt injection, Jev asignó una probabilidad inferior a 0.5 a la mitad de los ataques. Hay que ajustar un umbral por tarea con datos etiquetados propios.
Relacionado: mejor API de LLM flash en 2026, comparativa de salidas estructuradas de LLM, controles de thinking en LLM, mejor LLM según el caso de uso.