
GPT-4 y GPT-3.5 Turbo cierran el 23/10: relevar 3.5 cuesta casi 5x
Contenido
- ¿Qué modelos de OpenAI dejan de funcionar el 23 de octubre y cuáles los sustituyen?
- ¿Es la opción más barata el sustituto que indica OpenAI?
- ¿Cómo hicimos la prueba?
- ¿Cuánto cuesta cada sustituto por 1,000 llamadas?
- ¿Sube la factura con el esfuerzo de razonamiento predeterminado?
- ¿Qué sustituto conviene elegir?
- Preguntas frecuentes
OpenAI dejará de servir GPT-4, GPT-4 Turbo, GPT-3.5 Turbo, GPT-4.1 nano, o1, o3-mini y o4-mini el 2026-10-23. Todos los modelos de texto que propone como sustitutos pertenecen a GPT-5.6: la lista se redactó cinco meses antes de que existiera GPT-6. Seguirla multiplica por cinco la factura de quienes usan GPT-3.5 Turbo. En nuestra prueba, GPT-5.6 Terra, el sustituto indicado, costó $0.75 por 1,000 llamadas cortas, frente a unos $0.15 con los precios de GPT-3.5 Turbo. GPT-6 Luna resolvió correctamente todas esas llamadas por $0.037.
TL;DR
- El cierre de OpenAI del 2026-10-23 afecta a GPT-4, GPT-4 Turbo, GPT-3.5 Turbo, GPT-4.1 nano, gpt-4o-2024-05-13, o1, o1-pro, o3-mini y o4-mini.
- GPT-5.6 Terra, el sustituto de OpenAI para GPT-3.5 Turbo, tiene un precio de lista de $2 / $12 por millón de tokens, frente a $0.50 / $1.50.
- Los cinco candidatos para sustituirlos acertaron las 96 tareas cortas.
- Coste por 1,000 llamadas: GPT-5.6 Sol $1.41, GPT-6.1 Sol $0.72, GPT-5.6 Terra $0.75, GPT-5.6 Luna $0.075, GPT-6 Luna $0.037.
¿Qué modelos de OpenAI dejan de funcionar el 23 de octubre y cuáles los sustituyen?
Nueve familias de modelos de texto dejarán de responder el 2026-10-23. La página de modelos retirados de OpenAI asigna a cada una un sustituto GPT-5.6. Cada fila incluye las versiones fechadas del modelo (versiones fijas como gpt-4-0613) y sus modelos ajustados mediante fine-tuning (copias entrenadas para un uso concreto). Los importes son precios de lista por millón de tokens, entrada / salida, según la página de precios y las páginas de modelos de OpenAI.
| Modelo retirado | Precio de lista | Sustituto de OpenAI | Precio de lista |
|---|---|---|---|
| GPT-4 | $30 / $60 | GPT-5.6 Sol | $4 / $20 |
| GPT-4 Turbo | $10 / $30 | GPT-5.6 Sol | $4 / $20 |
| gpt-4o-2024-05-13 | $5 / $15 | GPT-5.6 Sol | $4 / $20 |
| o1 | $15 / $60 | GPT-5.6 Sol | $4 / $20 |
| o1-pro | $150 / $600 | GPT-5.6 Sol | $4 / $20 |
| o3-mini | $1.10 / $4.40 | GPT-5.6 Sol | $4 / $20 |
| GPT-4.1 nano | $0.10 / $0.40 | GPT-5.6 Luna | $0.20 / $1.20 |
| GPT-3.5 Turbo | $0.50 / $1.50 | GPT-5.6 Terra | $2 / $12 |
| o4-mini | $1.10 / $4.40 | GPT-5.6 Terra | $2 / $12 |
También se retiran gpt-image-1 (sustituido por gpt-image-2.5-sunburst o gpt-image-2.5-flare) y los modelos babbage-002 y davinci-002 ajustados mediante fine-tuning. GPT-4o como tal y sus versiones más recientes no figuran en esta lista. Ya hay otras dos tandas con fecha: tts-1 y tts-1-hd el 2027-01-06, y gpt-5.1, gpt-5.3-codex y gpt-5.4-nano el 2027-04-01.
OpenAI anunció esta tanda el 2026-04-22. GPT-6 salió el 2026-09-22, así que no podía aparecer en la columna de sustitutos. Cuatro de los nueve cambios suben el precio de lista: o3-mini, GPT-4.1 nano, GPT-3.5 Turbo y o4-mini.
¿Es la opción más barata el sustituto que indica OpenAI?
No lo es en ninguna fila. Los modelos GPT-6 cuestan aproximadamente la mitad que los GPT-5.6 según sus precios de lista y no aparecen en esa tabla. Sol, Terra y Luna son las gamas grande, intermedia y pequeña. El precio de la entrada en caché se aplica a la parte del prompt que OpenAI sirve desde su prompt cache.
| Entrada | Entrada en caché | Salida | |
|---|---|---|---|
| GPT-5.6 Sol | $4.00 | $0.40 | $20.00 |
| GPT-6.1 Sol | $2.00 | $0.10 | $10.00 |
| GPT-5.6 Terra | $2.00 | $0.20 | $12.00 |
| GPT-5.6 Luna | $0.20 | $0.02 | $1.20 |
| GPT-6 Luna | $0.10 | $0.01 | $0.50 |
El precio de $4 / $20 de GPT-5.6 Sol es promocional y, según OpenAI, estará disponible al menos hasta el 2026-11-21. GPT-6 no tiene una gama Terra. GPT-5.6 Terra resulta más caro por ambos lados: GPT-6.1 Sol, de una gama superior, tiene el mismo precio de entrada y uno menor de salida; GPT-6 Luna cuesta veinte veces menos.
¿Cómo hicimos la prueba?
La lista de precios indica cuánto cuesta un token. Para migrar hay que saber además si el modelo más barato sigue resolviendo la tarea y si, al razonar, consume tokens adicionales. Los cinco candidatos son modelos de razonamiento. reasoning.effort es el parámetro de la Responses API que determina cuánto razonamiento oculto hace un modelo antes de responder. Esos tokens se facturan como salida. Si no se especifica, se usa el valor predeterminado del modelo (medium en GPT-6.1 Sol y GPT-6 Luna); none desactiva el razonamiento.
Ejecutamos 96 tareas cortas habituales para GPT-3.5 Turbo y GPT-4.1 nano. Cada una tenía una única respuesta correcta, verificada mediante código:
- Clasificación: 40 mensajes de soporte, 8 etiquetas y reglas para los mensajes que encajan en dos etiquetas.
- Extracción: 30 correos de pedidos convertidos en objetos JSON de 6 campos, con datos que podían confundir al modelo, como el id de un pedido anterior y un subtotal.
- Llamadas a herramientas: 26 solicitudes de soporte que debían convertirse en una llamada a una función, con los argumentos correctos, entre 5 herramientas.
Otras cuatro solicitudes de herramienta no se puntúan. Hacen una pregunta antes de indicar el cambio («El pedido A-88643 aún no se ha enviado, ¿verdad? La nueva dirección de entrega está en Graz»), y 18 de las 56 respuestas consultaron el pedido antes de cambiar la dirección: 9 de 12 en GPT-6 Luna, 4 de 12 en GPT-5.6 Luna, 3 de 12 en GPT-5.6 Terra y 1 en cada uno de los dos modelos Sol. Ambas lecturas son defendibles, así que estas cuatro ponen a prueba la redacción más que el modelo.
Probamos cada modelo sin razonamiento, con low y con su valor predeterminado (GPT-6.1 Sol solo con low y el predeterminado, porque no admite none): 1,344 llamadas. Cada una llevaba una cadena aleatoria única para evitar que se sirviera desde una caché. Calculamos los costes con los precios de lista de OpenAI. No podemos llamar a los modelos que se retiran, así que estimamos su coste a partir de los tokens medidos (234 de entrada y 24 de salida por llamada) y del precio de lista de cada modelo. Los tokenizadores, que dividen el texto en tokens, varían entre generaciones; por eso, estas cifras son aproximadas.
¿Cuánto cuesta cada sustituto por 1,000 llamadas?
En tareas cortas, la decisión se reduce al precio: la precisión no distinguió a los modelos. Los cinco acertaron las 96 tareas con todos los ajustes. La tabla muestra el coste por 1,000 llamadas sin razonamiento (con low en GPT-6.1 Sol).
| Si usas | Coste estimado actual | Sustituto de OpenAI | Opción GPT-6 |
|---|---|---|---|
| GPT-4 | $8.48 | GPT-5.6 Sol, $1.41 | GPT-6.1 Sol, $0.72 |
| GPT-4 Turbo | $3.07 | GPT-5.6 Sol, $1.41 | GPT-6.1 Sol, $0.72 |
| gpt-4o-2024-05-13 | $1.53 | GPT-5.6 Sol, $1.41 | GPT-6.1 Sol, $0.72 |
| GPT-3.5 Turbo | $0.15 | GPT-5.6 Terra, $0.75 | GPT-6 Luna, $0.037 |
| GPT-4.1 nano | $0.033 | GPT-5.6 Luna, $0.075 | GPT-6 Luna, $0.037 |
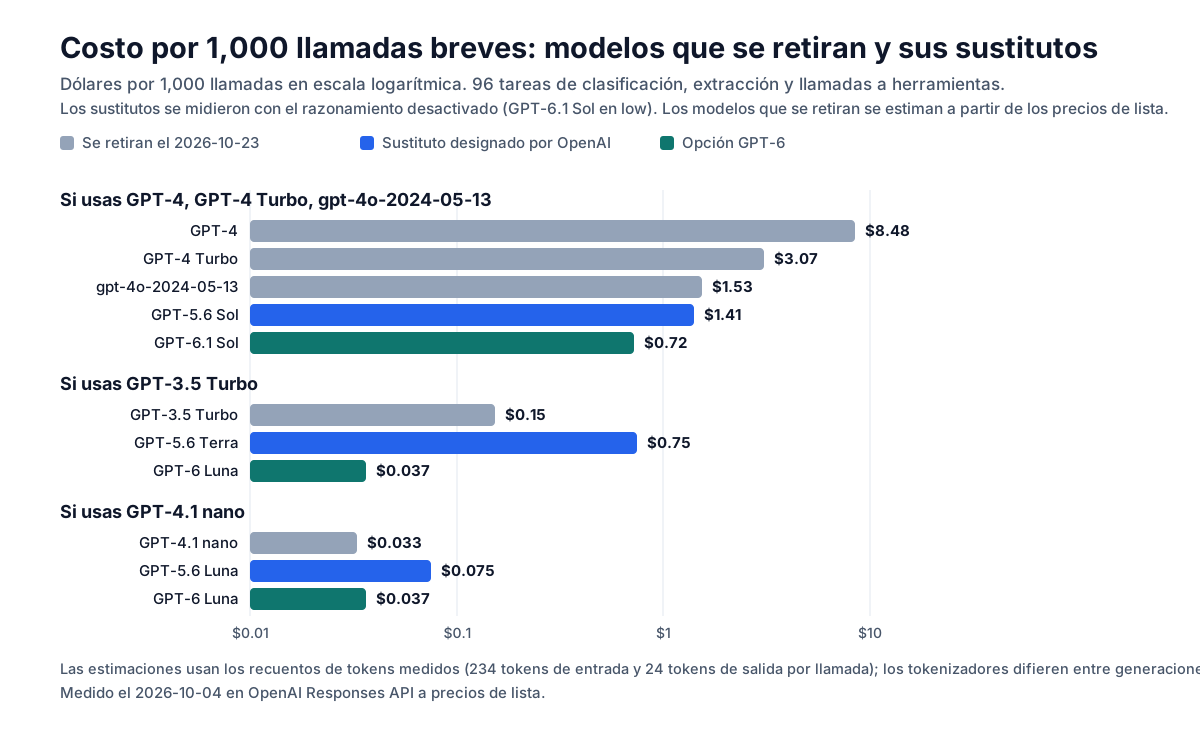
Para GPT-4 y GPT-4 Turbo, cualquier cambio supone un ahorro. Con gpt-4o-2024-05-13, GPT-5.6 Sol cuesta casi lo mismo y GPT-6.1 Sol, la mitad. Para GPT-3.5 Turbo, el sustituto indicado cuesta 4.9 veces más y GPT-6 Luna, una cuarta parte. Para GPT-4.1 nano, el sustituto indicado cuesta 2.3 veces más y GPT-6 Luna, casi lo mismo.
La serie o no figura en esta tabla. o1, o3-mini y o4-mini consumen tokens de razonamiento que no podemos medir, así que para ellos solo sirven los precios de lista de la primera tabla. Si tu carga requiere razonamiento, nuestras mediciones de GPT-6.1 Sol cubren 13 tareas con cada ajuste de esfuerzo.
¿Sube la factura con el esfuerzo de razonamiento predeterminado?
El esfuerzo predeterminado encarece un poco las llamadas en los modelos Sol y bastante más en los modelos baratos. Dejar reasoning.effort en su valor predeterminado aumentó el coste de estas llamadas un 5% en GPT-5.6 Sol y GPT-6.1 Sol, un 22% en GPT-5.6 Terra, un 34% en GPT-6 Luna y un 42% en GPT-5.6 Luna, sin mejorar la precisión. El razonamiento consumió pocos tokens, como máximo 25 por llamada, pero si la respuesta solo tiene 24 tokens, eso duplica los tokens de salida.
from openai import OpenAI

client = OpenAI()
resp = client.responses.create(
    model="gpt-6-luna",
    reasoning={"effort": "none"},  # no hidden reasoning; use "low" on gpt-6.1-sol
    max_output_tokens=64,
    input="Classify the customer message into exactly one label: ...",
)
print(resp.output_text)
print(resp.usage.output_tokens, resp.usage.output_tokens_details.reasoning_tokens)
Un límite de salida bajo, habitual en código de clasificación escrito para GPT-3.5 Turbo, no causó problemas aquí: con max_output_tokens en 64, las 200 llamadas devolvieron la etiqueta, también con el esfuerzo predeterminado. Una tarea que exija más razonamiento podría agotar un límite bajo antes de escribir la respuesta. Comprueba output_tokens_details.reasoning_tokens en tus propias llamadas.
La latencia fue similar en cuatro de los cinco modelos, con una mediana de 2.2 a 2.4 segundos por llamada. GPT-6.1 Sol tardó de 2.9 a 3.2 segundos.
La guía de migración de OpenAI enumera los cambios en las solicitudes: hay que quitar temperature, top_p y top_logprobs salvo que el esfuerzo sea none; GPT-6.1 Sol no admite none; y las llamadas a herramientas con razonamiento requieren la Responses API.
¿Qué sustituto conviene elegir?
Elige según el uso que le dabas al modelo retirado. La propuesta de OpenAI es una opción más, no la única.
| Si usas | Elige | Motivo |
|---|---|---|
| GPT-3.5 Turbo para clasificación, extracción o enrutamiento | GPT-6 Luna con reasoning.effort: "none" | $0.037 por 1,000 llamadas frente a $0.75 con GPT-5.6 Terra; ambos acertaron las 96 tareas |
| GPT-4.1 nano | GPT-6 Luna con esfuerzo none | $0.037 frente a los $0.033 actuales; GPT-5.6 Luna cuesta $0.075 |
| GPT-4, GPT-4 Turbo o gpt-4o-2024-05-13 para tareas cortas | GPT-6.1 Sol con low, o GPT-6 Luna si supera una prueba con tus datos | $0.72 frente a $1.41 con GPT-5.6 Sol, cuyo precio es promocional |
| GPT-4 para documentos largos | GPT-6.1 Sol | escribe tanto como GPT-5.6 Sol por un 59% menos por documento en nuestra prueba con documentos; GPT-6 Luna escribe aproximadamente la mitad si el prompt no especifica las partes |
| Cualquier uso donde cada llamada deba ser rápida | GPT-6 Luna o GPT-5.6 Sol | GPT-6.1 Sol fue el más lento en esta prueba: de 2.9 a 3.2 segundos, frente a 2.2 a 2.4 |
| o1, o3-mini, o4-mini | GPT-6.1 Sol con medium o superior | Su precio de lista de $2 / $10 es inferior al de los dos sustitutos indicados ($4 / $20 y $2 / $12), aunque superior al de o3-mini y o4-mini ($1.10 / $4.40); mídelo con tus tareas, porque el coste del razonamiento depende de ellas |
Para migrar un modelo ajustado mediante fine-tuning no basta con cambiar su nombre. OpenAI indica un modelo base para cada uno, pero hay que volver a crear el fine-tune o sustituirlo por un prompt. No probamos esa migración.
Nuestras tareas son cortas y tienen una sola respuesta correcta. Antes de cambiar de modelo, prueba tus prompts con el candidato y compara las respuestas. Que una gama más barata acierte nuestras 96 tareas no garantiza que se comporte igual con las tuyas.
Preguntas frecuentes
¿Cuándo deja de funcionar GPT-4 en la API?
GPT-4, GPT-4 Turbo y la versión gpt-4o-2024-05-13 dejan de funcionar en la API de OpenAI el 2026-10-23, junto con GPT-3.5 Turbo, GPT-4.1 nano, o1, o1-pro, o3-mini y o4-mini. OpenAI anunció la fecha el 2026-04-22.
¿Qué sustituye a GPT-3.5 Turbo? OpenAI indica GPT-5.6 Terra como sustituto de GPT-3.5 Turbo, a $2 / $12 por millón de tokens frente a $0.50 / $1.50. En nuestra prueba, GPT-6 Luna, a $0.10 / $0.50, acertó las mismas 96 tareas cortas por una vigésima parte del coste de GPT-5.6 Terra.
¿Es GPT-6 Luna más barato que GPT-3.5 Turbo? El precio de lista de GPT-6 Luna es de $0.10 por millón de tokens de entrada y $0.50 por millón de tokens de salida: una quinta y una tercera parte de los $0.50 y $1.50 de GPT-3.5 Turbo. Sin razonamiento, 1,000 llamadas cortas costaron $0.037 en nuestra prueba, frente a unos $0.15 con los precios de GPT-3.5 Turbo.
Otras mediciones: GPT-6.1 Sol frente a Claude Sonnet 5.5, GPT-6 Luna frente a GPT-5.6 Luna y cómo reducir el coste de GPT-5.6.