
Opus 5.5 vs Opus 5: Gleiche Antworten, halb so viele Token
Inhalt
- Was hat sich bei Claude Opus 5.5 tatsächlich geändert?
- Was zeigen die veröffentlichten Benchmarks?
- Gilt das günstigere Preismodell auch für Single-Shot-Aufgaben?
- Was passiert in einem Tool-Loop, in dem sich Agent-Kosten aufsummieren?
- Wie viel der Ersparnis stammt nur aus der Preissenkung?
- Lohnt sich eine höhere Effort-Stufe jemals?
- Was geht beim Wechsel der Modell-ID kaputt?
- Lassen sich Prompt-Budgets unverändert übernehmen?
- Wann sollte man wechseln?
- FAQ
Claude Opus 5.5 ist laut Preisliste 20% günstiger als Claude Opus 5: $4 statt $5 pro Million Input-Token und $20 statt $25 pro Million Output-Token. Diese 20% gelten unabhängig vom Verhalten des Modells. Entscheidend ist daher, wie viel Ersparnis nach Abzug dieses Preisvorteils übrig bleibt. Bei 13 Single-Shot-Aufgaben mit den jeweiligen Standardeinstellungen verursachte Opus 5.5 65% geringere Kosten. Bei identischen Tokenpreisen wäre es noch immer 56% günstiger. In einem mehrstufigen Tool-Loop fällt der Unterschied deutlich kleiner aus: 37% weniger auf der Rechnung und 22% bei gleichen Preisen.
TL;DR
- Über 468 bewertete Aufrufe hinweg kostete Opus 5.5 $0.0072 pro Aufgabe, Opus 5 dagegen $0.0204. Beide lösten jede Aufgabe korrekt.
- Bei identischen Preisen war Opus 5.5 für diese Aufgaben noch immer 56% günstiger: Im Durchschnitt erzeugte es 341 statt 799 Output-Token.
- In einem Tool-Loop mit vier Fragen schrumpft der Unterschied bei gleichen Preisen auf 22%, weil Input-Token den Großteil ausmachen und beide Modelle dieselben Dateien lesen.
- Mit
maxEffort kostete Opus 5.5 in diesem Loop 3.3x so viel wie mit der eigenen Standardeinstellung, löste aber keine zusätzliche Aufgabe. tool_choicemitanyoder einem benannten Tool liefert jetzt HTTP 400. Opus 5 akzeptiert beide Varianten.
Anthropic veröffentlichte Opus 5.5 am 2026-09-22 mit der Aussage, typische Workloads seien damit “40% günstiger als mit Opus 5”. Nur die zweite Hälfte dieser Ersparnis, weniger Token pro Aufgabe, hängt vom Verhalten des Modells ab. Genau diesen Anteil haben wir gemessen.
Was hat sich bei Claude Opus 5.5 tatsächlich geändert?
Die Preissenkung ist die kleinere Änderung. Wichtiger ist, dass sich Thinking nicht mehr abschalten lässt. Beim Adaptive Thinking entscheidet das Modell selbst, wie lange es vor der Antwort nachdenkt. Diese Reasoning-Token werden als Output berechnet, unabhängig davon, ob die API sie anzeigt. Bei Opus 5.5 ist dieser Modus immer aktiv. Steuern lässt sich nur noch effort, ein Request-Parameter mit fünf Stufen von low bis max, der das verfügbare Thinking-Budget festlegt.
Opus 5 akzeptierte thinking: {"type": "disabled"}. In unseren Messungen zu Opus 5 war dies die einzige Einstellung, mit der die Kosten auf das Niveau von Opus 4.8 sanken. Diese Option gibt es nicht mehr.
| Opus 5 | Opus 5.5 | |
|---|---|---|
| Listenpreis (Input / Output pro MTok) | $5 / $25 | $4 / $20 |
| Thinking | adaptiv, bei Effort high oder niedriger abschaltbar | adaptiv, immer aktiv |
| Standard-Effort | high | medium |
| Erzwungene Tool-Nutzung | akzeptiert | 400-Fehler (gemessen) |
| Kontextfenster / maximaler Output | 1M / 128K | 1M / 128K |
| Wissensstand | Mai 2026 | Juni 2026 |
| Veröffentlicht | 2026-07-24 | 2026-09-22 |
| Text zwischen Tool-Aufrufen | text-Blöcke | thinking-Blöcke, bei der standardmäßigen Anzeigeeinstellung leer |
| Schutzkategorien | Cybersicherheit | Cybersicherheit plus Biologie sowie Ablehnung bei Reasoning-Extraktion |
Zwei Punkte aus der Tabelle haben größere Auswirkungen. Der Standard-Effort wurde von high auf medium gesenkt. Ein Request ohne Effort-Feld nutzt deshalb nicht dieselbe Reasoning-Tiefe wie bei Opus 5. Auch die Änderung bei Fortschrittsmeldungen erfolgt ohne Hinweis: Kurze Meldungen zwischen Tool-Aufrufen kommen jetzt als Thinking-Blöcke an. Deren Text bleibt leer, sofern er nicht ausdrücklich angefordert wird. Eine Benutzeroberfläche, die diese Meldungen streamt, bleibt dadurch ohne Fehlermeldung stumm.
Was zeigen die veröffentlichten Benchmarks?
In der Veröffentlichungstabelle von Anthropic liegt Opus 5.5 bei allen Benchmarks für Coding und Wissensarbeit vor Fable 5.1 und bei den meisten auch vor GPT-6 Astra. Die folgenden Werte stammen von Anthropic. Sie wurden mit Adaptive Thinking und maximalem Effort ermittelt, bei den Terminal-Bench-Zeilen mit xhigh.
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra |
|---|---|---|---|---|
| Terminal-Bench 4.0 (agentisches Coding) | 66.4% | 55.8% | 52.3% | 57.9% |
| FrontierCode v1.1 | 54.4% | 50.3% | 48.0% | 53.3% |
| CursorBench 4.0 | 57.8% | 51.8% | 46.6% | nicht angegeben |
| GDPval-AA v2.1 (Wissensarbeit, Elo) | 1846 | 1735 | 1708 | 1542 |
| AutomationBench (Geschäftsabläufe) | 40.0% | 31.4% | 26.9% | 41.4% |
| Terminal-Bench-Science 0.1 | 58.7% | 52.6% | 29.0% | 64.6% |
| OSWorld 2.0 (Computersteuerung) | 81.8% | 80.7% | 74.0% | nicht angegeben |
Anthropic versieht die eigene Tabelle mit einem ungewöhnlichen Vorbehalt: Auf diesem Niveau seien “Benchmark-Abstände kein verlässlicher Maßstab mehr für Unterschiede in der Praxis”. Der Abstand zu Fable 5.1 sei im realen Einsatz kleiner, als die Werte vermuten lassen. Vor einer Bewertung der Zahlen sind außerdem zwei Fußnoten relevant. Der AutomationBench-Lauf wurde von Zapier ohne Fallback-Modelle durchgeführt. Jeder Eingriff eines Schutzmechanismus zählte daher als Fehler. Für die gesamte Tabelle waren die produktiven Schutzmechanismen aktiv. Griff ein Klassifikator ein, wurden Aufgaben zur Cybersicherheit an Opus 4.8 und Aufgaben zur Biologie an Opus 5 übergeben.
Über die Kosten einer Aufgabe sagen diese Benchmarks nichts aus. Deshalb haben wir selbst gemessen.
Gilt das günstigere Preismodell auch für Single-Shot-Aufgaben?
Ja, und der größte Teil der Ersparnis entsteht durch echte Effizienz statt durch die niedrigeren Listenpreise. Single-Shot bedeutet: ein Request, eine Antwort, keine Tools. Unsere Aufgaben bestanden aus Rechen- und Zählproblemen, etwa einer Iterationsregel mit 200 Schritten oder der Anzahl möglicher Pfade durch ein Raster mit blockierten Zellen. Wir führten 13 Aufgaben mit jeweils 3 Wiederholungen auf allen fünf Effort-Stufen sowie mit der Standardeinstellung aus, sowohl mit Opus 5.5 als auch mit Opus 5. Insgesamt waren das 468 bewertete Aufrufe. Vor dem Lauf berechneten wir alle Lösungen per Brute Force in Python. Jeder Prompt enthielt außerdem eine eindeutige Zufallszeichenfolge, damit keine Schicht zwischen uns und dem Modell eine identische Anfrage aus einem Cache beantworten konnte. Die Kosten pro Aufgabe basieren auf den Listenpreisen von Anthropic und den abgerechneten Token jedes Aufrufs, einschließlich Thinking. Sie wurden nicht aus der Response übernommen.
| Effort | Median Output Opus 5.5 | Opus 5.5 $/Aufgabe | Median Output Opus 5 | Opus 5 $/Aufgabe |
|---|---|---|---|---|
| Standard | 193 | 0.0072 | 448 | 0.0204 |
| low | 185 | 0.0060 | 439 | 0.0201 |
| medium | 218 | 0.0085 | 538 | 0.0200 |
| high | 223 | 0.0094 | 542 | 0.0206 |
| xhigh | 233 | 0.0111 | 525 | 0.0197 |
| max | 762 | 0.0240 | 532 | 0.0220 |
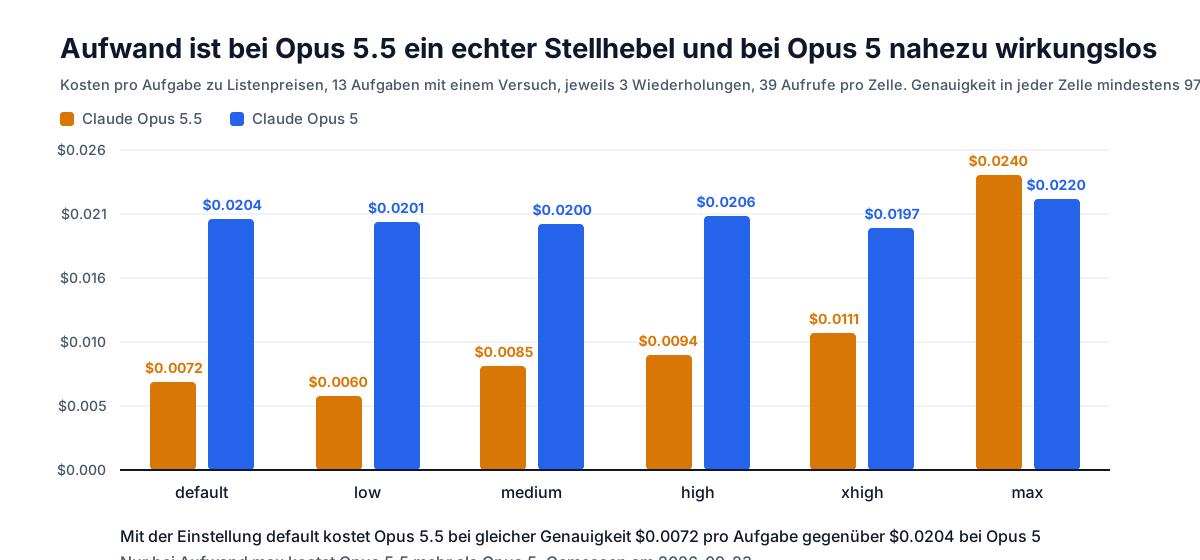
Mit den Standardeinstellungen erreichten beide Modelle 100% Genauigkeit. Auf allen anderen Stufen waren es mindestens 97%. Die drei Fehler verteilten sich auf unterschiedliche Aufgaben und Stufen, statt sich am unteren Ende der Skala zu häufen. Bei diesem Aufgabensatz gibt es keinen plötzlichen Genauigkeitsverlust. Der Unterschied liegt vollständig bei den Kosten.
Die Effort-Skala verhält sich bei den beiden Modellen unterschiedlich. Die Kosten von Opus 5 bleiben von low bis max nahezu konstant zwischen $0.0197 und $0.0220, eine Spanne von 12%. Bei Opus 5.5 liegen sie zwischen $0.0060 und $0.0240, also um den Faktor 4 auseinander. Effort wirkt sich bei Opus 5.5 deutlich aus, bei Opus 5 dagegen kaum. Wer bei einer Migration denselben Wert übernimmt, kann deshalb bei einem ganz anderen Kostenprofil landen.
Bei den fünf schwierigsten Aufgaben wird der Abstand größer. Opus 5.5 kostete mit der Standardeinstellung $0.0113 pro Aufgabe, Opus 5 dagegen $0.0375. Der Median lag bei 585 statt 1,145 Output-Token.
Was passiert in einem Tool-Loop, in dem sich Agent-Kosten aufsummieren?
Auch in einem Loop bleibt die Ersparnis bestehen, fällt aber kleiner aus. Ein Tool-Loop ist der realistische Vergleich zwischen Opus 5.5 und Opus 5. Jeder Turn entspricht einem Request: Das Modell fordert ein Tool an, der eigene Code führt es aus und sendet das vollständige Transkript zurück. Bei einer Unterhaltung mit fünf Turns wird das wachsende Transkript fünfmal berechnet. Die Kosten hängen deshalb stärker von der Anzahl der Turns als vom Tokenpreis ab. Beide Modelle erhielten drei Tools zum Auflisten, Lesen und Durchsuchen von Dateien in einem kleinen synthetischen Service. Hinzu kamen vier Fragen, deren Antworten eine Aufrufkette über drei oder vier Dateien hinweg erforderten. Pro Variante führten wir 12 Läufe mit derselben API-Oberfläche, denselben Tools und demselben Prompt aus.
| Variante | Gelöst | Median Turns | Median Tool-Aufrufe | Median Output-Token | $/Lauf |
|---|---|---|---|---|---|
| Opus 5.5, Standard | 12/12 | 4 | 5 | 427 | 0.0326 |
Opus 5.5, low | 12/12 | 4.5 | 5 | 430 | 0.0330 |
Opus 5.5, max | 12/12 | 5 | 12 | 3,124 | 0.1087 |
| Opus 5, Standard | 11/12 | 5 | 7 | 666 | 0.0519 |
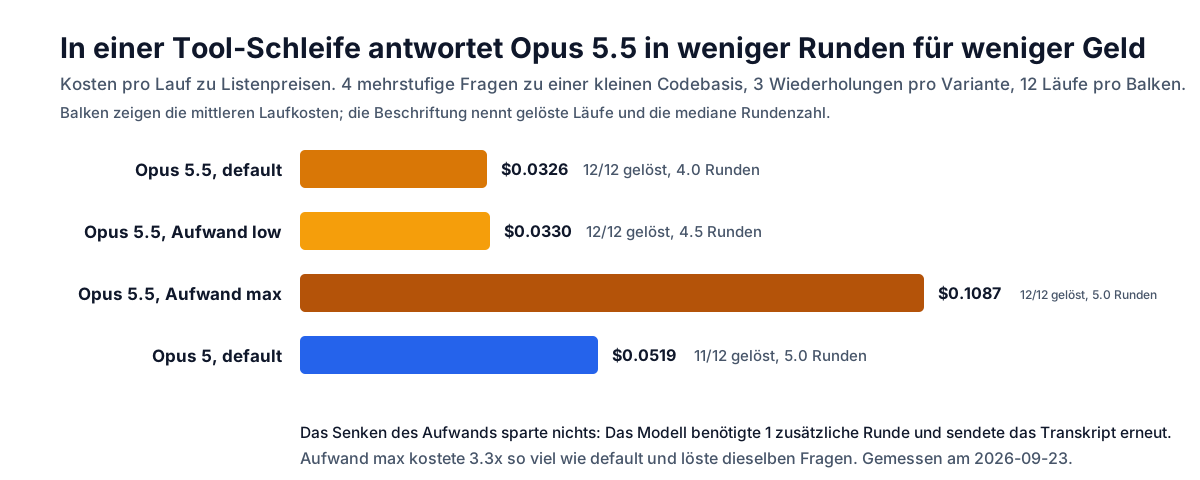
Opus 5.5 kostete mit der Standardeinstellung pro Lauf 37% weniger als Opus 5. Gleichzeitig benötigte es 12% weniger Turns und 30% weniger Output-Token. Pro gelöster Frage liegt der Abstand bei 43%, weil Opus 5 einen Lauf nicht löste. Das kommt der Herstellerangabe von “40% geringeren Betriebskosten” nahe und entspricht dem Unterschied auf der Rechnung.
Bei diesem Workload stammt der größte Teil der Ersparnis allerdings aus den niedrigeren Listenpreisen. Der Grund liegt in der Struktur eines Loops: Das Transkript wird bei jedem Turn erneut gesendet, beide Modelle lesen dieselben Dateien und die Gesamtzahl der Token sank nur um 19%, während die Output-Token um 30% zurückgingen. Gerade bei den teuersten Workloads bringt kürzerer Output am wenigsten. Der nächste Abschnitt beziffert diesen Effekt.
Die Senkung von Opus 5.5 auf low sparte im Loop nichts. Das Modell benötigte im Durchschnitt einen zusätzlichen Turn. Das dabei erneut gesendete Transkript verbrauchte die eingesparten Token vollständig. Bei Single-Shot-Aufgaben lässt sich der Effort gut zur Kostensteuerung einsetzen. Im Loop funktioniert das nicht mehr, weil die Anzahl der Turns und nicht die Reasoning-Tiefe die Rechnung bestimmt.
Wie viel der Ersparnis stammt nur aus der Preissenkung?
Je nach Workload zwischen einem Siebtel und zwei Fünfteln. In der mittleren Spalte werden die gemessenen Token von Opus 5.5 mit den Preisen von Opus 5 neu berechnet. Sie zeigt damit, wie viel Opus 5.5 allein durch kürzeren Output gegenüber Opus 5 spart.
| Workload | Abgerechneter Unterschied | Bei identischen Preisen | Output-Token |
|---|---|---|---|
| 13 Single-Shot-Aufgaben, Standard | -65% | -56% | -57% |
| die fünf schwierigsten davon | -70% | -62% | -63% |
| mehrstufiger Tool-Loop, Standard | -37% | -22% | -30% |
Die Single-Shot-Ergebnisse zeigen einen echten Effizienzgewinn. Nur 14% der Ersparnis stammen aus der Preissenkung, der Rest aus dem kürzeren Output des Modells. Für die Kapazitäts- und Kostenplanung ist die Zeile zum Tool-Loop wichtiger, weil Agent-Traffic meist diesem Muster folgt. Dort liefert die Preissenkung 41% der ausgewiesenen Ersparnis.
Lohnt sich eine höhere Effort-Stufe jemals?
Bei diesem Workload nicht, und der Aufpreis ist erheblich. Opus 5.5 kostete im Tool-Loop mit max $0.1087 pro Lauf, also 3.3x so viel wie mit der eigenen Standardeinstellung. Gelöst wurden exakt dieselben 12 Fragen. Das zusätzliche Budget floss in Tool-Aufrufe: Der Median lag bei 12 statt 5 mit der Standardeinstellung. Gleichzeitig stiegen die Output-Token von 427 auf 3,124. Bei den Single-Shot-Aufgaben war max die einzige Stufe, auf der Opus 5.5 mehr als Opus 5 kostete: $0.0240 statt $0.0220.
Das Budget fließt in Reasoning. Bei diesen Aufgaben mit jeweils einer einzelnen Antwort entfielen mit der Standardeinstellung 98.4% der Output-Token von Opus 5.5 auf Thinking, bei max waren es 99.6%. Alle diese Token werden zum Outputpreis abgerechnet, obwohl sie mit der standardmäßigen Anzeigeeinstellung nicht sichtbar sind. Anthropic empfiehlt selbst, max nur für Aufgaben an der Leistungsgrenze zu verwenden. Unsere Messung zeigt: Bei Aufgaben, die das Modell bereits löst, verursacht jede höhere Stufe ausschließlich Mehrkosten.
Was geht beim Wechsel der Modell-ID kaputt?
Zwei Request-Formen, die mit Opus 5 funktionieren, liefern bei Opus 5.5 einen 400-Fehler. Beide kommen in bestehendem Code häufig vor.
Erzwungene Tool-Nutzung wird abgelehnt. Clients, die einen Tool-Aufruf fest vorgeben, um strukturiertes JSON aus einem Chat-Modell zu erhalten, bekommen folgende Antwort:
tool_choice: type "tool" and "any" are not supported for this model.Der Fehler tritt auch über einen OpenAI-kompatiblen Client auf. Dort wird derselbe Request als tool_choice: "required" oder als benannte Funktion formuliert. auto und none funktionieren weiterhin. Bei der Migration sollte deshalb im Prompt beschrieben werden, wann das Tool einzusetzen ist. Für schemakonformes JSON eignen sich strikte Tool-Schemas oder Structured Outputs.
Thinking lässt sich nicht abschalten. Sowohl thinking: {"type": "disabled"} als auch ein manuelles budget_tokens schlagen fehl. Auf einer OpenAI-kompatiblen API-Oberfläche wird auch die entsprechende Variante reasoning_effort: "none" abgelehnt. Als Ersatz dient der Effort-Parameter:
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=4096,
    messages=[{"role": "user", "content": "Summarize this incident report in five bullets."}],
    output_config={"effort": "low"},   # low | medium | high | xhigh | max; medium is the default
)

# Thinking is billed as output whether or not you can read it.
print(response.usage.input_tokens, response.usage.output_tokens)
low kommt dem früheren Betrieb ohne Thinking am nächsten. In unserem Single-Shot-Test war es zugleich die günstigste Stufe und lieferte korrekte Ergebnisse. Thinking ist damit jedoch weder deaktiviert noch kostenlos: Das Modell denkt weiterhin nach, und die Thinking-Token werden weiterhin als Output abgerechnet.
Lassen sich Prompt-Budgets unverändert übernehmen?
Token-Budgets lassen sich unverändert übernehmen. Dieselben vier Inputs wurden bei beiden Modellen nahezu identisch gezählt: 1,277 statt 1,275 Token für einen englischen Text, 583 statt 581 für Python, 482 statt 480 für ein JSON-Objekt mit Tool-Argumenten und 500 statt 498 für chinesischen Text. Der konstante Unterschied von zwei Token entsteht durch das Request-Framing und nicht durch den Text. Ein auf Opus 5 abgestimmtes Kontextbudget oder ein Chunking-Grenzwert muss für Opus 5.5 deshalb nicht neu kalibriert werden.
Wann sollte man wechseln?
Aus Kostensicht lohnt sich der Wechsel zu Opus 5.5, sobald die beiden genannten Request-Formen angepasst sind. Selbst ohne den Vorteil der niedrigeren Listenpreise sind 56% geringere Kosten bei gleicher Genauigkeit für Single-Shot-Aufgaben und 22% in einem Tool-Loop kein kleiner Unterschied. Für die meisten Deployments ist außerdem der Vergleich der jeweiligen Standardeinstellungen am relevantesten.
Effort sollte neu abgestimmt und nicht unverändert übernommen werden. Die Standardeinstellung wurde von high auf medium geändert, und die Kostenspanne ist viermal so groß wie bei Opus 5. Die optimale Stufe hängt vom Workload ab: Bei Single-Shot-Aufgaben war low am günstigsten und weiterhin genau. Im Tool-Loop schnitt die Standardeinstellung besser ab als low und max.
FAQ
Ist Claude Opus 5.5 wirklich 40% günstiger als Opus 5? Auf der Rechnung kommt das ungefähr hin: In unserem Tool-Loop kostete Opus 5.5 pro Lauf 37% weniger als Opus 5, bei Single-Shot-Aufgaben waren es 65% weniger pro Aufgabe. Zwanzig Prozentpunkte davon stammen aus den niedrigeren Listenpreisen und gelten unabhängig vom Modellverhalten. Nach Abzug dieses Preisvorteils bleiben 22% Effizienzgewinn im Loop und 56% bei Single-Shot-Aufgaben.
Kann ich Thinking bei Opus 5.5 weiterhin deaktivieren?
Nein. thinking: {"type": "disabled"} und manuelle Token-Budgets liefern bei Opus 5.5 beide einen 400-Fehler. Verwende stattdessen output_config.effort. low ist die günstigste Einstellung. Thinking-Token werden auf jeder Stufe als Output abgerechnet.
Was ersetzt die erzwungene Tool-Nutzung?
Behalte tool_choice: {"type": "auto"} bei und beschreibe im Prompt eindeutig, wann das Tool aufzurufen ist. Wenn schemakonformes JSON erforderlich ist, verwende strikte Tool-Schemas oder Structured Outputs. Bei Opus 5.5 werden any und benannte Tools mit einem 400-Fehler abgelehnt und nicht stillschweigend herabgestuft. Das Ergebnis ist also ein fehlgeschlagener Request und keine falsche Antwort.
Muss ich meine Prompt-Größen neu messen? Nein. Identische Texte wurden bei Opus 5 und Opus 5.5 für Fließtext, Code, JSON und Chinesisch mit identischen Tokenzahlen abgerechnet. Kontextbudgets können unverändert übernommen werden.
Ist Opus 5.5 ein Ersatz für Fable 5.1? In der Benchmark-Tabelle von Anthropic liegt Opus 5.5 bei jedem aufgeführten Benchmark vor Fable 5.1, und das bei 40% des Tokenpreises. Anthropic positioniert Fable 5.1 weiterhin für anspruchsvolles Reasoning und langfristige agentische Aufgaben. Außerdem sei der Unterschied in der Praxis kleiner, als die Werte vermuten lassen. Eine belastbare Entscheidung erfordert deshalb eigene Evals statt einer Bewertung allein anhand der Tabelle.
Verwandte Messungen: Claude Opus 5 im Vergleich zu Opus 4.8, die Effort-Skala von GPT-6 Astra und Thinking-Steuerung bei verschiedenen Anbietern.
Gemessen am 2026-09-23, einen Tag nach der Veröffentlichung, über ein Gateway zur Claude API und eine OpenAI-kompatible API-Oberfläche. 468 bewertete Single-Shot-Aufrufe (13 Aufgaben mit lokal per Brute Force berechneten Lösungen, 3 Wiederholungen, 6 Effort-Einstellungen, 2 Modelle) plus 48 Tool-Loop-Läufe (4 mehrstufige Fragen, 3 Wiederholungen, 4 Varianten). Prompts wurden mit Zufallswerten versehen. Jedes Modell wurde über die API-Oberfläche angesprochen, die seinen Effort-Parameter unterstützte. Die Kosten wurden anhand der Listenpreise von Anthropic berechnet und nicht aus den Responses übernommen.