
提示词 A/B 测试:10% 灰度发现成本升至 1.9 倍
按会话将10%的生产流量分配给新版提示词,并以会话为单位固定版本。实测200个会话中有8.0%命中新版,即16个会话,其余184个使用原版;实际占比较目标低2个百分点,所有会话均未切换版本。新版单次调用成本为原版的1.94倍,即增加94%。
我们的推荐
实时价格| 模型 | 结论 | 价格 |
|---|---|---|
| GPT-6 Luna 在此次上线的 1,272 次调用中,support-answer 的 v1 每次调用成本为 $0.000110,延迟中位数为 4.9 s。将 reasoning_effort 设为 none 时,成本为 $0.000034。 | 演示中的生产版本 | 低至 $0.1/百万 |
| DeepSeek V4.1 Flash v3 在此模型上使用相同提示词,回答更快(延迟中位数为 3.1 s),但每次调用成本为 $0.000213,是 v1 的 1.94 倍,因为它生成的输出 token 数是 v1 的 1.6 倍,且每个 token 的价格更高。 | 演示中的候选版本 | 低至 $0.3/百万 |
目录
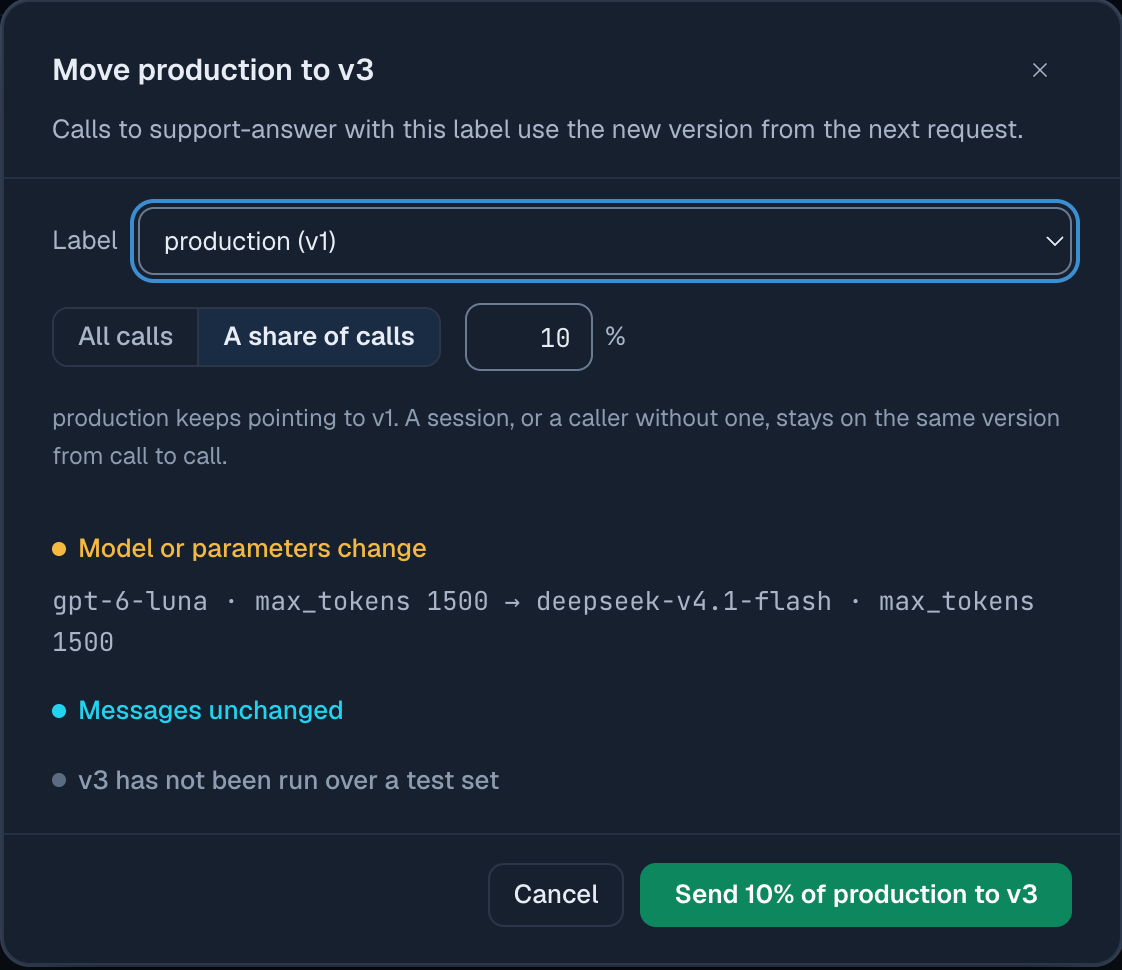
提示词灰度发布会把同一提示词 ID 下的部分调用分配给候选版本,其余调用继续使用生产版本。这样就能在全量切换前,用真实流量比较两个版本。在 Synthorai 提示词库中,灰度配置设在 production 标签上,例如“v1,v3 占 10%”。网关根据会话 ID 为每次调用选择版本,确保对话不会中途切换版本。本次测试将灰度比例设为 10%,200 个会话中有 16 个(8.0%)分配到了候选版本,所有会话都始终使用同一版本。候选版本换用了另一个模型,此前没人测过这一改动的成本。仅看 10% 灰度阶段的分版本统计,就发现候选版本的单次调用成本是原版的 1.92 倍。
TL;DR
- 灰度比例为 10% 时,200 个会话中有 16 个(8.0%,95% 置信区间为 5.0% 至 12.6%)使用候选版本;比例为 50% 时,则有 111 个(55.5%)。
- 全部 400 个三轮会话都始终使用同一提示词版本;通过
_user、请求体中的user或safety_identifier标识的每个终端用户也都如此。 - 候选版本将同一提示词的模型从 GPT-6 Luna 换成 DeepSeek V4.1 Flash,单次调用成本从 $0.000110 升至 $0.000213,延迟中位数从 4.9 s 降至 3.1 s。
- 固定使用
prompt_version=1的调用没有任何一次被分配到候选版本:40 次中为 0 次。
本文接着提示词版本管理的示例继续,前文已配置好两个提示词及其版本。在 github.com/synthorai-io/use-cases 的同一目录下运行:
cd use-cases/prompt-library
python rollout.py       # 10%, then 50%, then stops the rollout
python effort.py        # each version with and without a caller-sent reasoning_effort
灰度测试于 2026 年 10 月 19 日运行,共发起 1,840 次调用;终端用户分流检查于 10 月 20 日运行。生产版本是 support-answer 的 v1,使用 GPT-6 Luna。候选版本是 v3,系统文本和消息完全相同,但使用 DeepSeek V4.1 Flash,因此唯一的变化是模型。
如何将 10% 的生产流量分配给新版本?
为 production 标签指定第二个版本及其流量占比即可。有管理员密钥时,一次调用就能开启,另一次调用即可停止:
import os
import httpx

admin = httpx.Client(base_url="https://synthorai.io/api/v1",
                     headers={"Authorization": f"Bearer {os.environ['SYNTHORAI_PROMPTS_ADMIN_KEY']}"})

admin.put("/prompts/support-answer/labels/production/rollout", json={"version": 3, "percent": 10})
# ... compare the two versions ...
admin.delete("/prompts/support-answer/labels/production/rollout")   # production is v1 only again
调用方不需要改动:继续调用 support-answer,不指定版本即可。响应头 X-Synthorai-Prompt-Version 会给出每次调用实际使用的版本。要将候选版本全量上线,只需把 production 标签移到该版本,灰度便会结束。在控制台中,对应设置是候选版本页面上的“逐步发布”,设置后提示词列表会将标签显示为“production v1 · v3 10%”。
哪些调用会分配给候选版本?
网关根据每次调用携带的稳定标识选择版本。只要流量占比不变,相同标识就始终对应同一版本。标识按以下顺序取第一个可用值:
- 会话 ID,即
X-Session-Id,也就是追踪 LLM 智能体中使用的请求头; - 终端用户标识:先取
X-Synthorai-Metadata中的_user标签,否则依次取请求体中的user、safety_identifier或 Anthropic 的metadata.user_id; - 如果以上标识都没有,就以请求本身为依据,每次调用独立分配。
rollout.py 分别在 10% 和 50% 的比例下检查了这些情况。每个会话包含 3 轮交互,每个终端用户发起 2 次调用:
| 调用 | 10% 时分配到 v3 | 50% 时分配到 v3 | 始终使用同一版本 |
|---|---|---|---|
200 个会话,使用 X-Session-Id | 16 = 8.0%(5.0% 至 12.6%) | 111 = 55.5%(48.6% 至 62.2%) | 400 个会话中有 400 个 |
50 个终端用户,使用 _user 标签 | 6 | 27 | 100 个用户中有 100 个 |
| 100 次调用,两种标识都不带 | 11 = 11.0%(6.3% 至 18.6%) | 49 = 49.0%(39.4% 至 58.7%) | 不适用 |
20 次调用,固定使用 prompt_version=1 | 0 | 0 |
括号内为 95% 置信区间,表示在这一试验次数下真实占比可能落入的范围;所有区间都包含设定的比例。另一次测试在 50% 的比例下检查了两个请求体字段:50 个用户只通过请求体中的 user 字段标识,20 个只通过 safety_identifier 标识,每人调用 2 次。全部 70 个用户都始终使用同一版本,其中前 50 个用户有 25 个分配到 v3,后 20 个用户有 8 个分配到 v3。
实际灰度时需要注意两点。多轮对话依赖会话 ID 来保持版本一致,因此同一对话的每次调用都应携带会话 ID;如果不带任何标识,同一用户可能上一次用 v1,下一次就用 v3。通过 prompt_version 固定版本的调用则不参与灰度:测试或批处理任务只要指定了版本,就会一直使用该版本。
如何比较两个版本?
Prompts 页面按版本汇总调用数、错误数、费用、token 数和延迟。Requests API 通过 prompt_id 和 prompt_version 筛选,也能返回相同指标。示例在灰度结束后读取了这些数据:
| 版本 | 请求数 | 费用 | 单次调用费用 | 延迟中位数 | 单次调用输出 token 数,均值 | 单次调用推理 token 数,均值 |
|---|---|---|---|---|---|---|
| v1,GPT-6 Luna | 1,272 | $0.1405 | $0.000110 | 4.9 s | 198 | 149 |
| v3,DeepSeek V4.1 Flash | 568 | $0.1208 | $0.000213 | 3.1 s | 321 | 256 |
推理 token 是模型在作答前用于思考的 token。它们按输出 token 计费,但不会显示在答案中。
提示词的 Calls 页签也会显示这类汇总。其 7 天统计覆盖每个版本的所有示例调用,而不仅是本次灰度调用,因此数值比表中更大。
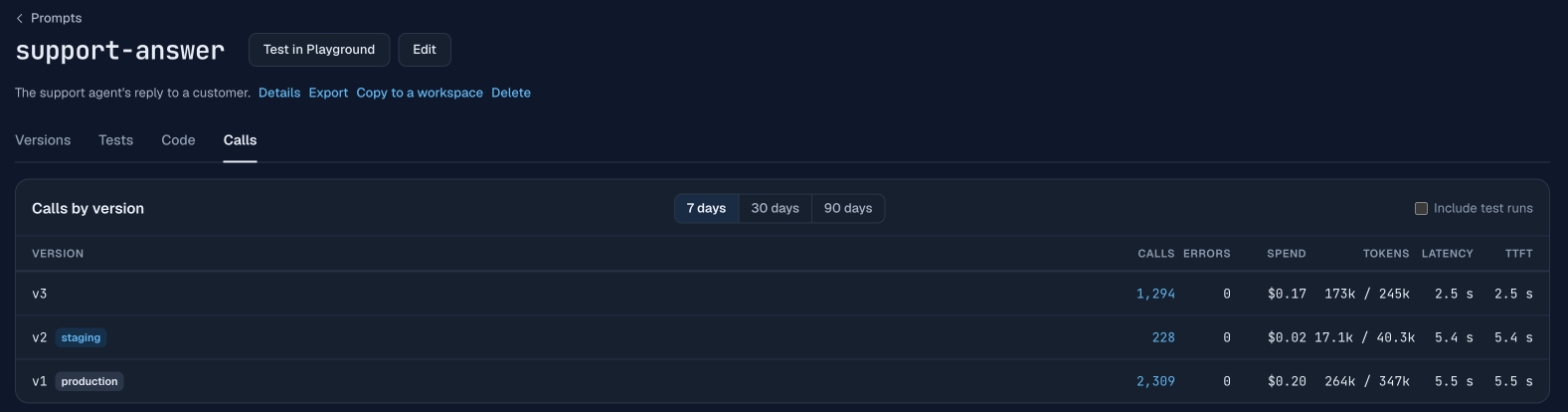
整个测试中,v3 更快,但单次调用成本是 v1 的 1.94 倍。这由两个因素共同造成。首先,在该网关上,DeepSeek V4.1 Flash 的 token 单价高于 GPT-6 Luna:低峰时段每百万输入和输出 token 分别为 $0.15 和 $0.60,而 GPT-6 Luna 分别为 $0.10 和 $0.50。其次,v3 的输出 token 数是 v1 的 1.6 倍,差额几乎都来自推理:每次调用的推理 token 数分别为 256 和 149,答案本身则分别为 65 和 48 个 token(中位数)。这些数值都无法从提示词文本中看出来。仅在 10% 灰度阶段,差距就已经出现:v3 的 71 次调用平均每次花费 $0.000212,v1 的 749 次调用平均每次花费 $0.000111,前者为后者的 1.92 倍。
价格还取决于调用时段。本次灰度的所有 DeepSeek 调用都发生在网关为该模型设置的低峰时段,即北京时间 22:00 至 08:00,费用为高峰价格 $0.30 和 $1.20 的一半。10 月 20 日的 140 次调用发生在高峰时段,其中 v3 和 v1 分别调用了 66 次和 74 次,单次费用分别为 $0.000394 和 $0.000107,前者为后者的 3.7 倍。
1,840 次调用中,1,839 次返回了 200。有 1 次在 300 s 后于客户端超时,计为错误;该调用所属会话的其他轮次仍正常完成。
关闭推理会改变结果吗?
两个版本的成本都会降低至少三分之二,但 v3 仍然更贵。effort.py 对每个版本分别调用了 50 次不带 reasoning_effort 的请求,以及 50 次由调用方传入 reasoning_effort: "none" 的请求。输入使用上线前测试提示词中测试集的客户消息,每条消息都包含订单号(共 40 条消息,其中 10 条使用两次):
| 版本 | reasoning_effort | 单次调用成本 | 输出 token 数,均值 | 延迟中位数 | 答案包含订单号 | 被判定为回答了问题 |
|---|---|---|---|---|---|---|
| v1,GPT-6 Luna | 默认 | $0.000107 | 192 | 4.8 s | 50/50 | 37/50 |
| v1,GPT-6 Luna | none | $0.000034 | 45 | 1.8 s | 50/50 | 35/50 |
| v3,DeepSeek V4.1 Flash | 默认 | $0.000200 | 300 | 3.2 s | 50/50 | 43/50 |
| v3,DeepSeek V4.1 Flash | none | $0.000049 | 55 | 1.7 s | 50/50 | 39/50 |
“none” 在两个模型上都完全关闭了推理,使 v1 的单次调用成本降低 68%,v3 降低 75%。在 50 次调用能反映的范围内,答案质量没有明显变化:所有答案仍包含订单号;由模型评判的检查结果,即调用 Claude Sonnet 5.5 判断回复是否回答了客户问题,在每组 50 次中分别变化了 2 次和 4 次,Fisher 精确检验得到的 p 值分别为 0.82 和 0.44。Fisher 精确检验计算的是:假设“none”没有影响,出现至少这么大差异的概率。如此高的值说明,这一变化可以用随机波动解释。两者都设置为“none”后,v3 的单次调用成本仍是 v1 的 1.44 倍($0.000049 对比 $0.000034)。这些调用也发生在网关的 DeepSeek 低峰时段。
灰度期间,调用方不知道请求会由哪个版本处理,因此传入的 reasoning_effort 会同时作用于两个版本。也可以把推理设置存到版本上:版本可保存 reasoning_effort,调用本身未指定推理设置时,网关会将其写入 Chat Completions 和 Responses 请求。这样保存的候选版本在灰度时会使用自己的设置,分版本统计比较的也就是两个版本按实际上线配置运行时的表现。
测试运行会干扰比较吗?
默认不会,因为 Prompts 页面上的版本汇总不包含测试流量:Playground 调用,包括控制台的测试运行,以及在 X-Synthorai-Metadata 中标记了 source: prompt-test 或 source: eval 的调用。开启“包含测试运行”后才会计入。对于 support-answer,开启后 v1 和 v2 各增加了 150 次调用,分别来自带标签的评测运行各 110 次,以及控制台测试运行各 40 次;v3 没有变化。日志和 Requests API 仍会列出所有调用,因此如果灰度期间运行了评测,需要在那里按标签筛选:
X-Synthorai-Metadata: {"source":"eval"}本文未覆盖哪些内容?
- 成本与延迟的统计检验。上面的分版本表格比较了总量和均值,但没有对差异做统计检验。根据差异采取行动前,应先检验,尤其是差异较小时。
- 真实流量上的答案质量。灰度可以告诉你一个版本的成本和速度。答案是否正确,更适合在灰度前用固定输入集检查;上线前测试提示词对 v2 做了这项检查。
- 自动停止。示例没有实现候选版本错误率或成本超限时自动结束灰度。管理员需要手动调整比例、将标签移到候选版本,或停止灰度。
常见问题
如何在生产环境中对提示词做 A/B 测试?
为生产标签设置候选版本及其流量占比,继续像以前一样通过提示词 ID 调用,再比较两个版本各自的汇总指标。示例中,10% 的比例将 200 个会话中的 16 个分配给了候选版本,几百次调用后的汇总数据就显示出了成本差异。
灰度能保证每段对话始终使用同一版本吗?
只要对话的调用携带会话 ID,灰度就能让它始终使用同一版本。示例中的全部 400 个会话,在各自的三轮交互中都没有切换版本。如果没有会话 ID,就使用终端用户标识;两者都没有时,每次调用独立分配。
不改提示词文本,也可能增加成本吗?
即使文本不变,切换模型也可能增加成本,本例就是如此。使用 DeepSeek V4.1 Flash 的候选版本,单次调用成本是 GPT-6 Luna 版本的 1.94 倍,因为前者在该网关上的 token 单价更高,推理消耗的 token 也更多。应比较整个版本的单次调用成本,而不只是模型单价。
相关阅读
- 提示词版本管理:通过 ID 调用提示词,以及移动标签。
- 上线前测试提示词:测试集与检查项,并比较 v2 和 v1。
- 为什么我的 LLM 智能体这么贵?:通过追踪数据发现的另外四种高费用原因。
- 提示词库指南:灰度发布、分版本统计及所有字段。