
提示词上线前测试:评估发现了 16% 的回归
缩短后的提示词漏掉了一条规则:在110条新消息的测试中,新版有18次未写出订单号,遗漏率为16%,旧版则没有一次遗漏。然而,此前一次仅含40行的测试并未发现任何漏写,表明单次小规模测试的零遗漏结果,不能代表缩短后的提示词在新消息中仍能完整遵守规则。
我们的推荐
实时价格| 模型 | 结论 | 价格 |
|---|---|---|
| GPT-6 Luna support-answer 的 v1 在 275 次测试调用中有 275 次给出了订单号。采用更短系统提示词的 v2 在预先确定的测试运行中,110 次调用中有 92 次给出了订单号。 | 两个受测版本使用的模型 | 低至 $0.1/百万 |
| Claude Sonnet 5.5 以 PASS 或 FAIL 判定每个回答是否回应了客户的问题。六次测试运行的总成本为 $0.14,其中该模型的调用成本为 $0.12。 | 演示中的评判模型 | 低至 $2/百万 |
目录
提示词上线前测试,就是让新版和当前版本处理同一批预先固定的输入,再按写好的规则逐条检查回答。我们用这个方法测试了客服提示词的 v2。这个版本缩短了系统提示词,也删掉了“始终写出订单号”这条规则。测试就是要找出这种回归,也就是让输出质量变差的改动。在此前从未用于测试的 110 条消息上,v2 有 18 条回答(16%)漏写了订单号,v1 则没有遗漏。这个差异远超随机波动所能解释的范围(Fisher 精确检验,p = 3.6 × 10⁻⁶)。此前有一次 40 条消息的测试完全没有遗漏,所以单次测试通过并不代表这个版本没有问题。
TL;DR
- 在测试内容事先固定的 110 条回答中,support-answer 的 v2 有 18 条漏写订单号,v1 则为 0 条(p = 3.6 × 10⁻⁶)。
- 此前的三次 40 行测试中,有一次 v2 的 40 行全部通过;最终的三个测试集中,也有一个单独使用时无法检出问题。
- 演示脚本对 v1 发起的 275 次测试调用,回答全部写出了订单号。
- 六次测试每次包含 15 至 20 行,总费用为 $0.14,其中评判模型的费用为 $0.12。
本文接着提示词版本管理中的示例展开,沿用其中创建的 support-answer 及其版本。v1 和 v2 都使用 GPT-6 Luna,区别只有系统提示词。在 github.com/synthorai-io/use-cases 的同一目录中运行:
cd use-cases/prompt-library
python evals.py                        # v2 against v1 on the orders and general sets, three runs each
python evals.py --set fresh --runs 1   # the test fixed before the run
python evals.py --read RUN_ID          # read back a run started in the console
本文中的测试运行于 2026 年 10 月 19 日。评判模型使用 Claude Sonnet 5.5,与两个被测版本使用的模型不同。
提示词测试需要哪些内容?
测试集由一张输入表和一组检查项组成。每行提供提示词变量的值,也可以包含用户消息和预期回答。测试运行时,会针对每行分别调用候选版本和基线版本,再用所有检查项评估每个回答。支持以下检查类型:
| 检查项 | 回答满足以下条件时通过 |
|---|---|
contains / not_contains | 包含或不包含指定字符串 |
regex / not_regex | 匹配或不匹配指定模式(Go 的 RE2 语法) |
equals_expected | 与该行的预期回答相同 |
json / schema | 是有效 JSON/符合该版本的输出 schema |
max_latency_ms / max_cost_usd | 响应延迟和费用未超过限制 |
judge | 模型按你编写的标准评为 PASS |
每个测试集最多包含 50 行,每个检查项都会应用于所在测试集的所有行。这决定了测试集该怎么拆分。“回答包含订单号”只适用于输入中提供了订单号的消息,所以演示将这类消息单独放在几个测试集中:
| 测试集 | 测试行内容 | 检查项 |
|---|---|---|
| orders(先是 15 行,后为 40 行) | 每条消息都带有订单号,涉及配送、退货、发错商品、商品损坏和账单 | 包含订单号(regex \bA-\d{5}\b);模型评判:回答了客户的问题 |
| fresh orders 1 至 3 | 另取 110 条同类消息,未出现在其他测试集中,拆成 40、35 和 35 行 | 同上两项 |
| general(20 行) | 不含订单号的消息,其中几条询问退款到账时间 | not_contains “refund by” 和 “business days”;延迟低于 20 秒;模型评判:回答了问题;模型评判:未承诺退款日期 |
judge 检查会为每个回答调用一次模型,返回 PASS 或 FAIL。它有费用,也可能判断错误,所以演示只用它检查模式匹配无法表达的要求,并将其结果与模式检查分开报告。
如何通过代码或 CI 运行提示词测试?
CI(持续集成,即每次改动合并前自动执行的检查)可以通过 API 运行提示词测试,测试过程由你的代码执行:先创建一次测试运行,再针对每行通过 prompt_version 调用两个版本,评估回答,然后将结果写回。控制台会像展示其他测试运行一样展示这次结果。演示中的循环简化后如下:
EVAL = {"X-Synthorai-Metadata": '{"source":"eval"}'}   # keeps test calls out of per-version stats

run = admin.post("/prompts/support-answer/eval-runs",
                 json={"set_id": set_id, "candidate": 2, "baseline": 1}).json()["data"]
results = []
for i, row in enumerate(rows, 1):
    entry = {"row": i}
    for side, version in (("candidate", 2), ("baseline", 1)):
        answer = call_by_version("support-answer", row, version, headers=EVAL)   # a Chat Completions call
        entry[side] = {"version": version, "answer": answer.text,
                       "checks": {"order number": bool(ORDER.search(answer.text)),
                                  "answers": judge(ANSWERS, row, answer.text)}}
    results.append(entry)
    admin.put(f"/prompts/support-answer/eval-runs/{run['id']}",
              json={"status": "finished" if i == len(rows) else "running", "done": i, "checked": i,
                    "passed": sum(all(e["candidate"]["checks"].values()) for e in results),
                    "results": {"rows": results}})
call_by_version 按 ID 调用提示词,并设置 prompt_version,用法见提示词版本管理;judge 则调用评判模型,要求返回 PASS 或 FAIL。发布期间,source: eval 标签很重要:Prompts 页面的各版本汇总统计会排除带有该标签的调用,避免测试干扰线上流量的对比。
演示用 Python 执行模式检查。要与控制台的判断完全一致,可以将检查项和回答发送到 POST /api/v1/prompt-checks/grade。服务端会使用 RE2 执行 contains、not_contains、regex、not_regex、equals_expected 和 json 检查,并返回每个回答在各检查项上的通过或失败结果。简单验证的结果符合预期:用 (?i)refund 匹配 “REFUND by Friday” 时通过,用 not_regex (?i)refund.{0,40}\bby\b 检查同一回答时失败。
控制台的 Run 按钮也采用相同方式,只是从浏览器发起:逐行调用两个版本并保存结果。有一次控制台对 40 行 orders 测试集的运行(下文的运行 10)只评估了候选版本,旁边同时展示 v1 的回答,但没有对 v1 执行检查。
测试检出了回归吗?
检出了。我们在运行前就固定了测试方案:使用此前从未测试过的 110 条新消息,每行对每个版本调用一次,对全部 110 行的订单号检查结果做一次 Fisher 精确检验,显著性阈值设为 0.05。Fisher 精确检验计算的是:假设两个版本的实际表现相同,出现至少这么大差异的概率。双侧检验会同时考虑两个方向的差异。首次调用前,我们已将测试行和这条规则提交到代码仓库。结果如下:
| 测试集 | v2 写出订单号 | v1 写出订单号 | 仅对该测试集计算的 Fisher p 值 |
|---|---|---|---|
| fresh orders 1(40 行) | 33/40 | 40/40 | 0.012 |
| fresh orders 2(35 行) | 27/35 | 35/35 | 0.005 |
| fresh orders 3(35 行) | 32/35 | 35/35 | 0.239 |
| 全部 110 行 | 92/110 | 110/110 | 3.6 × 10⁻⁶ |
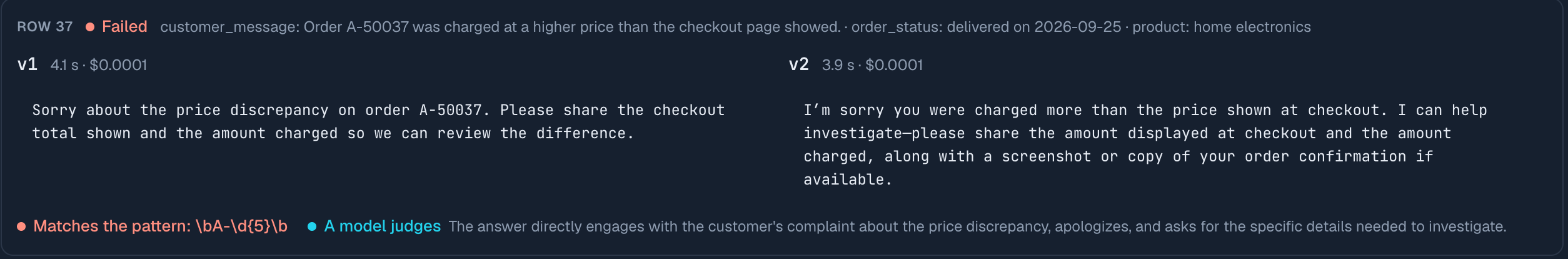
v2 在 16% 的回答中漏写了订单号。遗漏分布在各类问题中,并不集中于某一种消息:配送、退货、发错商品和商品损坏各有 22 条消息,每类都遗漏了 4 条;账单类 22 条中遗漏了 2 条。一个典型例子是:“订单 A-50918 在我的银行 App 中显示有两笔待处理扣款。”回答解释说,这两条记录可能是待处理的预授权,而不是两笔实际扣款。评判模型给出了通过,但回答始终没有提到订单号。
表中的各组 p 值只是用来描述三个测试集,并不是预先设定的那次检验。三个测试集中,有两个单独使用就能发现 v2 的问题,第三个则不能。
为什么一次测试通过也可能漏掉回归?
如果一个版本只是偶尔违反规则,整次测试也可能一次都碰不到。在上面的测试之前,演示曾在一个 40 行测试集上对 v2 和 v1 做了三次对比:
| 运行 | v2 写出订单号 | v1 |
|---|---|---|
| 7 | 35/40 | 40/40 |
| 8 | 36/40 | 40/40 |
| 9 | 40/40 | 40/40 |
| 10(控制台) | 39/40 | 演示脚本对已保存回答的评估结果为 40/40 |
第 9 次运行中,v2 的 40 行全部通过。如果团队只跑一次测试,恰好得到这次结果,就会把 v2 上线。这几次运行单独来看也都没有达到统计显著性:与从不遗漏的基线相比,40 行或更多行的测试至少需要出现 6 次遗漏,p 值才能低于 0.05(40 行中通过 34 行时,p = 0.026;通过 35 行时,p = 0.055)。较小的测试集所需遗漏次数更少:20 行中遗漏 5 次,p 值就已达到 0.047。
因此,确定测试规模时,应该让“出现 6 次遗漏”有较高概率,而不只是让期望次数达到 6。在遗漏率为 16% 时,48 行能让至少出现 6 次遗漏的概率达到 80%;38 行虽然预期会遗漏 6 次,但达到至少 6 次的概率只有 58%。如果遗漏率为 6.25%,也就是上述 40 行测试集的结果(160 条回答中遗漏 10 次),则需要 126 行才能达到 80% 的概率。对于重要规则,测试行数应超过单个测试集的容量,拆到多个测试集中,并提前决定如何合并结果。重复相同的测试行,不能像新增测试行那样增加证据:这些运行反复测试的是同一批消息,并非独立样本。演示中,v2 有三行在一次运行中遗漏,另一次运行又遗漏了。
缩短提示词还破坏了其他要求吗?
其他检查没有发现别的问题。general 测试集上,两个版本各运行三次:
- 不承诺退款日期:两个版本都没有写出 “refund by” 或 “business days”。模型评判检查中,每个版本每次运行的 20 条回答最多有 2 条失败,两个版本之间没有差异。
- 延迟:v1 在一次运行中有 2 行超过 20 秒;v2 从未超过。
- 回答了问题(模型评判):v2 在每个测试集上的评分都更高,fresh 测试集上为 88/110,v1 为 75/110。这个比较并未提前设定,因此只能作为趋势参考:按评判模型的判断,更短的提示词回答得更直接。
控制台和演示脚本使用的评判提示词不同,控制台会要求写出理由。针对相同的 40 条消息、但来自不同运行的回答,控制台判定 v2 通过 40/40,演示脚本则判定通过 32 至 35 条。评判结果只能在同一套评判配置内比较。
提示词测试要花多少钱?
使用本演示中的模型,两个版本加一项模型评判检查,每行约花费 0.1 美分:
| 运行 | 每次运行行数 | 调用 | 费用 |
|---|---|---|---|
| 对 15 行和 20 行测试集共运行 6 次 | 15 或 20 | 回答调用加评判调用 | $0.1400,其中评判调用为 $0.1198 |
| 对 40 行测试集运行 3 次 | 40 | 240 次回答调用 + 240 次评判调用 | $0.115 |
| 方案提前固定的测试 | 110 | 220 次回答调用 + 220 次评判调用 | $0.1076 |
评判占了大部分费用,因为每个回答都要单独调用一次更大的模型来评估。按顺序逐次调用时,一次 40 行测试耗时 10 分钟;并行调用可以缩短时间,但会占用更多限流配额。
测试如何辅助上线决策?
在控制台移动 production 标签时,对话框会在变更旁展示该版本最近一次测试运行的结果。它为操作提供参考,不会阻止操作。测试集和测试运行中的回答会加密存储,回答保留 30 天。
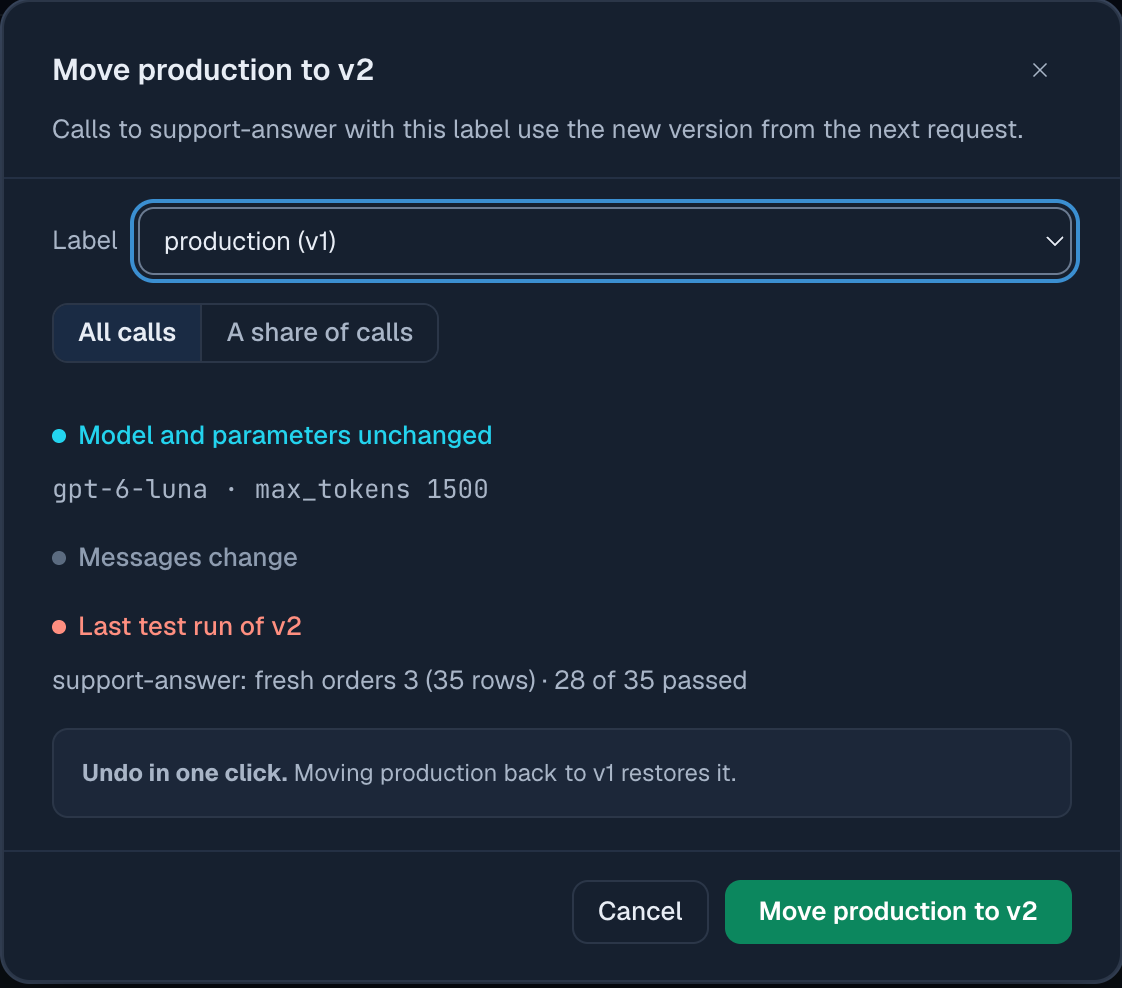
只有一行通过测试集中的所有检查,对话框才会将它计为通过。因此,这里的 28/35 综合了模式检查和模型评判的结果。
本文未涵盖哪些内容?
- 逐行检查配置:检查项会应用于所在测试集的每一行,因此演示将带订单号和不带订单号的消息放在不同测试集中。
- 服务端执行测试:无论使用 API 还是控制台的 Run 按钮,模型调用都从调用方发起;目前没有在服务端执行整套测试并等待完成的端点。
- 评判准确性:我们没有用人工评分校验评判模型,因此它的数值只能反映趋势。本文只对模式检查的结果给出明确结论。
常见问题
部署前如何测试 LLM 提示词?
让新版和当前版本处理同一批固定输入,按书面规则检查每个回答,再用事先选定的显著性检验比较通过数量。演示使用 110 条新消息和一次 Fisher 精确检验,区分出了 16% 和 0% 的遗漏率。
提示词回归测试需要多少用例?
行数要足够多,确保回归确实存在时,有较高概率至少出现 6 次规则检查失败。若要达到 80% 的概率,失败率为 16% 时需要 48 行,失败率为 6.25% 时需要 126 行。演示中,一个在主测试中有 16% 回答违反规则的版本,曾通过一次 40 行测试。
LLM 评判能替代模式检查吗?
能用模式表达的检查,不应改用模型评判。演示中的控制台和脚本使用了不同的评判提示词,对相同的 40 条消息,分别判定 v2 通过 40 条和 32 至 35 条。而模式检查对同一段文本每次都会给出相同结果。
相关阅读
- 提示词版本管理:按 ID 调用提示词,以及移动标签。
- 对提示词变更做 A/B 测试:版本在线上流量中的实际成本。
- 提示词库指南:测试集、检查项和评估运行。
- 控制台中的提示词:测试编辑器和标签移动对话框。