
LLM 智能体为什么这么贵?从 trace 找出四个原因
逐一复现并修复智能体账单偏高的四个原因:时间戳变化破坏缓存,修复后缓存命中率从0%升至73%;上下文不断增长,使后续请求携带更多内容;重试循环导致请求重复执行;模型选择错误。通过分别排查缓存、上下文、重试行为和模型选择,定位费用偏高的具体来源。
我们的推荐
实时价格| 模型 | 结论 | 价格 |
|---|---|---|
| GPT-6 Luna 将时间戳从提示词首行移走后,冷启动时四轮交互中 5,729 个输入 token 有 4,157 个从缓存读取。时间戳放在首行时,5,579 个输入 token 均未从缓存读取。 | 演示中的主智能体 | 低至 $0.1/百万 |
| DeepSeek V4.1 Flash 三次单句检查在 GPT-6.1 Sol 上的成本为 $0.0010,在此模型上的成本为 $0.0001。 | 演示中的子智能体 | 低至 $0.3/百万 |
目录
智能体的费用上涨,原因往往藏在单次请求之外:prompt 始终无法命中缓存,对话每轮重发的内容越来越多,循环重复执行同一项工作,或者用昂贵模型处理便宜模型就能完成的任务。把调用按 session 和 trace 分组后,这些问题就很明显了。本文用一个小型客服智能体复现这四种情况,展示如何在 Synthorai 控制台定位问题、修复问题,并对比修复前后的费用。
TL;DR
- prompt 首行的时间戳让缓存命中率一直停在 0%。将它移到末尾后,GPT-6 Luna 的命中率升至 73%,输入费用降低 66%。
- 每轮重发所有工具结果的对话历史消耗了三倍的输入 token,但输入费用只增加 21%,因为其中 71% 来自缓存。
- 一次重试循环执行了 10 次模型调用,实际只需要 2 次,而且所有调用的状态码都是 200。
- GPT-6.1 Sol 上的三次子智能体调用占了一个 session 费用的 81%。
本文接着追踪 LLM 智能体展开,那篇文章介绍了如何用请求头将调用归入 session 和 trace。按其中的说明配置演示环境(Python 3.10 或更高版本,并激活 virtualenv),然后在 github.com/synthorai-io/use-cases 的同一目录中运行这四个案例,以及另一种导致缓存失效的案例 replay-mismatch:
cd use-cases/agent-tracing
python incidents.py cache-miss context-growth replay-mismatch retry-loop wrong-model
每个案例运行两次,先运行有问题的版本,再运行修复后的版本,并为调用添加 case 和 variant 标签。这里的数据来自 2026 年 10 月 11 日各案例的一次运行。演示规模很小,费用都不到一美分。真正能用于评估实际工作负载的是这些比例。
| 案例 | 查看位置 | 修复前 | 修复后 |
|---|---|---|---|
cache-miss | session 页面中每轮的缓存命中率 | 0% 来自缓存,$0.0015 | 冷启动时 73% 来自缓存(缓存中尚无内容),$0.0011 |
context-growth | session 页面中逐轮上升的输入量 | 24,546 个输入 token,输入费用 $0.0011 | 8,053 个输入 token,输入费用 $0.0009 |
replay-mismatch | session 页面中始终为 0% 的缓存命中率 | 0% 来自缓存,$0.0038 | 76% 来自缓存,$0.0015 |
retry-loop | 单个 trace 的调用次数远超一轮所需 | 10 次调用,$0.0004 | 2 次调用,$0.0001 |
wrong-model | session 页面的 Agents 表 | $0.0012 | $0.0003 |
费用超出预期,先从哪里查?
先打开 Traces 列表,按费用排序。每行是一个 session 或 trace,列出调用次数、耗时和费用,最贵的对话会排在顶部。打开其中一项,就能判断它属于下面哪种问题。
如果请求带有 X-Synthorai-Metadata 标签,先缩小查询范围。Traces 列表的搜索框支持按标签搜索,输入 metadata.feature = support-agent 就只保留某个功能的 session 和 trace;输入 metadata.case = cache-miss,可以找到本文这个案例的两次运行。要查看汇总数据,可以打开 Analytics 的 Breakdown 页签,在 Cost by metadata 卡片中选择一个键,查看该键每个值对应的请求数、输入 token 数和费用。
为什么缓存命中率是零?
如果 prompt 开头附近的内容每次请求都变,缓存命中率就会是零。提示词缓存允许提供商以远低于普通输入的价格,计费重复出现的 prompt 前缀。但缓存只能覆盖到与上一请求相比出现差异的第一个 token 之前。本案例的问题版本把当前时间放在约 1,300 个 token 的 system prompt 首行:
# The clock is the first line, so the prompt differs from its first token on every turn.
system = f"Current time: {now}\n\n{SYSTEM}\n\n{MANUAL}"
在 GPT-6 Luna 上运行四轮对话后,session 页面显示 Cache hit 为 0%,5,579 个输入 token 中没有任何一个来自缓存。修复方法是把变化的部分移到末尾:
# Stable text first, the part that changes last.
system, user = f"{SYSTEM}\n\n{MANUAL}", f"{text}\n\n(Current time: {now})"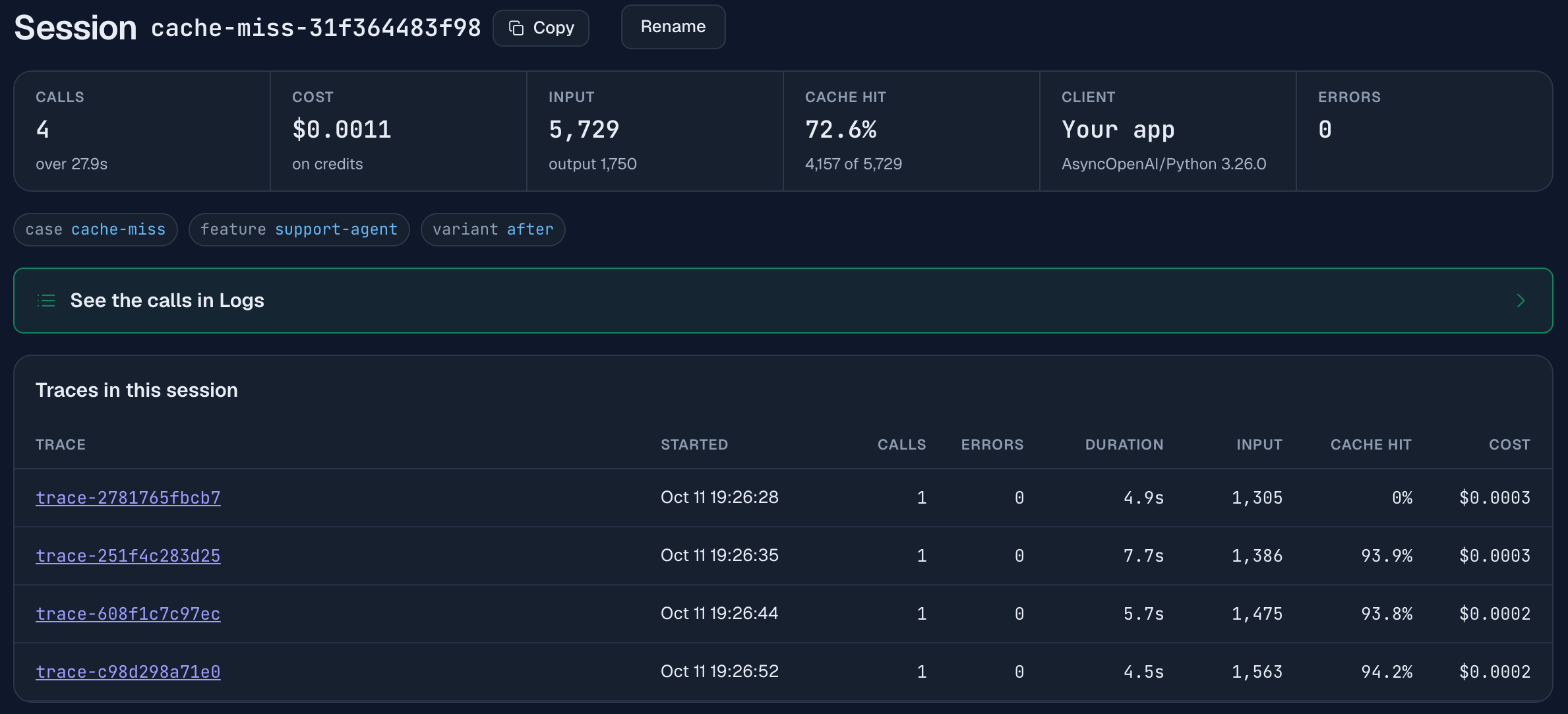
session 页面按轮列出输入量和缓存命中率,第一行是 0%。对话第一轮无法读取尚未由任何请求写入的缓存条目,所以这一轮只写入缓存,不读取缓存。后面三轮分别从缓存读取了 1,302、1,383 和 1,472 个 token,几乎覆盖了上一轮发送的全部内容,因此每轮约 94% 的输入来自缓存。整个对话合计有 5,729 个输入 token,其中 4,157 个来自缓存,占 73%。
节省的是输入费用。这个模型每百万输入 token 收费 $0.10,写入缓存的 token 收费 $0.125,从缓存读取的 token 收费 $0.01。对于长 prompt,几乎全部 token 都属于缓存写入或缓存读取。
问题版本向缓存写入了 5,567 个 token,没有读取任何 token。修复后写入 1,560 个,读取 4,157 个,输入费用因此从 $0.00070 降至 $0.00024,降低 66%。session 总费用从 $0.0015 降至 $0.0011,降幅比单看输入费用更小,因为输出占了这次费用的大头,而且修复后的运行恰好生成了更多输出(1,750 个 token,而问题版本为 1,599 个)。
能省多少,取决于对话开始时缓存中已有的内容。这次运行是冷启动,第一轮没有读取缓存。流量稳定的智能体应该能超过 73%,因为每次对话都使用相同的 system prompt。只要请求持续在缓存过期前到达,上一段对话留下的缓存条目就还在。如果一个 prompt 只会被某一次对话使用,它的第一轮就要支付缓存写入费用。
时间戳是典型原因。请求 ID、随机问候语、插入首段的用户名,或顺序不同的工具定义,都会造成同样的问题。缓存命中还需要满足两个条件:稳定前缀(prompt 开头不变的部分)必须超过提供商规定的最小长度(大多数为 1,024 个 token,参见提示词缓存);同一对话的调用应携带相同的 X-Session-Id,网关会用它来保持该对话缓存命中的一致性。
为什么每轮发送的内容都比上一轮多?
因为对话每轮都会重发历史记录。历史变长,输入有所增长是正常的。但本案例的问题版本增长得更快:每轮都查询客户信息,拿到约 1,100 个 token 的 JSON 订单历史,并把查询结果留在对话历史里。到了第六轮,请求中就包含了六份几乎相同的数据。
if variant == "before":
    history += [lookup_result]               # every old lookup is sent again on every later turn
history += [{"role": "user", "content": text}, {"role": "assistant", "content": reply}]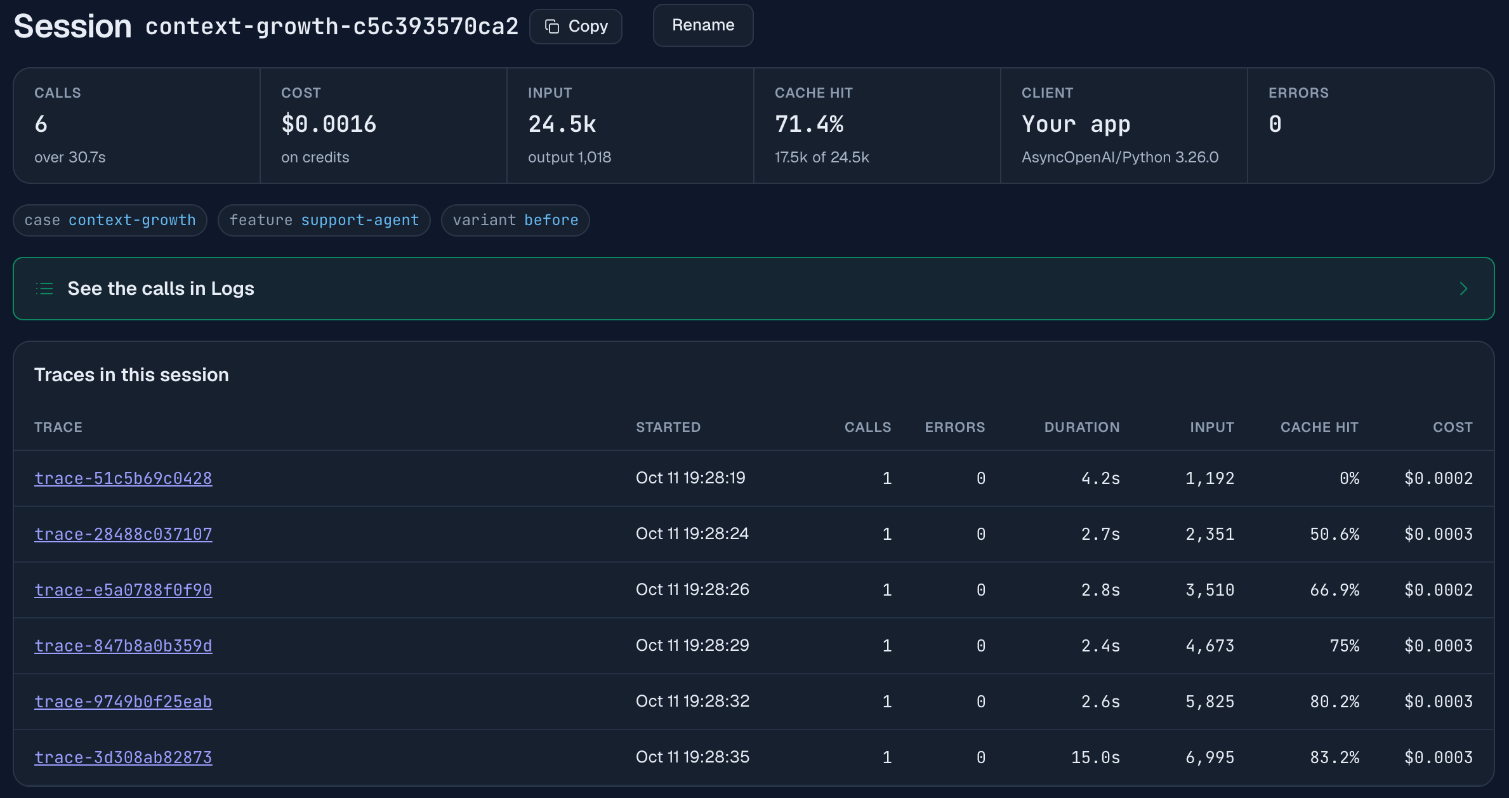
看“Traces in this session”表的 Input 列就能发现问题:每轮增加约 1,160 个 token,从第一轮的 1,192 增长到第六轮的 6,995,而回复始终只有两句话。六轮共用了 24,546 个输入 token。修复后的版本仍会在当前轮执行新的查询,但不再保留旧查询结果,因为 assistant 的回复已经记录了有用的信息。这样六轮只需要 8,053 个输入 token,约为原来的三分之一。
Input 旁边的两列解释了这个问题为什么容易被忽略。缓存命中率随输入量一起上升,每轮费用则稳定在 $0.0002 至 $0.0003。每轮开头都包含上一轮完整的 prompt,提供商会从缓存读取这部分:24,546 个输入 token 中有 17,536 个来自缓存,占 71%。问题版本的输入费用为 $0.0011,修复后为 $0.0009:输入 token 增至三倍,输入费用却只增加 21%。
这两次运行的 session 总费用完全看不出修复效果。问题版本的费用为 $0.0016,修复后为 $0.0017,因为修复后的运行恰好生成了更多输出(1,756 个 token,而问题版本为 1,018 个)。额外输出增加了约 $0.0004 的费用,超过输入侧节省的 $0.0002。应该对比修复真正改变的 Input 和 Cache hit 两列,而不是只看一次 session 的总费用。
提示词缓存可以抵消历史增长带来的大部分费用,但它做不到以下三点:
- 它不会缩小上下文。第六轮仍然发送 6,995 个 token。长 session 依然会触及模型的上下文长度上限,而且缓存 token 仍然收费,只是按缓存费率计费。
- 只有原样重发历史,缓存才有效。演示中的
replay-mismatch专门复现了这个问题:发送每条用户消息时追加一条指令,保存消息时却不包含这条指令。这样每轮重新拼出的 prompt 都不是上一轮实际发送的内容。该对话的 24,557 个输入 token 中没有任何一个来自缓存,费用为 $0.0038。按实际发送的内容保存消息后,24,702 个输入 token 中有 18,844 个来自缓存,即 76%,费用降至 $0.0015。 - 不是所有模型都支持缓存。按本案例所用的 GPT-6 Luna 全额输入价格计算,24,546 个 token 要花 $0.0025,而使用缓存后实际收取约 $0.0011。依赖缓存前,先检查 Cache hit 列。
对于你自己的智能体,工具结果通常是历史记录中体积最大、最不值得重发的内容。保留使用这些结果生成的回复,或一行摘要,删掉原始数据。这样无论模型有没有缓存,都能省钱。聊天机器人指南介绍了更通用的做法:把较早的对话轮次压缩成摘要。
重试循环在 trace 中是什么样?
一个 trace 中的调用次数远超单轮所需,而且相同的 span 名称反复出现。本案例中,承运商的物流查询 API 不可用。智能体调用工具,遇到超时,然后回复无法查看包裹状态。代码接着检查回复是否提到包裹位置,发现没有,就把整轮流程再跑一遍,最多运行五次:
if "sorting" in reply or "out for delivery" in reply:
    break                                    # the reply names a parcel location
if variant == "after" and (tool_failed or not results):
    break                                    # a retry cannot help while the tool is down or unused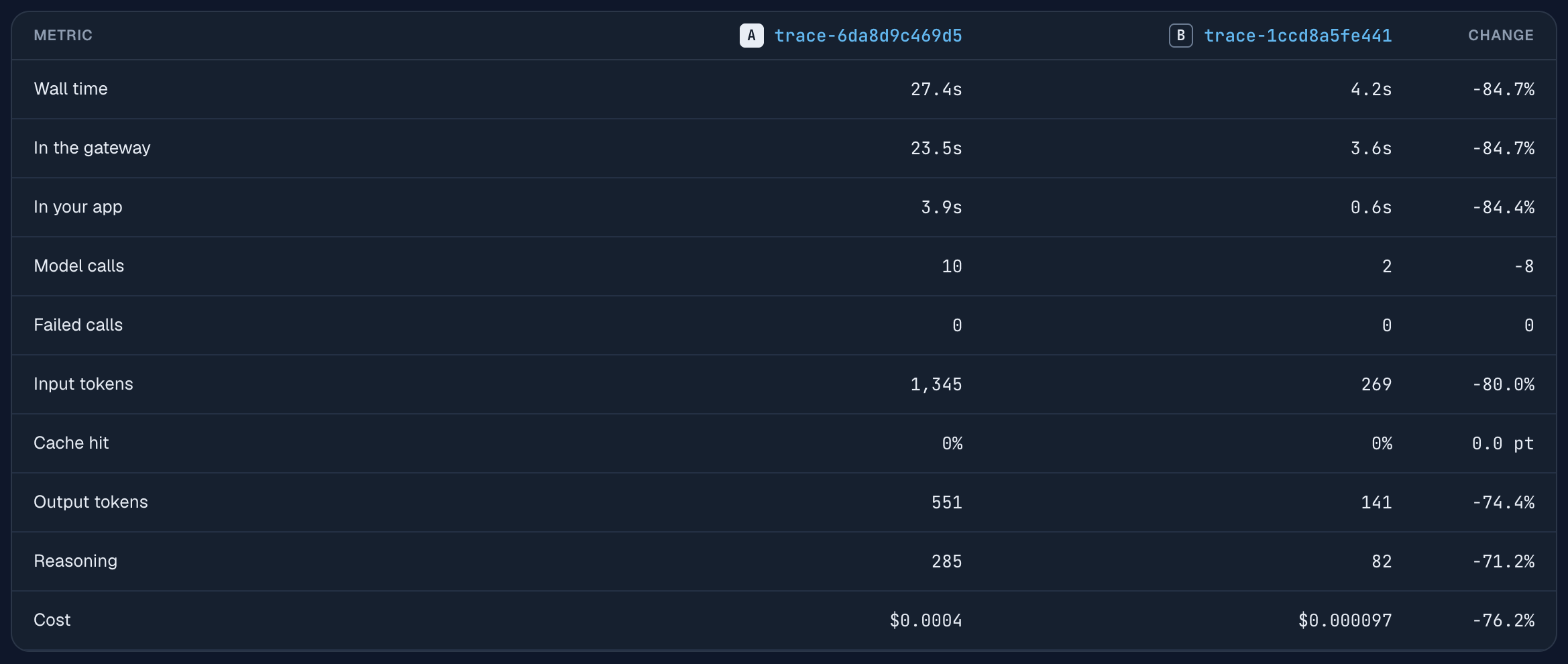
这是两次运行的 Compare 视图:打开一个 trace,选择 Compare,再选另一个。问题版本在 27.4 s 内调用了模型 10 次,花费 $0.0004,但客户最终收到的答案仍然一样。两边的“Failed calls”都是 0。循环中的每次调用都成功返回状态码 200,所以这里没有任何调用被标记为错误。修复后的版本区分工具故障和回复不符合要求,在问题出于工具时不再重试:2 次调用,4.2 s,$0.0001。
问题版本的瀑布图中,调用依次命名为 plan-1、answer-1、plan-2、answer-2,以此类推。像这样用步骤和尝试次数给 span 命名,一眼就能看出循环。要发现尚未察觉的循环,可以把 Traces 列表按调用次数排序。
怎么发现昂贵模型在做简单任务?
查看“Agents in this session”表,它按智能体拆分 session 的调用次数和费用。本案例的问题版本让子智能体在 GPT-6.1 Sol 上执行三次只需一句话的检查。这个模型每百万输入 token 收费 $2,每百万输出 token 收费 $10,而主智能体用 GPT-6 Luna 回答:
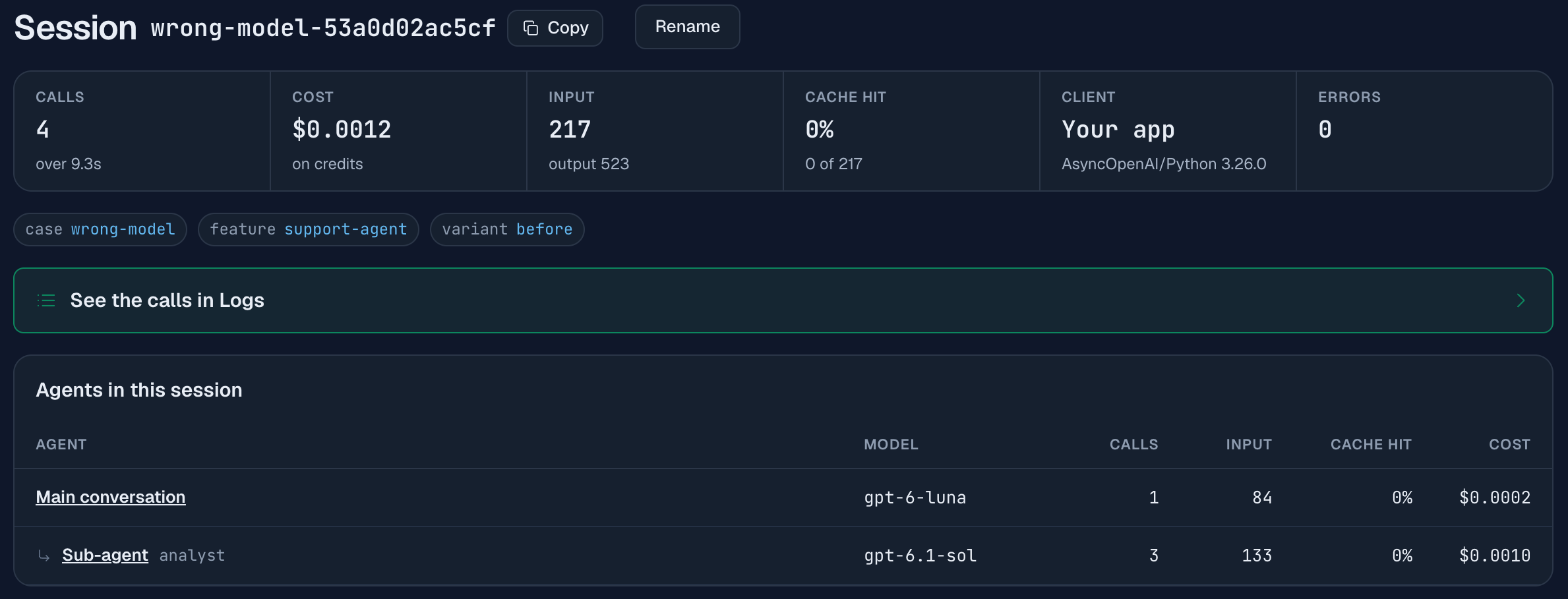
子智能体的三次调用花了 $0.0010,而整个 session 的费用是 $0.0012。任务要求最低的部分占了账单的 81%。把同样的三次检查放到 DeepSeek V4.1 Flash 上,费用为 $0.0001,整个 session 合计 $0.0003。两个版本执行检查时都关闭了 reasoning,因此差异来自模型价格。
这个案例只测量费用。我们没有评估检查结果的质量;只有当便宜模型的回答足以满足该步骤的要求时,换模型才合理。这张表告诉你钱花在哪里,也就能确定哪个步骤值得用便宜模型做测试。
子智能体调用携带 X-Agent-Id 时,页面会显示这种拆分。如果没有这个请求头,“Models in this session”表会按模型拆分。只有每个智能体使用各自独立的模型时,两种拆分才一致。要查看某个智能体在所有 session 中的汇总,可以使用 Analytics 的 Breakdown 页签中的 Cost by agent 卡片。
常见问题
怎么找出 LLM 智能体哪个部分最贵?
用请求头把调用归入 session 和 trace,再把 Traces 列表按费用排序,打开最上面的一项。session 页面会按智能体、模型和轮次拆分费用,足以判断是缓存问题、上下文问题,还是模型选择问题。
为什么提示词缓存命中率是 0%?
最常见的原因是 prompt 开头附近有一个不断变化的值,例如时间戳。缓存只能覆盖到第一个不同的 token 之前。在演示中,把时间戳从 system prompt 首行移到用户消息末尾,冷启动时的缓存命中率就从 0% 升到了 73%。
为什么对话第一轮没有命中缓存?
因为缓存条目由请求写入,而第一轮就是写入该条目的请求。演示中,对话四轮分别有 0%、93.9%、93.8% 和 94.2% 的输入来自缓存。只有之前的对话发送过相同前缀,而且距离现在足够近、缓存条目尚未过期时,第一轮才会读取缓存。
提示词缓存能让很长的对话历史免费吗?
不能,但它能掩盖大部分费用。演示中,每轮重发所有旧工具结果的对话,输入 token 是精简版本的三倍(24,546 对比 8,053),输入费用却只增加 21%,因为 71% 的输入来自缓存。这些 token 仍然占用上下文窗口,而且一旦重发的历史与实际发送过的内容不同,折扣就会消失:在演示的 replay-mismatch 案例中,消息保存的内容与发送的内容不一致,导致整个对话的缓存命中率降到 0%,费用增加到两倍以上。
提示词缓存能省多少钱?
取决于模型的缓存输入价格,以及输入费用在账单中所占的比例。在 GPT-6 Luna 的演示中,对话 73% 的输入来自缓存,输入费用降低了 66%,session 费用为 $0.0011,而没有缓存时为 $0.0015。这笔费用主要来自输出 token,缓存不会改变输出费用。
重试循环会表现为错误吗?
不一定。演示中,循环里的每次调用都返回状态码 200。实际只需要 2 次调用的流程,在一个 trace 中出现了 10 次调用,这才暴露了循环。要看每个 trace 的调用次数,不能只看错误率。
延伸阅读
- 追踪 LLM 智能体:本文用到的请求头、session 和标签。
- LLM 智能体为什么这么慢?:用同样的方法分析延迟。
- 调试 LLM 智能体:从用户投诉定位到出问题的调用。
- 按子智能体拆解 Claude Code 费用:用同样的 session 视图分析编程智能体,其中缓存写入占一次运行费用的 77%。
- 让 Claude 分析你的 LLM 日志:通过 MCP 找出这些 session 中费用最高的一个。
- 给智能体配备日志工具:用自己的程序读取同样的日志,并计算模型 token 费用。
- 提示词缓存:各提供商的最小前缀长度和价格。
- 按使用场景选择最佳 LLM:根据工作负载特点分析费用,为每个步骤选择模型。