
gemini-3.1-flash-lite-image vs GPT Image 2
什么时候选哪个
两者都是图像模型,每百万输出 token 的收费相同,均为 $30,因此真正的差异在于输入:gemini-3.1-flash-lite-image 接受文本和图像的价格为每百万 $0.25,而 gpt-image-2 为 $5,这使得提供提示词和参考图像的成本便宜 20x。对于输入量主导账单的重提示词或 image-in-image-out 流水线,请选择 gemini-3.1-flash-lite-image,并注意它在返回图像的同时也能返回文本,具有 4096-token 的输出上限且思考无法关闭。当你需要来自 OpenAI 的纯图像输出端点且输入成本是次要开销项时,请选择 gpt-image-2。
价格
| gemini-3.1-flash-lite-image | GPT Image 2 | Δ | |
|---|---|---|---|
| 输入 / 1M token | $0.25 | $5 | 0.05× |
| 输出 / 1M token | $30 | $30 | = |
| 参考图 token / 百万 | - | $8 | - |
价格取自构建时的实时目录,最新价格见各模型页面。
两个模型所处的位置:全部 15 个按同一单位计费的图像生成模型的每 1M token 输出价分布(对数刻度)
规格
| gemini-3.1-flash-lite-image | GPT Image 2 | |
|---|---|---|
| 输入模态 | 文本 图像 | 文本 图像 |
| 输出模态 | 文本 图像 | 图像 |
| 发布日期 | 2026-06-30 | 2026-04-21 |
| 知识截止日期 | 2025-01 | - |
| 输出尺寸 | 仅 1K(1:1 = 1024x1024) |
|
| 输入方式 | 文生图、交错式生成 + 编辑、最多 14 张参考图 | 文生图、带蒙版局部重绘的图像编辑 |
| 单次请求图片数 | - | 10 |
| 格式 | - | png, jpeg, webp |
| 备注 | 仅 1K(1024px)输出;10 种宽高比(1:1、3:2、2:3、3:4、4:3、4:5、5:4、9:16、16:9、21:9),最多 14 张参考图;交错式生成与编辑,支持快速多轮局部修改;端到端延迟低于 2s;SynthID + C2PA 水印始终开启 | 灵活分辨率:边长最高 3840px 且为 16 的倍数,比例 <=3:1,总量约 0.65-8.3MP(含 4K 3840x2160);支持带蒙版的局部重绘编辑;所有图像输入均以高保真处理;文字渲染显著改进(精确定位仍可能吃力) |
规格照录自各供应商的文档;供应商没有公布的项目,对应的行直接省略,不做推断。 完整来源: gemini-3.1-flash-lite-image · GPT Image 2
同一条提示词,两个模型,经网关实测
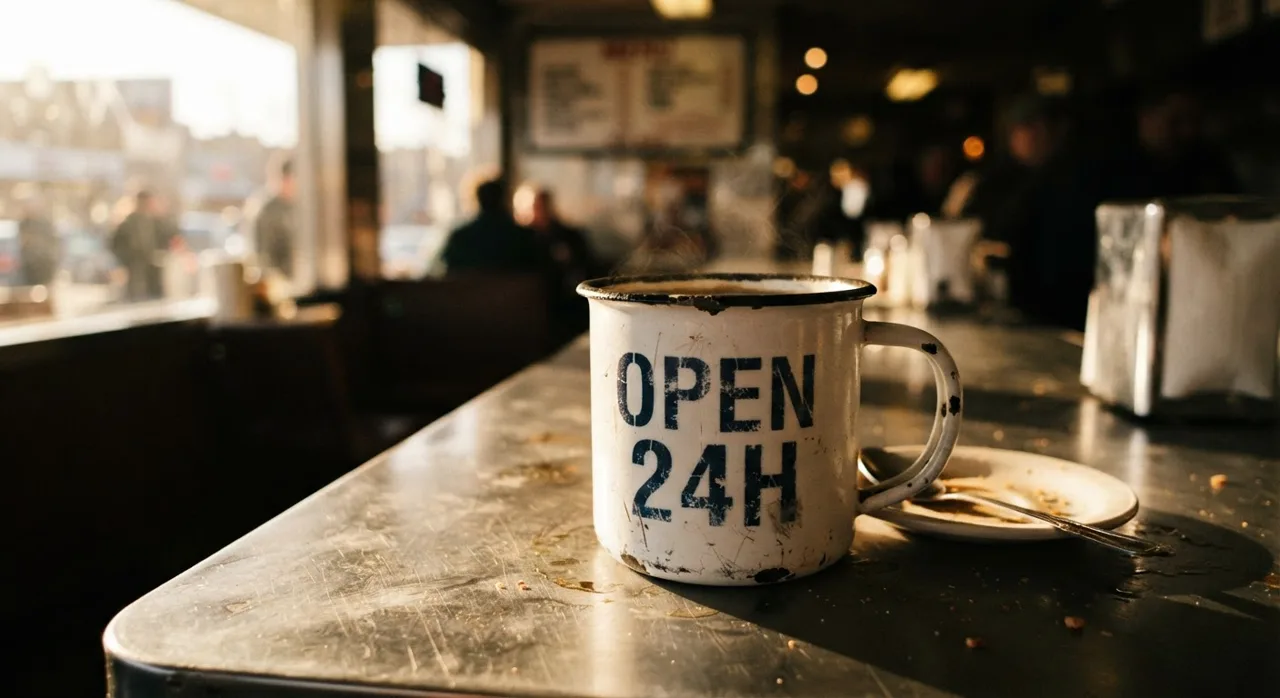
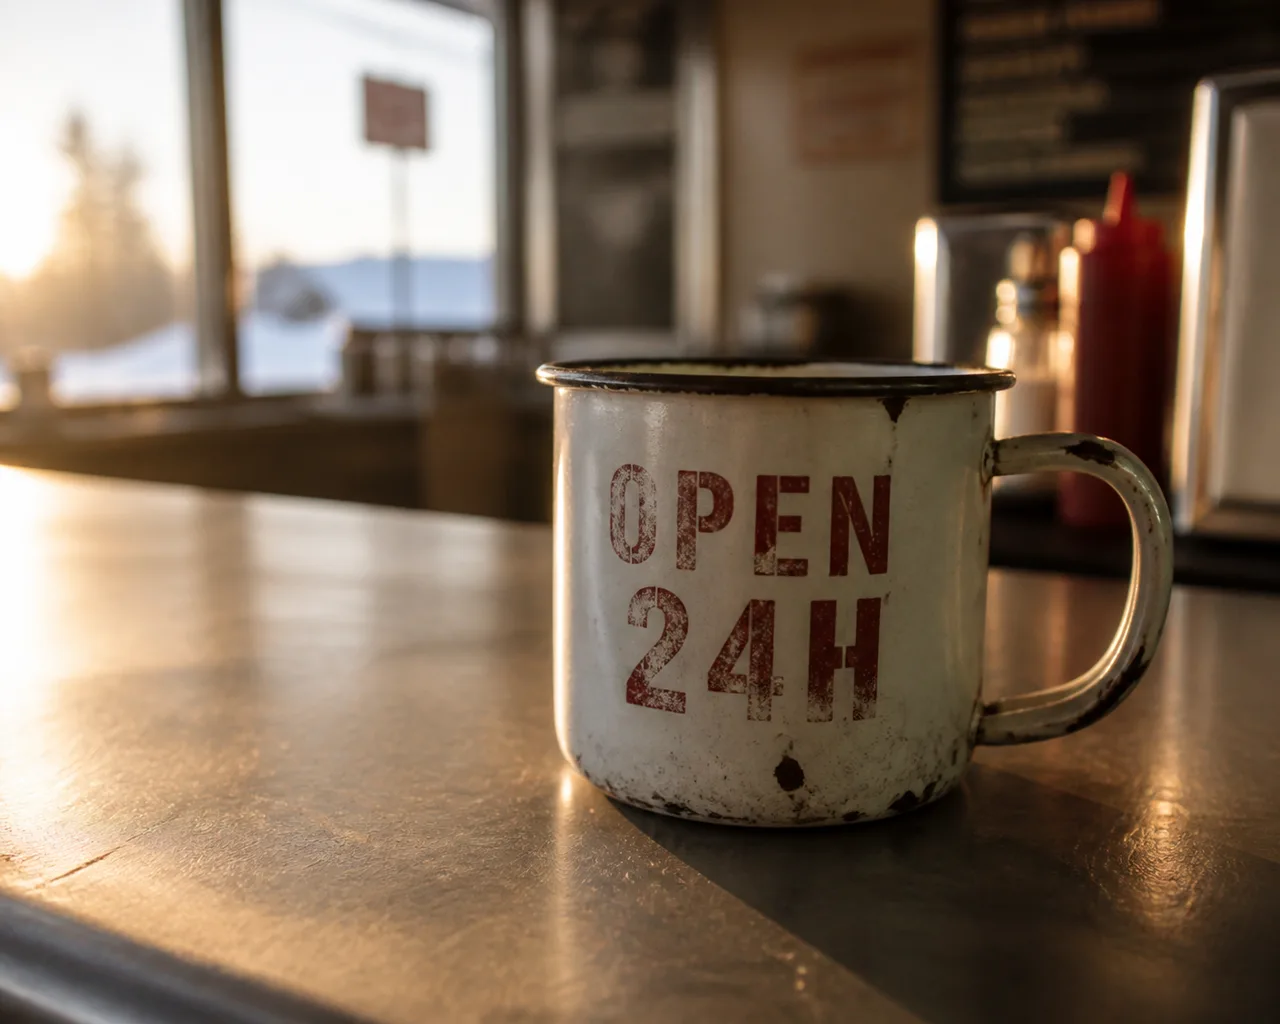
同一条提示词,每个模型只请求一次,不重试,也不挑结果,展示的都是各模型返回的第一个结果。尺寸和时长都没有指定,各模型用的是自己的默认值,因为硬凑一组所有模型都接受的参数,哪个模型都发挥不好。这里的文件为了网页展示重新编码过,所以请看构图和对提示词的还原程度,不要看压缩画质。
改一行代码就能在两个模型之间切换
下方每个标签页里都有两个模型 ID,高亮的那两行是唯一要改的地方。端点不变,API key 不变,请求结构也不变。
from openai import OpenAI

client = OpenAI(
    base_url="https://synthorai.io/v1",
    api_key="sk-syn-...",
)

resp = client.images.generate(
    model="gemini-3.1-flash-lite-image",
    # model="gpt-image-2",  # 取消注释此行,注释上一行
    prompt="a watercolor lighthouse at dawn",
    size="1024x1024",
)
print(resp.data[0].b64_json[:80])
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://synthorai.io/v1",
apiKey: "sk-syn-...",
});
const resp = await client.images.generate({
model: "gemini-3.1-flash-lite-image",
// model: "gpt-image-2", // 取消注释此行,注释上一行
prompt: "a watercolor lighthouse at dawn",
size: "1024x1024",
});
console.log(resp.data?.[0]?.b64_json?.slice(0, 80));curl https://synthorai.io/v1/images/generations \
-H "Authorization: Bearer sk-syn-..." \
-H "Content-Type: application/json" \
-d '{
"model": "gemini-3.1-flash-lite-image",
# "model": "gpt-image-2", # 取消注释此行,注释上一行
"prompt": "a watercolor lighthouse at dawn",
"size": "1024x1024"
}'package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/option"
)
func main() {
client := openai.NewClient(
option.WithBaseURL("https://synthorai.io/v1"),
option.WithAPIKey("sk-syn-..."),
)
resp, _ := client.Images.Generate(context.TODO(), openai.ImageGenerateParams{
Model: "gemini-3.1-flash-lite-image",
// Model: "gpt-image-2", // 取消注释此行,注释上一行
Prompt: "a watercolor lighthouse at dawn",
Size: "1024x1024",
})
fmt.Println(resp.Data[0].B64JSON[:80])
}import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.images.*;
OpenAIClient client = OpenAIOkHttpClient.builder()
.baseUrl("https://synthorai.io/v1")
.apiKey("sk-syn-...")
.build();
ImagesResponse resp = client.images().generate(
ImageGenerateParams.builder()
.model("gemini-3.1-flash-lite-image")
// .model("gpt-image-2") // 取消注释此行,注释上一行
.prompt("a watercolor lighthouse at dawn")
.size("1024x1024")
.build());
System.out.println(resp.data().orElseThrow().get(0).b64Json().orElseThrow().substring(0, 80));常见问题
gemini-3.1-flash-lite-image 和 GPT Image 2 哪个更便宜?
按「输入 / 1M token」算,gemini-3.1-flash-lite-image 更便宜($0.25 对 $5,相差 20×)。其他计费项的结论可能相反,完整价格见上方表格,实际成本取决于你的用量构成。
不用分别集成两次,就能对 gemini-3.1-flash-lite-image 和 GPT Image 2 做 A/B 测试吗?
可以。两个模型走同一个 OpenAI 兼容端点,用同一个 API key,切换时只要改一行里的模型名,所以可以给两个模型各分一部分流量,直接对比账单。
价格会随图像尺寸变化吗?
要看模型怎么计费。按张计费的模型,不管提示词多长、输出尺寸多大,每张价格都一样;按 token 计费的模型,分辨率越高费用越高,一张 4K 图的成本是小图的好几倍。两个模型各属哪一种,上方表格里有标明。