
提示词缓存未命中:排查路由前先做这五项检查
目录
排查提示词缓存未命中时,先检查 usage,再以已确认缓存可复用的请求为基线,依次核对可复用前缀、缓存条件、请求时序和实际的上游目标。
TL;DR
- 缺少缓存 usage 时,结果是未知;报告的读取量为零,也不能据此确定原因。
- 请求命中率统计有任何缓存复用的请求占比;token 复用率衡量输入中有多少被复用。
- 原生诊断状态对应不同的处理方式:修复差异、重新建立缺失的基线,或继续排查尚无定论的比较结果。
- DeepSeek 要求匹配已持久化的完整前缀单元;仅有相同的文本前缀可能还不够。
缓存不再命中时,应该先检查什么?
先确认原始响应是否确实包含缓存 usage。如果提供商报告了缓存读取,而客户端或仪表盘没有显示,先排查统计链路。否则,保留最近一次确认缓存可复用的请求,将出问题的请求与它比较。
| 首项检查 | 需要收集的证据 | 最小有效操作 |
|---|---|---|
| 未命中是否属实? | 提供商原始 usage、客户端响应和仪表盘记录 | 修改 prompt 前,先检查字段缺失和 streaming 聚合 |
| 前缀是否变化? | 按顺序排列的工具、系统文本和较早的消息 | 逐项比较;将变化的时间戳或请求 ID 移到可复用内容之后 |
| 前缀是否符合条件并已写入? | 模型最低要求、控制参数、读写 usage | 核对具体模型和 API;检查预期的缓存断点 |
| 请求是否过早或过晚? | 响应开始时间、请求间隔、缓存有效期 | 测试并发流量前,先串行发送一次后续请求 |
| 目标是否变化? | 实际模型、服务、账号范围和 fallback 尝试 | 请网关运维方比较实际的上游请求尝试 |
对输入和缓存 usage 完整的请求,使用以下两个明确命名的指标:
- 请求命中率 = 缓存读取 token 大于零的请求数 / usage 完整的请求数。
- token 复用率 = 缓存读取 token 总数 / 所有输入 token 总数,包括缓存输入和缓存写入。
单独报告缺少 usage 的请求,并将失败尝试计入故障成本。输入增长可能降低 token 复用率,但不改变请求命中率。
| 原生 API | 缓存读取字段 | token 复用率分母使用的输入总量 |
|---|---|---|
| OpenAI Responses | usage.input_tokens_details.cached_tokens | usage.input_tokens,已包含缓存输入 |
| Anthropic Messages | usage.cache_read_input_tokens | usage 中的 input_tokens + cache_read_input_tokens + cache_creation_input_tokens |
| DeepSeek | usage.prompt_cache_hit_tokens | usage 中的 prompt_cache_hit_tokens + prompt_cache_miss_tokens |
如果原生字段已被转换,应使用网关的统一格式;下文给出了 Synthorai 的计算公式。
应该检查哪些应用设置和时序?
检查预期可复用前缀之前的内容是否发生变化,可以先看系统时间戳、工具顺序和被重写的历史消息。
前缀变化。分别为按顺序排列的工具定义、稳定的系统文本和较早的消息块记录指纹,也就是用于检测变化的哈希值。请求专属标记放在末尾。正常对话即使只追加内容,整个请求的哈希值也会变化,因此无法用它定位第一处差异。JSON 文本之外的空白与模型可见字符串内的空白,也要区别处理。
检查检索内容的位置、模式切换、上下文压缩,以及框架最终发出的请求。对于多模态输入,还要比较预处理过程和文件引用。
缓存条件与控制参数。缓存断点标记了申请缓存的前缀终点。TTL 是缓存条目配置的有效期。
请求总长度足够长,不代表选中的可复用前缀达到了模型的最低要求。使用显式断点时,要检查断点之前的内容。添加 cache_control 不能让原本不符合条件的前缀变得可复用。在 Anthropic 上,需要检查自动控制与块级控制、TTL 冲突和断点数量限制;无效的组合可能返回 HTTP 400,表示请求被拒绝,而不是成功响应但缓存读取为零。参见 Anthropic 提示词缓存。
缓存就绪与过期。首次写入尚未可用时,突发发送多个相同请求,可能产生多个冷请求。Anthropic 文档说明,缓存会在首次响应开始后可用。先在首次响应开始后发送一个后续请求,建立缓存可复用的基线,再根据响应开始时间戳比较并发请求。对于闲置后的对话,比较请求间隔与配置的缓存有效期,并核对文档说明的刷新行为。参见 Anthropic 缓存可用性。
DeepSeek 持久化单元。DeepSeek 匹配的是已持久化的完整前缀单元,也就是此前上下文中已保存的部分。文档中的示例先发送 A+B,再发送 A+C:第二个请求无法复用完整的 A+B 单元。服务检测并持久化公共前缀 A 后,第三个请求 A+D 才能复用该单元。其中,A 是稳定上下文,B、C 和 D 是不同的后缀。这是厂商文档描述的机制,并非我们的实测结果。
对于这种模式,应保持 A 完全不变,串行完成前两个请求,为持久化预留数秒,再检查第三个请求的命中与未命中 token 字段。仅仅等待,并不能确保所需的公共前缀单元已经建立,而且缓存仍然只是尽力而为。参见 DeepSeek 持久化规则。
网关可能在客户端与提供商之间改变什么?
网关既可能改变实际请求,也可能改变返回给客户端的证据。将回退归因于路由前,先分别检查这两条链路。
检查模型别名、凭证范围、策略覆盖和 fallback 尝试。涉及协议转换时,检查发往上游的控制参数和返回的原生字段;使用 streaming 时,将上游 usage 事件与客户端最终 usage 进行比较。
跨厂商路由漂移。负载均衡或故障转移可能将同一个对外模型切换到不同的推理服务商,而它们的缓存彼此独立。在服务商 A 预热的前缀,到服务商 B 就不可用。我们的提供商漂移研究观察到九个上游,请求命中数为 4/20;单后端对照组则为 19/20。这些结果描述的是当时的配置。
按服务商、模型和账号范围对请求尝试分组。在前缀和请求间隔稳定的条件下,比较各组的缓存读取,并纳入失败尝试和 fallback 目标。请运维方核实亲和性,也就是相关请求是否被持续路由到同一目标,以及故障转移行为。获批调整后重新测试。服务商变化可以证实漂移,但单次未命中仍需检查时序和缓存条件。
Synthorai 请求没有提供商或通道选择参数。
如何在 Synthorai 中排查缓存异常?
使用 Analytics 查看工作负载趋势,使用 Logs 检查具体请求。以下界面标签已于 2026 年 11 月 6 日在线核实。
- 缩小工作负载范围。在 Analytics 中选择
Time range和All keys · all models。在 Logs 中,通过Add filter按model或key筛选。正常时段和异常时段的筛选条件要保持一致。CACHE HIT是 token 复用率,不是请求命中率。 - 检查请求。在
Overview中,比较Cost at your rate下的 Input、Cache read、Output 和适用的写入项。读取量稳定而输入增长,可能是上下文增长;读取量下降而写入量上升,应检查前缀和时序。Raw包含的是已存储字段,不是提供商的原始响应。 - 沿 trace 和 session 追查。从受影响的 Logs 请求选择
Open trace,再选择Open session。在Traces in this session中比较任务,并打开复用量为零的 trace。点击每个 span(单次操作),检查缓存读写和费用;仅看瀑布图无法判断缓存复用。使用 Logs 的session或trace筛选器查看底层记录。保留链接、时间戳和原生响应 ID,以便升级处理。
每个对话发送 X-Session-Id,每个任务发送 X-Trace-Id,每次操作发送 X-Span-Id。解读缓存趋势前,先按模型和预期共享前缀分组。
关联观测与路由是两回事:在网关亲和性判断中,X-Session-Id 的优先级也高于请求体中的缓存键;X-Trace-Id 只用于归组观测记录。比较期间要保持 session 标识稳定。两者都不保证共享缓存或固定目标,不要为了提高命中率而把无关对话归为一组。
对于字段完整的 Synthorai 存储记录,按以下方式计算 token 复用率:
cache reads = cached_tokens + explicit_cached_tokens
input total = prompt_tokens + explicit_cached_tokens + cache_write_tokens
reuse ratio = sum(cache reads) / sum(input total)其中,prompt_tokens 已包含 cached_tokens,再次相加会重复计算输入。缓存写入应计入分母,而不是分子。排除缺少 usage 的记录,并单独报告数量;仅凭存储值为零,无法证明上游确实测得并报告了零。
一个实测 session:先定位异常,再检查 span
沿用智能体成本排查的方法,我们于 2026 年 11 月 6 日通过 Synthorai,使用 GPT-6.1 Sol 串行发送了六个 Responses 请求。一个 session 包含三个 trace,每个 trace 都有两次调用,标为 lookup-1 和 lookup-2。这些标签代表合成的模型调用,并未执行查询工具。模型、工具和 session ID 保持不变。为制造异常,每次请求都在开头插入一个新的、类似时间戳的值;修复时恢复原始前缀。请求标记始终位于末尾。
| Trace | 输入 token | 缓存读取 | 复用率 | 报告费用 |
|---|---|---|---|---|
| 基线 | 4,729 | 2,273 | 48.1% | $0.0063923 |
| 异常 | 4,764 | 0 | 0% | $0.0119350 |
| 修复 | 4,732 | 4,546 | 96.1% | $0.0009446 |
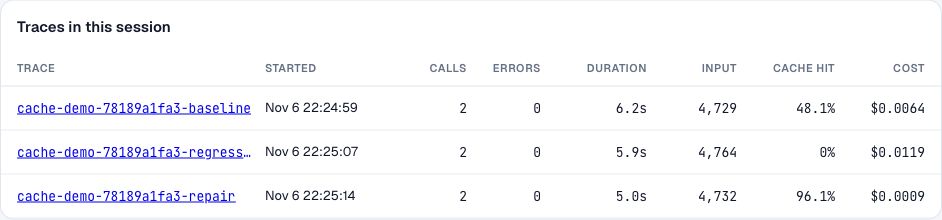
在 Traces in this session 中,打开复用率为零的异常行。基线包含首次冷调用;修复后则复用了已经预热的前缀。这六次调用演示的是人为注入的故障及其恢复,不代表生产环境的预期节省比例。整个 session 的复用率为 6,819 / 14,225 = 47.9%;这个平均值掩盖了异常。
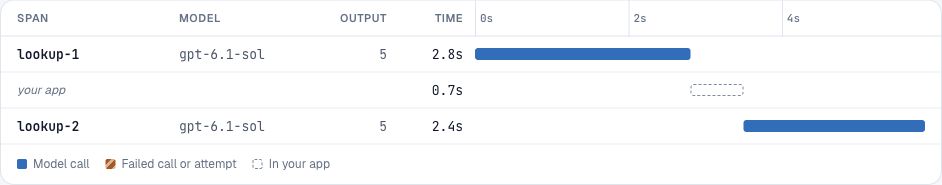
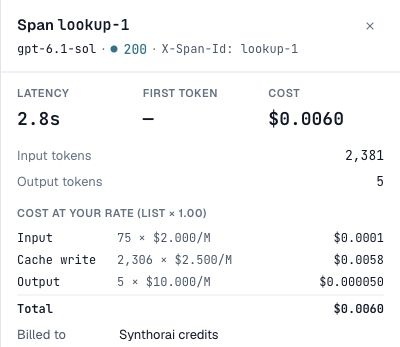
在瀑布图中选择 lookup-1。详情显示,2,381 个输入 token 中有 2,306 个缓存写入 token,这与重建已变化前缀的行为一致。存储的合成请求能够确认注入的差异;仅凭时间线无法定位它。通过 Open in Logs 查看请求记录,并比较应用侧的前缀指纹。
本次演示没有请求原生诊断比较。注入的前缀变化与报告的 usage 证实了观察到的异常和恢复;实际服务商是否始终相同,未做独立验证。session 标识保持不变,因此该实验没有衡量亲和性带来的收益。
使用 BYOK 时,对账前要区分提供商报告的费用和估算费用。对于无法获取的目标或 fallback 详情,应向运维方索取证据。
原生诊断如何帮助识别请求变化?
原生诊断用于识别请求差异;usage 用于衡量报告的复用量。两者要结合查看。所选网关路径必须支持并保留原生字段。我们此前通过 Synthorai 进行的比较探测没有返回诊断信息,因此,仅凭供应商文档不能确认网关支持这项功能。
OpenAI Responses 在支持的模型上接受 prompt_cache_options.comparison_response_id。保留已完成的基线响应 ID,并提交真实的后续内容;比较引用不会加载对话历史。结果位于 prompt_cache_diagnostics 中,streaming 模式下也会出现在 response.completed 事件中。根据下表中的状态选择下一步操作。诊断估算的 token 数与计费 usage 相互独立。参见 OpenAI 缓存诊断。
Anthropic Messages 首次通过 diagnostics: {"previous_message_id": null} 启用诊断,之后启用诊断的请求需传入前一个原生消息 ID。streaming 在 message_start 中返回结果。解读 null 结果前,先确认两个请求都启用了诊断,且后续请求提供了真实引用。Anthropic 文档说明,诊断适用于 Claude API,不包括 Amazon Bedrock 和 Google 托管的 Claude。参见 Anthropic 缓存诊断。
| API 及返回状态 | 含义 | 下一步操作 |
|---|---|---|
OpenAI cache_hit | 比较未检测到未命中 | 查看 usage 量化复用量;新增后缀 token 仍可能需要处理 |
OpenAI cache_miss | 已分类的差异影响了预期复用 | 检查 reason,修复对应组件,再次比较 |
OpenAI comparison_response_not_found | 基线记录缺失或已过期 | 选择同一组织内近期已完成的响应 |
OpenAI unavailable | 比较不受支持或无法得出结论 | 核实模型支持情况;尝试近期引用,若持续出现则手动检查 |
Anthropic diagnostics: null | 只有在有效且已启用的比较执行后,才表示无差异;未启用诊断或首轮请求也会返回此值 | 先核实启用状态和引用;若比较有效且无差异但读取量低,检查缓存可用性 |
Anthropic 诊断对象内的 cache_miss_reason: null | 比较尚未完成 | 检查下一轮已启用诊断的请求;不要将待定结果归为未命中 |
Anthropic 原因类型 *_changed | 首个识别出的差异组件 | 修复该组件后再次比较;后续仍可能存在其他差异 |
Anthropic previous_message_not_found | 未保留基线指纹 | 检查前一请求是否启用诊断、组织或工作区以及经过的时间;建立新基线 |
Anthropic unavailable | 比较无定论,包括部分其他参数变化或比较限制 | 比较实际生效的 tool_choice、思考与输出设置及 beta 请求头;若持续出现则手动检查 |
| 任一 API 缺少诊断字段 | 证据缺失 | 检查 API 或模型支持情况、请求选项、转换和 streaming 事件采集 |
OpenAI 的 prompt_cache_key_changed 需要特别注意:usage 可能报告未命中,但底层缓存并未实际未命中。将结果归因于缓存可用性之前,先确认是否为了独立核算而主动修改了键。在预期的核算分组内保持键稳定,同时检查它在网关亲和性中的作用。参见 OpenAI 诊断原因。
什么时候应该排查推理服务本身?
确认内容符合缓存条件、时序有效、目标范围可比且 usage 可信后,再排查缓存可用性。即便如此,输入未变化也不保证可复用条目仍然存在。
可能的原因包括过期、持久化未完成、容量压力和服务端调度。OpenAI 文档说明了缓存路由与可用性的限制;session 标签并不保证请求能到达某个特定 worker。部分命中也可能意味着较早的前缀仍可复用,而后续内容需要处理。参见 OpenAI 提示词缓存。
首个 token 返回慢或读取量为零,都不能证明发生了集群切换。升级处理时提交原生响应 ID、时间戳、请求间隔和目标标签;没有提供商证据,就不要对底层机制下结论。
显式缓存资源还需要另一项检查:核实引用对象是否存在、是否过期,以及作用范围。排查失效的显式资源 ID 时,不能沿用自动前缀缓存的假设。
如何证明修复有效?
结合 usage、诊断信息和目标,对比正常、异常和修复后的流量。
成本要包含重试。统计链路修复后,原生 usage 与客户端 usage 应能对齐。前缀修复后,差异应消失,并恢复可比的复用量。路由修复后,应确认请求到达预期目标,并在该范围内恢复。如果相关条件未满足,就保留“尚未解决”的分类,继续根据剩余证据排查。
常见问题
添加 cache_control 是否保证命中?
缓存控制仍受前缀长度、位置、就绪状态和有效期约束。检查模型要求和原始 usage。
模型名称不变,缓存未命中也可能由路由引起吗?
客户端模型名称即使不变,也可能解析到不同的服务商、模型或账号范围。按照提供商漂移排查手册,与网关运维方一起比较实际请求尝试。
已有部分 token 命中缓存,为什么诊断仍提示请求变化?
请求靠后的位置发生变化时,较早的前缀仍可能复用。应结合变化组件和缓存读取 token 的绝对数量判断。诊断比较与缓存核算描述的是请求的不同方面。