
上下文压缩成本:多少轮请求才能回本
目录
在六次缓存已预热、起始上下文接近 14k token 的测试中,Claude Sonnet 5.5 的上下文压缩成本在后续 4-6 次请求后回本。这个实测范围只适用于本次工作负载。制定策略时,必须计入摘要生成成本、实际的缓存计费方式,以及剩余任务是否足以收回压缩成本。
TL;DR
- 上下文窗口接近上限时,缩减活跃上下文是容量要求;本次测试没有测量模型的最大窗口。
- 在高价档生成摘要后,一次查询基本持平(压缩方案为 $0.0560882,保留历史为 $0.0560655);在该示例中,两次查询就明确收回了摘要成本。
- 事后套用公式得到的回本周期为 4-5 轮,实测为 4-6 轮;这不是事前预测测试。
- 在一项包含六个问题的档案任务中,压缩方案花费 $0.0156941,不压缩花费 $0.0059911,准确率均为 6/6。
你想用上下文压缩解决什么问题?
先确定为什么要缩减上下文,再选择 token 阈值。上下文硬上限、更高的计费档位和普通长对话,需要采用不同的决策方式。
上下文压缩会用更短的表示替换早期对话内容,供后续请求使用。我们的实验采用客户端文本摘要:通过一次普通模型调用生成摘要,再由应用用这段文本替换早期历史。原生的签名或加密压缩功能,其请求和用量约定与此不同。
| 场景 | 主要目标 | 什么条件下应触发操作? | 本文提供的依据 |
|---|---|---|---|
| 接近模型上下文窗口上限 | 保证任务能够继续执行 | 为下一次输入、工具结果和输出留出足够空间 | 已公布的模型限制和工程策略;未进行最大窗口实验 |
| 接近更高计费档位 | 降低整个工作负载的成本 | 预计节省的费用超过摘要和后续请求成本 | 一项小规模、无缓存的计费档位实验 |
| 窗口和计费档位都还有余量 | 优化特定工作负载 | 剩余的有效工作足以收回摘要成本,且不丢失必要状态 | 使用缓存的状态保留配对测试,以及一项短档案任务 |
场景 1:模型上下文快用完了怎么办?
在下一次请求可能超出支持的窗口之前,缩减或重组活跃上下文。到这个阶段,继续携带完整对话记录可能已经不可行。
Claude Haiku 5.5 的模型规格标明,其上下文窗口为 1M token,最大输出为 128K。这些是官方公布的规格。我们没有测试网关路由实际能接受的最大上下文,下文的计费档位实验也无法确定这个边界。
为下一次输入、工具结果以及服务要求的输出预留空间。触发压缩时,摘要请求本身也必须还能放进窗口。通过摘要或可检索的源记录保留关键状态,并以任务能否成功继续作为评估标准;超出窗口后被拒绝的请求,不能算作成本更低的成功基线。
场景 2:进入更高计费档位前,要不要压缩?
按实际价格计算,预计剩余工作能够收回摘要成本时再压缩。跨入更高计费档位可能让压缩更划算,但摘要请求本身也可能按高价计费。
Claude Haiku 5.5 的输入超过 100,000 token 后会调整价格。根据 2026 年 11 月 4 日核查的标准输入/输出价格,在该边界以内,每百万 token 的价格为 $0.10/$0.50,超过后为 $0.50/$2.50。
我们通过 Synthorai 网关发送了内容各异的虚构图书馆记录。输入为 94,350 token 的请求花费 $0.009437,输入为 111,999 token 的请求花费 $0.0560095。两次请求都生成了四个输出 token。费用差异同时包含输入长度和计费档位的影响。
随后,我们对较长的历史生成摘要。该调用处理了 112,028 个输入 token,没有报告缓存命中,按高价档计费,花费 $0.0560715。两种方案都正确回答了数量和来源查询。
| 剩余查询数 | 保留历史 | 摘要加缩减上下文后的查询 | 保留历史,全部按低价重算 | 压缩,全部按低价重算 |
|---|---|---|---|---|
| 1 | $0.0560655 | $0.0560882 | $0.0112131 | $0.0112310 |
| 2 | $0.1120760 | $0.0560944 | $0.0224152 | $0.0112372 |
一次查询时基本持平,两种方案只差 $0.0000227。在这个示例中,两次查询就明确收回了摘要成本。将所有 token 按低价重算,可以把 token 数量变化和档位变化的影响分开。
这些无缓存请求只代表一项合成任务。历史已经预热时,情况会不同。需要检查摘要能把输入降到阈值以下多远,以及新增输入何时会再次越界,参见长上下文计费档位。
场景 3:一次压缩需要多少轮后续请求才能回本?
在六次起始输入约为 13.5k-14.2k token 的缓存测试中,Claude Sonnet 5.5 需要后续 4-6 轮才能回本。这里的一轮指一次后续模型请求。实验计入摘要生成和之后的缓存写入,在共同预热后的十二次连续请求内,找到累计成本首次持平或更低的位置。六次测试中,压缩方案在跨过这一点后,直到第 12 次请求都没有比保留历史更贵。这个结论不覆盖之后的缓存过期、再次生成摘要或任务变化。
压缩会浪费已经支付的缓存写入溢价吗?
做决策时,已经支付的写入费用属于沉没成本。应比较的是:未来减少的读取费用,能否覆盖摘要请求和新写入的成本。实验使用显式的五分钟缓存;隐式缓存的定价因供应商而异,不一定收取相同的写入溢价。
一次中等增长速度的测试,展示了首次压缩和会话后期再次生成摘要的区别:
| 操作 | 避免的后续读取费用 | 后续额外写入费用 | 摘要生成费用 | 截至第 12 轮的净结果 |
|---|---|---|---|---|
| 首次摘要,对比保留历史 | $0.0159875 | $0.0010175 | $0.0049761 | 少花 $0.0099939 |
| 第二次摘要,对比只做一次摘要 | $0.0037283 | $0.0013925 | $0.0065302 | 多花 $0.0041844 |
第二行还包含其他 token 少花的 $0.0000100。摘要费用已经包含该请求自身的各类缓存用量,不要重复计算。token 分类用量无法指出哪些具体条目从未被复用。
回本公式与实测结果有多接近?
一个简单的热缓存模型可以估算还需要多少轮才能回本。设 H 为被替换的历史 token 数,S 为替换摘要的输入 token 数,A 为摘要请求的全部成本,r 为每个缓存读取 token 的价格,w 为每个缓存写入 token 的价格。被替换历史之前的不变指令应保留原样。
在未来 n 次请求中,保留历史的成本为 n*r*H。替换后的成本为 A + w*S + (n-1)*r*S。两者的增量差为:
compact cost minus retain cost
= A + (w-r)*S - n*r*(H-S)

payback turns
= ceil((A + (w-r)*S) / (r*(H-S)))
公式假设 H > S、替换内容立即满足缓存条件、价格不变,且后续新增内容、输出和工具工作相同。它不涵盖缓存过期、额外重写保留前缀或质量恢复成本。这些条件发生变化时,应分段计算成本。
我们在实验结束后才套用公式。计算输入来自预热和摘要调用的用量记录,而非后续费用,但此时实验结果已经已知。这是事后核验,不是留出验证或前瞻验证。分析用预热请求的总输入近似 H,用摘要输出 token 数近似 S;由于固定指令、请求包装和缓存资格的影响,它们并不等于实际可替换历史和替换内容输入的精确大小。
| 新增上下文速度 | 测试编号 | 事后估算 | 实测回本周期 |
|---|---|---|---|
| 约 96 token/轮 | 1 | 5 轮 | 6 轮 |
| 约 96 token/轮 | 2 | 5 轮 | 6 轮 |
| 约 1.4k token/轮 | 1 | 5 轮 | 5 轮 |
| 约 1.4k token/轮 | 2 | 4 轮 | 4 轮 |
| 约 5.2k-5.5k token/轮 | 1 | 5 轮 | 5 轮 |
| 约 5.2k-5.5k token/轮 | 2 | 4 轮 | 5 轮 |
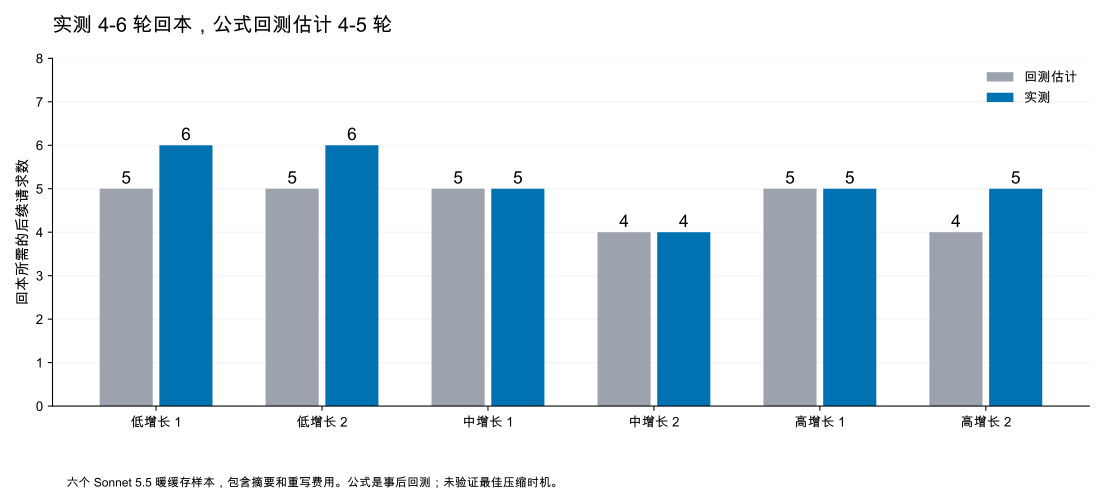
在这六次测试中,事后核验的误差最多为一轮。要用于未来决策,需要从以往摘要估算 A 和 S,并在新任务上验证;这次对比不提供通用的误差保证。
DeepSeek 的隐式缓存有什么不同?
没有单独的缓存写入费,不代表压缩后的输入免费。DeepSeek V4.1 Flash 1017 使用自动缓存,分别为命中和未命中的输入定价。其定价页没有列出单独的写入费用。新的摘要前缀未被缓存时,仍需按未命中输入价格付费。
缓存文档要求前缀与已持久化的前缀单元匹配。缓存构建需要数秒,命中不作保证,因此替换后可能不止一次请求未命中。跟踪 prompt_cache_hit_tokens 和 prompt_cache_miss_tokens,不要假设只有一次冷请求,也不要假设未变的系统前缀总能命中。
设 p 为每个未命中输入 token 的价格,m 为未来 n 次请求中替换前缀未命中的请求数。如果保留历史的基线始终命中缓存,且后续共同成本相抵:
compact cost minus retain cost
= A + m*(p-r)*S - n*r*(H-S)
只有一次冷请求时,用 p 替换 w,而不是用零。如果 m 未知,就计算多种情景,或按实际命中和未命中的用量分类计费,包括固定前缀和摘要调用的未命中部分。
以下是公式计算,不是 DeepSeek 实验。采用官方 Flash 非高峰价格:命中输入 $0.003/M、未命中输入 $0.15/M、输出 $0.60/M。假设摘要为 1k token,原始历史已预热,替换后有一次冷请求,摘要成本为 A = r*H + output_price*S。忽略请求包装、推理和工具。
| 原始历史 | 假定的摘要调用成本 | 计算所得回本周期 |
|---|---|---|
| 10k token | $0.000630 | 29 次请求 |
| 100k token | $0.000900 | 4 次请求 |
读取价格低时,保留较短的缓存历史可能更划算;任务较长时,压缩则可能回本。我们没有实测 DeepSeek 的质量和回本周期。高峰价格或混合费率会话需要重新计算。
上下文增长如何影响压缩时机?
增长会改变决策时的历史长度。如果压缩前经过 j 轮,每轮新增 g 个 token,就将 H_j = H_0 + g*j 连同当前摘要大小和成本代入回本公式。
后续相同的增长会给两种方案增加相同成本。价格和缓存行为不变时,这些项可以相抵。增长越快,就越早触及容量或价格约束,但增长速度本身不能决定回本轮数。
在增长测试中,关键状态始终较小,增加的主要是归档内容。在两次十二轮测试中,中等增长速度下重复压缩比只生成一次摘要更贵,高增长速度下则更便宜。包括扩展测试在内,所有策略都正确回答了 96/96 个状态查询;这并未检验关键状态无限增长的情况。
对持续执行的任务,模型建议多久压缩一次?
对于增长速度、摘要大小、价格和缓存行为大致恒定的长期任务,设 F 为每个压缩周期的固定费用,包括摘要输出和替换内容的重写。排除随间隔线性增长的成本,因为这些成本摊到每轮后是常数。摘要模型从缓存读取历史时,可将 F 估算为 A - r*H + w*S;其他定价方式需要单独拆分。如果 g 为每轮增长量,k 为两次摘要之间的间隔,则与间隔有关的平均成本为:
average interval-dependent cost = F/k + r*g*(k-1)/2
candidate interval k = sqrt(2*F/(r*g))
candidate history threshold = S + g*k
这要求 F、r 和 g 为正,保留的摘要较小,且任务质量可比。增长为零时,没有由增长驱动的周期性触发条件;读取免费时,这个模型也无法通过节省读取费用回本。按我们的显式缓存价格和摘要大小计算,低、中、高增长速度对应的候选间隔分别约为 30、7-8 和 4 轮。应在容量余量允许的前提下,测试附近的整数间隔,最小为一次请求;我们没有遍历不同间隔来证明这些值最优。按未命中输入计费的缓存,需要单独拆分固定成本。
下面用一组实测值说明单位。一次中等增长速度测试中,记录值为 A = $0.0049761、H = 13,712、S ≈ 341,以及 g ≈ 1,396 tokens/turn。使用 r = $0.10/M 和 w = $2.50/M,得到:
F ≈ 0.0049761 - (0.10/1,000,000)*13,712
    + (2.50/1,000,000)*341
  = $0.0044574 per cycle

k ≈ sqrt(2*0.0044574 / ((0.10/1,000,000)*1,396))
  ≈ 8 requests
这只是根据记录值算出的候选间隔,并不能证明每八次请求压缩一次是最优策略。剩余任务长度需要单独检查:如果预计一次压缩需要五次请求回本,但只剩三次请求,即使周期计时器提示该压缩了,也应跳过这次非必要操作。
任务接近结束时,如果剩余请求不足以收回成本,就不要再做非必要摘要。容量、计费档位和必要信息保留要求,优先于这个简化的费用模型。
一项短档案任务说明了这项判断的作用。两种策略都正确回答了六个数量问题,但保留历史只花费 $0.0059911,包含摘要的方案花费 $0.0156941。六次查询不足以收回这次压缩成本。摘要保留了足够细节,不需要额外检索。回本周期取决于实际摘要和工作负载,不存在通用的四到六轮规则。
如何测量完整成本?
计入摘要、首次重写后的请求,以及所有后续请求。仅凭 prompt token 减少量或缓存命中率,无法证明节省了费用。
对于 Claude Sonnet 5.5,我们的核算价格为:普通输入 $2/M、五分钟缓存写入 $2.50/M、缓存读取 $0.10/M、输出 $10/M。缓存读取虽然便宜,但仍然收费。替换已预热的历史可能产生新的写入,而很短的摘要甚至可能达不到缓存条件。我们显式设置的内容块断点产生了可测量的缓存写入和读取;部分较短的压缩前缀,最初既未报告写入,也未报告读取。
下面的函数假设已指定前缀未缓存的请求次数。将显式写入价格或隐式缓存的未命中输入价格传给 cold_input_per_million:
import math


def payback_turns(summary_cost, history_tokens, summary_tokens,
                  read_per_million=0.10, cold_input_per_million=2.50,
                  cold_requests=1):
    if cold_requests < 0 or int(cold_requests) != cold_requests:
        raise ValueError("cold_requests must be a nonnegative integer")
    r = read_per_million / 1_000_000
    p = cold_input_per_million / 1_000_000
    if summary_cost < 0 or p < r:
        raise ValueError("Unsupported cost assumptions")
    if history_tokens <= summary_tokens or r <= 0:
        return None
    upfront = summary_cost + cold_requests * (p - r) * summary_tokens
    saving_per_turn = r * (history_tokens - summary_tokens)
    return max(1, cold_requests, math.ceil(upfront / saving_per_turn))
在压缩前做决策时,应根据以往调用估算摘要成本。用完整的用量记录验证结果,包括失败和恢复工作;缺失用量记录不代表请求免费。
测量于 2026 年 11 月 4 日通过网关的 Messages 接口进行,关闭 thinking,未使用托管工具。普通回复的输出上限为 128 token,摘要为 2,048。成本根据返回用量和标准价格重算,并与网关报告费用核对,但没有与供应商账单对账。普通工作负载测试的是客户端摘要,而非原生压缩实现。
应该部署什么策略?
先满足容量和计费约束,为输入、工具和输出预留空间。对于 Claude Sonnet 5.5 的显式缓存工作负载,应计入写入溢价和摘要费用,并跳过那些不太可能在任务完成前回本的非必要压缩。使用相同的任务到达序列和结束轮次,验证解析候选值附近的整数间隔。
对于 DeepSeek V4.1 Flash 1017 的隐式缓存,如果命中稳定、剩余工作很少,可以保留有用的前缀。把软容量触发点设得晚一些可能合理,但没有单独写入费,不代表应该等到硬上限。对于较长任务,应估算实际命中和未命中成本,并在重写后持续观察请求,直到出现缓存命中。
价格、缓存状态、模型或关键状态大小变化时,应重新计算。保留可检索的源记录;对细节敏感的任务,逐项核验发生变化的值。将摘要及后续用量记录在同一个智能体会话中,并正确使用 token 用量分类。
常见问题
上下文压缩总能降低 API 成本吗?
节省的费用必须超过摘要、缓存重建和恢复成本。我们的六查询档案任务中,摘要方案花费 $0.0156941,保留历史花费 $0.0059911,准确率均为 6/6。
应该恰好在计费阈值处压缩吗?
计费阈值是评估全部剩余工作成本的时点,不是自动生成摘要的指令。在我们的 Claude Haiku 5.5 示例中,摘要本身按超过 100,000 token 的价格计费;后续一次查询基本持平,两次查询则明确回本。
可以等上下文窗口满了再处理吗?
要为摘要请求、下一次输入或工具结果,以及输出预留空间。历史已经过长时,摘要请求本身也可能放不下。我们没有测量最大窗口的失败边界。
上下文增长越快,一次摘要就一定越早回本吗?
两种方案共有的增长越快,双方成本都会上升,但不一定增加一次摘要带来的节省。重复压缩可以限制后续累积,却也会增加摘要和重写费用。在我们的中等增长速度测试中,十二轮内重复压缩比只做一次摘要更贵;高增长速度测试则更适合重复压缩。应结合增长速度、剩余任务长度和必须保留的状态选择策略。
使用隐式缓存时,应该等到上下文上限再压缩吗?
任务较短时,隐式缓存可能让保留低成本的热缓存历史更划算。DeepSeek V4.1 Flash 1017 对未缓存的摘要前缀仍收取未命中输入费用,而且不保证持久化成功。应先估算剩余收益,再在支持的窗口内为工具、输入和输出留出空间。上文的 DeepSeek 数值是计算结果,不是实测阈值。