
GPT-6.1 Terra 對比 GPT-5.6 Terra 與 Sol:192 次 API 呼叫
目錄
GPT-6.1 Terra 是 OpenAI 針對視覺工作流程推出的低成本模型,每百萬輸入權杖 $1、每百萬輸出權杖 $5,費率是 GPT-6.1 Sol 的一半。推理強度控制模型回答前的內部推理量。設為 none 就會停用推理;其他設定產生的推理權杖則計入輸出費用。在我們的測試中,關閉推理後,16 項表格與按鈕選擇任務全部通過,但發票影像計算只通過 3/8,對應的文字計算則是 0/8。
TL;DR
- 在我們的合成測試中,GPT-6.1 Terra
none通過 16/16 項表格與螢幕截圖任務,但發票影像計算只通過 3/8。 - GPT-6.1 Terra
low通過 24/24 項影像任務與 7/8 項對應的文字發票任務;medium則分別通過 24/24 與 8/8。 - 處理 24 張影像,GPT-6.1 Terra
medium花費 $0.028290;GPT-6.1 Sollow花費 $0.055012。 - 在另一輪條件一致的測試中,處理 24 張影像,GPT-6.1 Terra
medium花費 $0.028269;GPT-5.6 Terra 花費 $0.072094。
GPT-6.1 Terra 在 OpenAI 模型系列中的定位
GPT-6.1 Terra 主打視覺推理、螢幕操作與精簡寫作,價格低於 GPT-6.1 Sol。OpenAI 於 2026 年 10 月 26 日發布 Terra。模型選擇指南建議將它用於定義明確、結果可驗證的任務,包括螢幕操作流程與範圍明確的程式碼修正。複雜專案仍以 Sol 作為較通用的選項。
GPT-5.6 Terra 是前一代模型,用來判斷是否值得升級。Sol 則是目前價格較高的替代選項,用來判斷該選哪個模型等級。這三個模型對應兩種決策:
| 規格 | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| 本次比較的定位 | 前一代基準 | 新一代視覺工作流程模型 | 複雜工作的高價選項 |
| 每 1M 權杖的標準輸入價格 | $2 | $1 | $2 |
| 每 1M 權杖的標準輸出價格 | $12 | $5 | $10 |
| 每 1M 權杖的快取輸入讀取價格 | $0.20 | $0.05 | $0.10 |
| 上下文視窗 | 1,050,000 權杖 | 1,050,000 權杖 | 1,050,000 權杖 |
| 最大輸出 | 128,000 權杖 | 128,000 權杖 | 128,000 權杖 |
| 推理設定 | none, low, medium, high, xhigh, max | none, low, medium, high, xhigh, max | low, medium, high, xhigh, max |
| 預設推理設定 | medium | medium | medium |
| 輸入/輸出模態 | 文字與影像/文字 | 文字與影像/文字 | 文字與影像/文字 |
| 測試使用的端點 | Responses API | Responses API | Responses API |
資料來源:官方 GPT-5.6 Terra 參考文件、GPT-6.1 Terra 參考文件、Sol 參考文件與版本更新紀錄。上述價格適用於輸入不超過 272,000 權杖的 Standard 請求。超過此門檻後,整個請求的未快取輸入費率加倍,輸出費率提高 50%。快取寫入另有定價;我們量測的主要請求都未回報快取讀取或寫入。
新 Terra 保留了前一代的上下文視窗、輸出上限與推理設定名稱。牌價中的輸入價格降低 50%,輸出價格降低 58.3%。本文後面的同條件升級測試,會將降價效果與權杖用量、任務正確率的變化分開比較。
官方基準測試顯示了什麼?
OpenAI 在發布時比較了 GPT-6.1 Terra、GPT-5.6 Terra 與 GPT-6.1 Sol。發布內容實際公布的資訊如下:
| 評測 | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| Agents’ Last Exam:專業視覺工作流程 | 基準;未公布絕對分數 | medium 比前一代高 15 個百分點,任務成本約為三分之一 | 未公布絕對分數 |
| MMMU-Pro:視覺推理 | 在所有公布的設定下均低於新 Terra;未公布分數 | 接近 Sol;未公布分數 | 官方描述為新 Terra 幾乎追平;未公布分數 |
| Terminal-Bench 4.0:終端機程式設計任務 | 公布分數為 21.5%;未註明推理強度 | max 為 50.3% | 未公布分數 |
| 內部事實正確性測試:錯誤率越低越好 | low 錯誤率為 53.6% | low 錯誤率為 16.7% | 未公布 low 錯誤率 |
資料來源:OpenAI 發布時的評測。缺漏的分數仍未公布;事實正確性評測屬於內部測試。下方的 API 測試使用相同的合成任務,檢視升級與模型等級的選擇。
我們如何測試推理設定?
我們測試了 GPT-6.1 Terra 的 none、low、medium,以及 GPT-6.1 Sol 的 low。每組設定各使用 32 筆輸入:24 張影像與 8 筆對應的文字對照資料,主要測試共 128 次呼叫。另外再以相同的 32 筆輸入,交錯呼叫 GPT-5.6 Terra 與新一輪 GPT-6.1 Terra,兩者都設為 medium。升級比較因此增加 64 次呼叫,合計 192 次。升級比較表只使用這個獨立批次的結果。
| 任務類型 | 每組設定的輸入數 | 要求的結果 |
|---|---|---|
| 發票影像 | 8 | 計算各品項金額、扣除折扣、計算稅額並四捨五入,再扣除訂金 |
| 篩選表格 | 8 | 彙總符合區域與季度的資料,再計算退貨率 |
| 應用程式螢幕截圖 | 8 | 從相似卡片中找出正確的控制項 ID,以及該按鈕內的一個座標點 |
| 發票文字對照組 | 8 | 根據精確轉錄的文字,計算相同的發票數值 |
我們用三種範本產生答案已知的虛構文件,並變更數值或版面配置。每張影像都是 960 × 640 像素,提交時使用 detail: "high"。同一張發票的影像版與文字版使用相同的任務指示、結構描述與業務規則。每筆輸入在每組設定下各取得一次回應。
測試於 2026 年 10 月 29 日透過 Synthorai 執行,使用串流 Responses 請求,統一將輸出上限設為 4,096 權杖,並交錯執行各組設定。主要測試的 128 次回應全部完成,且傳回符合結構描述的 JSON。只有所有要求的數值都吻合,才算任務完全成功;螢幕截圖的座標必須落在正確按鈕內。我們以程式評分,金額使用整數分,並採十進位捨入,不使用模型評審。
這 24 張影像代表三種任務範本,而不是 24 種不同工作。我們將主要測試與升級測試的 16 組配對比較一起套用 Holm 法校正,以處理多重檢定;校正後沒有任何 p 值低於 0.05。下列數據只描述這次執行結果,不能據此建立一般性的品質排名,也不能證明模型等效。
關閉推理後發生了什麼?
GPT-6.1 Terra 設為 none 時,8 項發票影像計算錯了 5 項,8 項文字發票計算則全部錯誤。在同一輪推理強度測試中,low 的發票影像成績為 8/8,文字對照組為 7/8;medium 兩者都是 8/8。跨模型結果整理在下方的三模型比較表。
純文字輸入也出錯,表示不能將所有失敗都歸因於影像辨識。這 8 組配對輸入也不足以證明影像格式具有優勢。
以下這張發票可以具體說明問題:
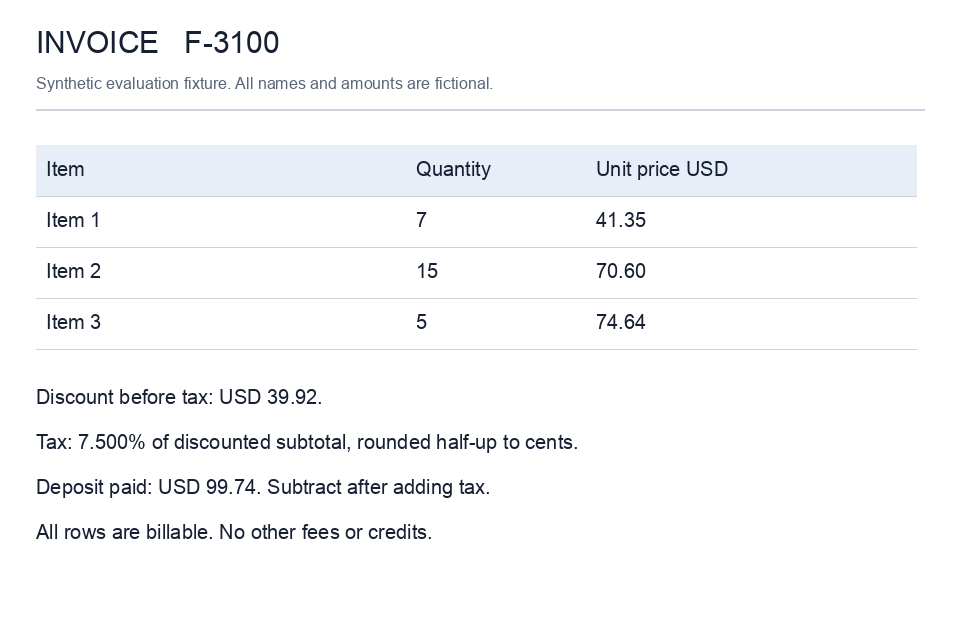
各品項金額為 7 × $41.35、15 × $70.60,以及 5 × $74.64,小計為 $1,721.65。扣除 $39.92 折扣後,以 7.5% 計稅並四捨五入,稅額為 $126.13;再扣除 $99.74 訂金,應付餘額為 $1,708.12。
在文字版本中,Terra low 傳回的小計為 $1,711.65、稅額為 $125.38、應付餘額為 $1,697.37。JSON 符合結構描述,但算術錯了。提高推理強度是可以評估的變因之一;光有型別明確的輸出,並不能驗證金額。
在最初的核心測試中,四組設定都通過了 8 項篩選表格任務與 8 項按鈕選擇任務。這些範本在該輪測試中未能區分品質;完成數的差異來自發票錯誤。
三個模型在這些任務上的表現如何?
GPT-5.6 Terra 與 GPT-6.1 Terra 都以 medium 比較;GPT-6.1 Sol 則使用 low,作為實務上的模型等級比較。我們以 Terra medium 作為主要的等級選擇建議,因為它在文字發票上的成績為 8/8,low 則是 7/8;Sol 使用已測試的 low 設定。這是在不同推理強度下比較候選設定,不是在相同推理強度下比較品質。只差一項任務,不能證明 medium 普遍比較準確。
核心測試 指最初的推理強度測試。升級測試 指另外執行的新舊 Terra 比較。新 Terra 的量測結果若在兩輪中不同,表內會分別列出。升級建議使用升級測試數據;Terra 與 Sol 的選擇建議使用核心測試數據。下文沒有任何成本或延遲比值混用不同批次。
| 指標 | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| 設定 | medium,升級測試 | medium,核心與升級測試 | low,核心測試 |
| 發票影像答對數 | 8/8 | 每輪皆為 8/8 | 8/8 |
| 對應文字發票答對數 | 8/8 | 每輪皆為 8/8 | 8/8 |
| 篩選表格答對數 | 8/8 | 每輪皆為 8/8 | 8/8 |
| 螢幕截圖任務完全正確數 | 2/8 | 每輪皆為 8/8 | 8/8 |
| 所有影像任務答對數 | 18/24 | 每輪皆為 24/24 | 24/24 |
| 24 張影像的成本 | $0.072094 | 核心:$0.028290;升級:$0.028269 | $0.055012 |
| 相同影像用量按每 1M 權杖輸入 $1/輸出 $5 計價 | $0.033500 | 核心:$0.028290;升級:$0.028269 | $0.027506 |
| 每項正確影像任務的成本 | $0.004005 | 核心:$0.001179;升級:$0.001178 | $0.002292 |
| 影像回應時間中位數 | 2.57 秒 | 核心:5.75 秒;升級:6.43 秒 | 4.51 秒 |
每項正確任務的成本,是總成本除以完全正確的回應數。它包含錯誤答案的成本,但不模擬重試。我們依傳回的用量,套用固定的 Standard 費率,推理權杖計入輸出權杖。獨立的函式呼叫探測不計入其中。回應時間是經過閘道的端到端時間;我們並未獨立固定模型服務的基礎設施。
舊 Terra 的 6 次失敗都傳回了正確按鈕內的座標,但沒有讀取畫面上的控制項 ID,而是自行編造 cobalt-edit 之類的 ID。這些都是必須精確吻合的欄位錯誤。在升級測試中,兩代模型設為 medium 時,都算對了所有發票。
在核心推理強度測試中,新 Terra none 處理 24 張影像花費 $0.024275,答對 19/24;low 花費 $0.027835,答對 24/24。換算後,每項正確影像任務的觀測成本,none 為 $0.001278,low 為 $0.001160。在這組資料中,none 的總支出較低,但每個成功結果的成本並沒有比較低。
該從 GPT-5.6 Terra 升級到 GPT-6.1 Terra 嗎?
如果你在意推論成本,或需要精確擷取視覺欄位,GPT-6.1 Terra 值得納入 GPT-5.6 Terra 的升級評估。在條件一致的 medium 測試中,影像任務成本降低 60.8%,完全正確數從 18/24 提高到 24/24。結果改變的 6 項任務都涉及畫面上的控制項 ID;經過統計校正後,這個樣本不足以證明新模型的整體品質較好。
舊模型的目前費率為每百萬輸入權杖 $2、每百萬輸出權杖 $12。新 Terra 分別降價 50% 與 58.3%。即使統一套用 $1/$5 費率,新模型的影像任務用量成本仍低 15.6%。輸入數量接近,分別為 20,765 與 20,789 權杖;輸出則從 2,547 降至 1,496 權杖。
對於有驗證機制的內部文件處理或欄位擷取,先沿用現有推理強度測試新模型,切換前檢查 ID 與金額是否精確。若是對延遲敏感的互動流程,應保留舊模型作為對照,直到新模型達到應用程式的回應時間目標:這輪測試中,舊模型的影像延遲中位數為 2.57 秒,新模型為 6.43 秒。發票若可能觸發付款,無論使用哪一代,都應保留確定性的算術運算與核准檢查。
該選 GPT-6.1 Terra 還是 GPT-6.1 Sol?
對這些範圍明確的視覺任務,GPT-6.1 Terra medium 是成本較低的候選設定;如果重視回應時間,或工作更複雜,則應保留 GPT-6.1 Sol low 作為比較。在核心測試中,兩者都答對 24/24 張影像,成本分別為 $0.028290 與 $0.055012。觀測到的 48.6% 節省,完全可由 Terra 低 50% 的輸入與輸出費率解釋:若將 Sol 的用量改按 $1/$5 計價,成本為 $0.027506,略低於 Terra 的 $0.028290。
對於有驗證機制的批次擷取,先用自己的範例評估 Terra,並比較錯誤類型。互動式工作流程則應將 Sol 觀測到的 4.51 秒中位數與 Terra 的 5.75 秒,對照產品實際的延遲目標。複雜程式設計與開放式代理專案,需要超出這三種範本、足以代表實際工作的評測;OpenAI 的模型選擇指南將 Sol 定位於複雜工作。這裡相同的完成數,不能作為兩者普遍等效的證據。
如何在 API 中設定推理強度?
使用 GPT-6.1 Terra 時,明確設定 reasoning.effort,並同時檢查答案與傳回的用量。GPT-6 指南列出的預設值是 medium,工具呼叫則必須使用 Responses。推理權杖會占用輸出額度,費用也已計入輸出權杖,不會再額外加算一次。
以下 Python 範例示範正式環境中的擷取模式,並非重現計算基準測試。安裝 openai、設定 OPENAI_API_KEY,並將上圖的發票存成 invoice.png。要求模型擷取品項與文件上列明的規則,缺少的欄位保留為 null。此處支援的規則是先扣折扣、再計稅並四捨五入到分,最後扣除訂金。
import base64
import json
from pathlib import Path
from openai import OpenAI

client = OpenAI(max_retries=0)
encoded = base64.b64encode(Path("invoice.png").read_bytes()).decode()
nullable_int = {"type": ["integer", "null"]}
rule = "discount_then_tax_half_up_then_deposit"
item_fields = {"quantity": nullable_int, "unit_price_cents": nullable_int}
properties = {
    "currency": {"type": ["string", "null"]},
    "items": {"type": "array", "items": {
        "type": "object", "properties": item_fields,
        "required": list(item_fields), "additionalProperties": False,
    }},
    "discount_cents": nullable_int,
    "tax_rate": {"type": ["string", "null"]},
    "deposit_cents": nullable_int,
    "calculation_rule": {"type": ["string", "null"],
                         "enum": [rule, "other", None]},
}
response = client.responses.create(
    model="gpt-6.1-terra",
    reasoning={"effort": "medium"},
    max_output_tokens=4096,
    store=False,
    input=[{"role": "user", "content": [
        {"type": "input_text", "text": (
            "Extract the printed invoice fields, not calculated totals. "
            "Use integer cents for prices, discount, and deposit, and an "
            "ISO currency code. Express the tax rate as a decimal string "
            "(7.5% becomes 0.075). Use null for missing or ambiguous fields. "
            f"Set calculation_rule to {rule} only when the printed rules "
            "explicitly match; use other for a different rule and null "
            "if unclear. Do not invent rules or default amounts to zero."
        )},
        {"type": "input_image", "detail": "high",
         "image_url": "data:image/png;base64," + encoded},
    ]}],
    text={"format": {
        "type": "json_schema", "name": "invoice_fields", "strict": True,
        "schema": {"type": "object", "properties": properties,
                   "required": list(properties), "additionalProperties": False},
    }},
)
if response.status != "completed":
    raise RuntimeError(f"Incomplete response: {response.status}")
if not response.output_text:
    raise RuntimeError("No invoice JSON returned; inspect refusal/error output")
extracted = json.loads(response.output_text)
print(extracted)
usage = response.usage
if usage is not None:
    reasoning = getattr(usage.output_tokens_details, "reasoning_tokens", None)
    print({"input_tokens": usage.input_tokens,
           "output_tokens": usage.output_tokens,
           "reasoning_tokens": reasoning})
我們也針對原始核心測試的四組設定,另外執行本機函式呼叫探測:新 Terra 的 none/low/medium,以及 GPT-6.1 Sol 的 low。流程是選取螢幕截圖中的控制項、讀取實際儲存的選擇,再傳回驗證過的結果。四組都正確完成強制的三輪流程,合計 12 個 API 回合。函式結果使用相符的呼叫 ID,並重播輸出項目。這只是本機相容性探測,不是自主桌面操作基準測試。
正式環境該如何驗證發票金額?
發票入帳與付款應先擷取型別明確的運算元,再用確定性的程式碼計算總額。無論哪個模型在成本或延遲比較中勝出,都要驗證來源欄位,並在資金移轉前取得核准。
在擷取範例之後執行這段程式碼。它會拒絕缺漏或不支援的輸入,並計算圖中發票的總額。用整數分表示金額,可避免二進位浮點數誤差;Decimal 則套用指定的稅額捨入規則。
from decimal import Decimal, InvalidOperation, ROUND_HALF_UP


def invoice_totals(data):
    if data.get("currency") != "USD" or data.get("calculation_rule") != rule:
        raise ValueError("Missing or unsupported currency/calculation rule")
    items = data.get("items")
    if not isinstance(items, list) or not items:
        raise ValueError("Missing line items")
    for item in items:
        if (not isinstance(item, dict)
                or type(item.get("quantity")) is not int
                or item["quantity"] <= 0
                or type(item.get("unit_price_cents")) is not int
                or item["unit_price_cents"] < 0):
            raise ValueError("Invalid or missing line-item values")
    for key in ("discount_cents", "deposit_cents"):
        if type(data.get(key)) is not int or data[key] < 0:
            raise ValueError(f"Invalid or missing {key}")
    if not isinstance(data.get("tax_rate"), str):
        raise ValueError("Missing tax rate")
    try:
        rate = Decimal(data["tax_rate"])
    except InvalidOperation as exc:
        raise ValueError("Invalid tax rate") from exc
    if not rate.is_finite() or not Decimal(0) <= rate <= Decimal(1):
        raise ValueError("Unsupported tax rate")
    subtotal = sum(i["quantity"] * i["unit_price_cents"] for i in items)
    taxable = subtotal - data["discount_cents"]
    if taxable < 0:
        raise ValueError("Discount exceeds subtotal")
    tax = int((Decimal(taxable) * rate).quantize(
        Decimal("1"), rounding=ROUND_HALF_UP
    ))
    return {"subtotal_cents": subtotal, "tax_cents": tax,
            "balance_due_cents": taxable + tax - data["deposit_cents"]}


calculated = invoice_totals(extracted)
print({"source_fields": extracted, "calculated_totals": calculated})
這份輸出可供審核,不能直接自動入帳。型別與規則檢查無法證明價格讀取正確:核准付款前,必須將擷取欄位與原始文件核對,並審查有歧義的條款。擷取範例是一種實作模式;我們量測的 192 次呼叫,測試的是前述計算提示詞。
相關量測可參考影像輸入計費指南、PDF 不同輸入表示方式的成本測試,以及同價位模型比較。
常見問題
從 GPT-5.6 Terra 升級到 GPT-6.1 Terra 值得嗎?
在我們條件一致、同為 medium 的測試中,GPT-6.1 Terra 的影像任務成本比 GPT-5.6 Terra 低 60.8%;若兩者都套用每百萬輸入權杖 $1/輸出權杖 $5 的費率,則低 15.6%。兩者都通過全部發票計算;舊模型讀錯了 6 個畫面上的控制項 ID。新模型觀測到的延遲中位數較長,因此升級決策也必須納入回應時間驗證。
該選 GPT-6.1 Terra 還是 GPT-6.1 Sol?
GPT-6.1 Terra medium 處理 24 項影像任務花費 $0.028290,GPT-6.1 Sol low 則為 $0.055012;在核心測試中,兩者都是 24/24。對有驗證機制的批次工作,可評估 Terra;互動式工作則應納入 Sol 比較,兩者回應時間中位數分別為 5.75 與 4.51 秒。這些合成任務無法證明兩者整體品質等效。
處理發票時可以關閉推理嗎?
在我們的核心測試中,GPT-6.1 Terra 設為 none 時,發票影像只答對 3/8,對應的文字計算則是 0/8。精確金額計算應留在程式碼中,並驗證擷取的運算元。對範圍明確的表格或按鈕選擇任務,none 在此通過 16/16,可以納入特定工作負載的評估。