
GPT Image 2.6 Sunburst vs Flare vs GPT Image 2 em edições
Conteúdo
- O que mudou no GPT Image 2.6?
- Como GPT Image 2, 2.5 e 2.6 se comparam no Arena?
- Como GPT Image 2, Sunburst e Flare lidaram com as mesmas edições?
- Quanto tempo os três modelos levaram para editar a programação?
- A complexidade alta melhorou a edição da programação?
- Quando uma marcação ajuda o GPT Image 2.6 a escolher o objeto certo?
- Como as edições foram testadas?
- Perguntas frequentes
- A comparação com o GPT Image 2 usa o mesmo nível de planejamento?
- O GPT Image 2.5 foi testado pelo Synthorai?
- Quando devo usar marcação em uma edição de imagem?
- A complexidade alta tornou as edições da programação mais confiáveis?
GPT Image 2 e as duas variantes do GPT Image 2.6 atualizaram três campos no mesmo rótulo de alimento sem alterar o texto ao redor. Em uma programação de conferência, Sunburst passou em 2/4 renderizações com complexidade média. Flare em complexidade média e GPT Image 2 com o planejamento padrão passaram em 0/4. A tarefa era trocar duas palestras de posição e fazer o selo FULL acompanhar uma delas.
TL;DR
- GPT Image 2 e as duas variantes 2.6 passaram na mesma edição de rótulo.
- Na programação, Sunburst passou em 2/4 com complexidade média. GPT Image 2 e Flare passaram em 0/4.
- Sunburst passou em 2/4 renderizações da programação com
complexitymédia e alta. Flare trocou corretamente as duas palestras em 0/4 renderizações com complexidade média e 2/4 com complexidade alta, mas não passou por completo em nenhuma configuração. - Uma indicação visual aumentou a seleção correta do alvo de 1/4 para 4/4 quando o texto não informava a posição.
O que mudou no GPT Image 2.6?
A OpenAI lançou o Images 2.6 em 4 de novembro de 2026. O Sunburst é voltado a trabalhos detalhados e à consistência entre edições, enquanto o Flare prioriza iterações mais rápidas. O lançamento também levou anotações visuais à API, adicionou um controle de planejamento e introduziu opções de saída em GIF e SVG. Notas de lançamento da OpenAI
A configuração complexity controla o planejamento anterior à renderização. A configuração separada quality controla o nível de detalhe da renderização. A documentação da OpenAI define três níveis de planejamento: low, medium e high. Na API, o padrão é high. Nas requisições para os modelos 2.6, definimos explicitamente os dois parâmetros. Guia de geração de imagens da OpenAI
Como GPT Image 2, 2.5 e 2.6 se comparam no Arena?
Os números do GPT Image 2.5 vêm exclusivamente do ranking público do Arena para edição de uma única imagem. Na captura de 12 de novembro de 2026, as duas entradas 2.5 tinham pontuações exibidas superiores às das entradas 2.6 Medium. As notas do Arena refletem a preferência dos votantes. As entradas têm quantidades de votos e rótulos de configuração diferentes. As pontuações abaixo mantêm a incerteza exibida pelo Arena. Ranking do Arena para edição de uma única imagem
| Entrada no Arena | Pontuação exibida | Votos |
|---|---|---|
| GPT Image 2.5 Sunburst | 1519 ± 5 | 131,648 |
| GPT Image 2.5 Flare | 1484 ± 4 | 128,720 |
| GPT Image 2.6 Sunburst (Medium) | 1476 ± 11 | 3,493 |
| GPT Image 2 (Medium) | 1462 ± 3 | 364,695 |
| GPT Image 2.6 Flare (Medium) | 1460 ± 10 | 3,534 |
“Medium” é o rótulo usado pelo Arena. Em nosso teste pelo gateway, a requisição ao GPT Image 2 omitiu o campo complexity.
Como GPT Image 2, Sunburst e Flare lidaram com as mesmas edições?
Os três modelos passaram na edição do rótulo. O GPT Image 2 e as duas variantes 2.6 alteraram corretamente o valor de sódio, o código do lote e o peso líquido. Todos preservaram o texto ao redor. Sunburst e Flare também passaram nas seis edições simples. Nas tarefas com tampa de garrafa e selo de referência, os dois preservaram os demais detalhes quando receberam uma indicação clara da posição.
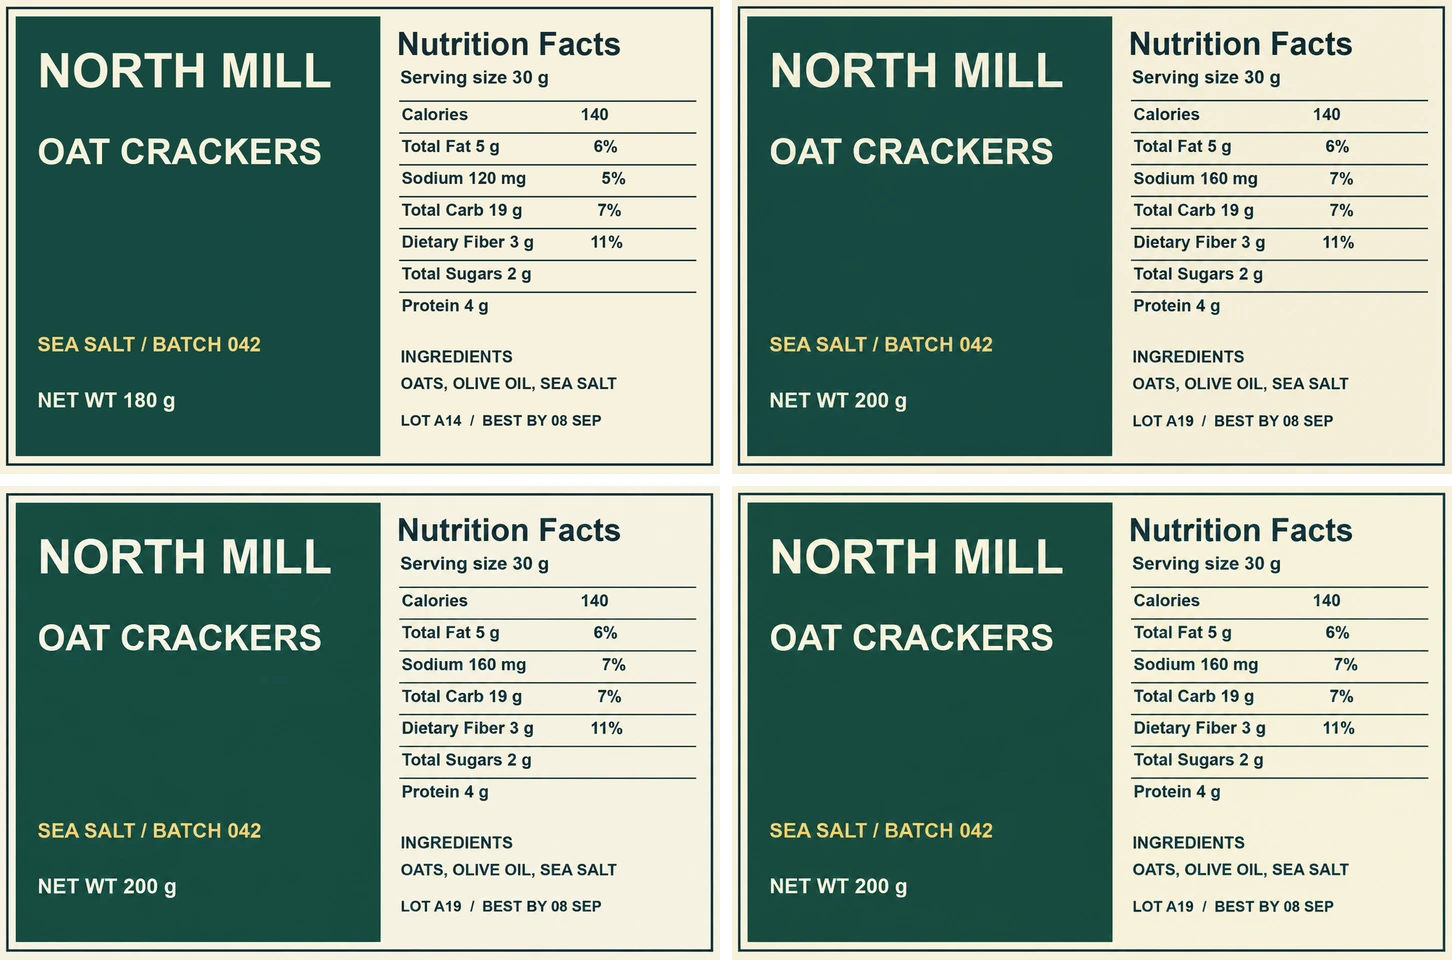
Linha superior: original e GPT Image 2. Linha inferior: Sunburst e Flare. O GPT Image 2 usa o planejamento padrão, e as duas variantes 2.6 usam complexidade média.
Na programação, pedimos que cada modelo trocasse os títulos e palestrantes do Studio B às 10:00 e do Studio C às 11:30. Depois, deveria adicionar FULL ao Sound Lab em sua nova posição. O GPT Image 2 manteve o Sound Lab na posição original em todas as tentativas e trocou outras duas palestras. Sunburst moveu corretamente as duas palestras solicitadas nas quatro renderizações com complexidade média. Em duas delas, o selo ficou na posição antiga.
| Modelo | Configuração de planejamento | Rótulo, aprovação completa | Programação, ambas as palestras nas posições corretas | Programação, aprovação completa |
|---|---|---|---|---|
| GPT Image 2 | Padrão, campo omitido | 1/1 | 0/4 | 0/4 |
| GPT Image 2.6 Sunburst | Medium | 1/1 | 4/4 | 2/4 |
| GPT Image 2.6 Flare | Medium | 1/1 | 0/4 | 0/4 |
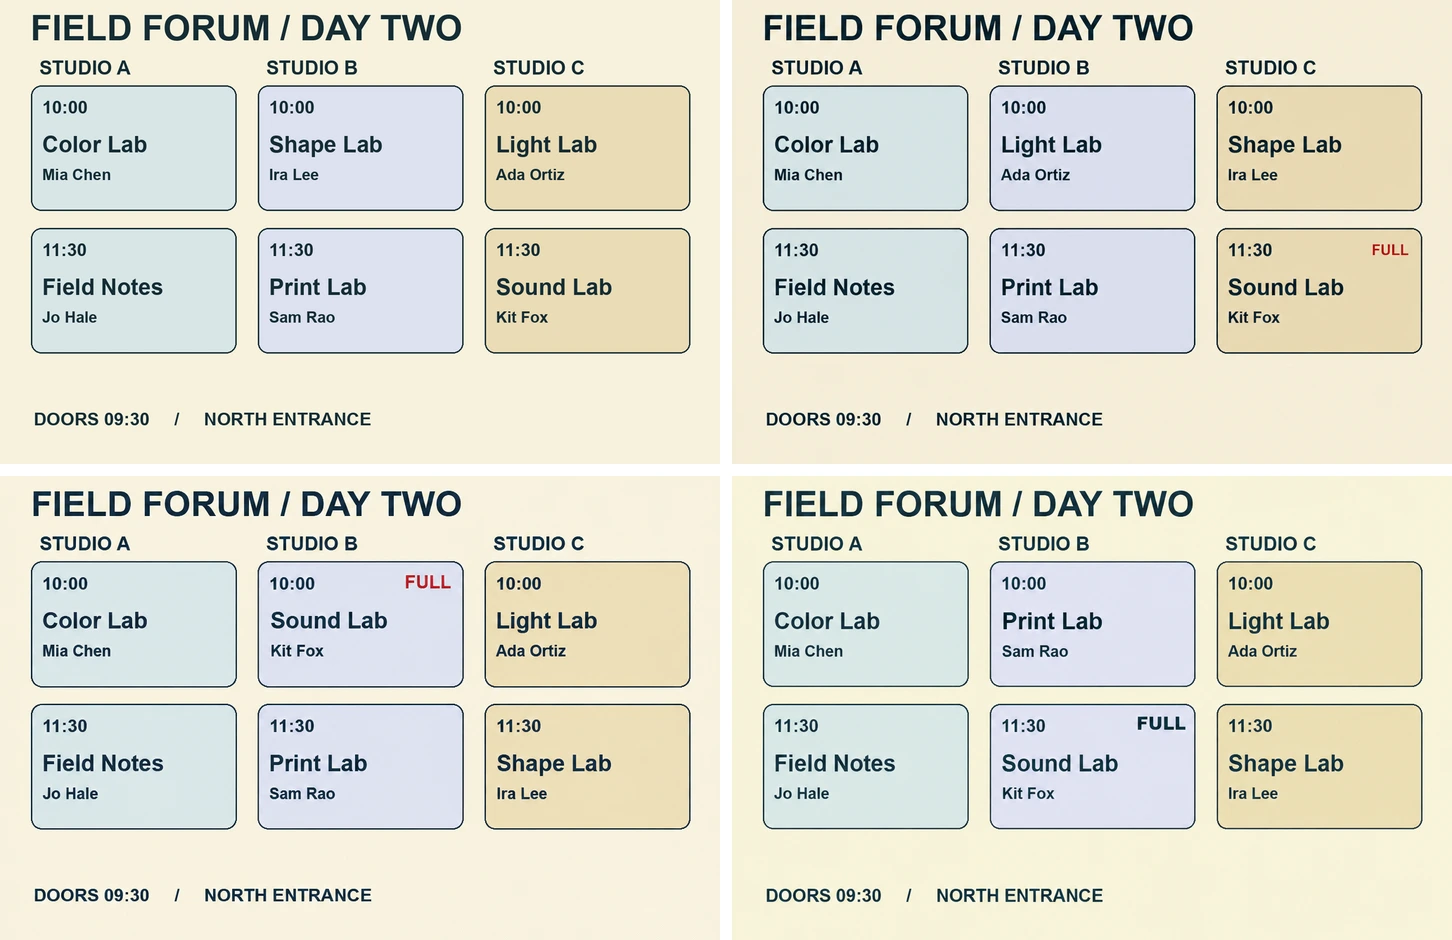
Linha superior: original e GPT Image 2. Linha inferior: uma renderização do Sunburst e uma do Flare. A tabela inclui as quatro renderizações de cada modelo. O GPT Image 2 usa o planejamento padrão, e as duas variantes 2.6 usam complexidade média.
Os três modelos receberam as mesmas imagens de origem e os mesmos prompts pelo Synthorai, com o mesmo tamanho de saída e quality: "medium". A requisição ao GPT Image 2 omitiu complexity. Para esta tabela, as duas requisições aos modelos 2.6 definiram explicitamente complexity: "medium". O nível de planejamento efetivo do GPT Image 2 é desconhecido. Portanto, a tabela compara as três configurações de API exatamente como foram executadas. Cada resultado do rótulo vem de uma renderização. Cada resultado da programação vem de quatro tentativas com o mesmo layout.
Quanto tempo os três modelos levaram para editar a programação?
Com a mesma imagem e o mesmo prompt, o Flare retornou uma imagem em uma mediana de 7.5 segundos. O Sunburst levou 18.9 segundos, e o GPT Image 2 levou 27.0 segundos. Cada mediana considera quatro respostas de API bem-sucedidas, enviadas pelo mesmo host de teste por meio do Synthorai. O tempo foi medido desde o envio da requisição até o recebimento da resposta completa com a imagem.
| Modelo e configuração de planejamento | Respostas bem-sucedidas | Mediana | Intervalo |
|---|---|---|---|
| GPT Image 2, padrão | 4 | 27.0 s | 26.0 a 47.5 s |
| GPT Image 2.6 Sunburst, medium | 4 | 18.9 s | 18.3 a 21.3 s |
| GPT Image 2.6 Flare, medium | 4 | 7.5 s | 7.2 a 8.0 s |
Os tempos representam a latência de ponta a ponta de uma edição com qualidade de renderização média. O GPT Image 2 foi executado em um lote separado, sem informar o campo de planejamento.
A complexidade alta melhorou a edição da programação?
Flare trocou corretamente as duas palestras em duas renderizações com complexidade alta e em nenhuma com complexidade média. Cada modelo teve a mesma quantidade de aprovações completas nas duas configurações. A tarefa exigia manter duas alterações vinculadas. Primeiro, trocar os títulos e palestrantes do Studio B às 10:00 e do Studio C às 11:30, mantendo cada sala e horário em sua posição original. Depois, adicionar FULL ao cartão que passou a conter Sound Lab. Uma renderização podia trocar as duas palestras corretamente e ainda colocar FULL na posição antiga.
Foi o que ocorreu no exemplo do Sunburst abaixo. As duas renderizações moveram Sound Lab para o Studio B às 10:00 e Shape Lab para o Studio C às 11:30. A renderização com complexidade média colocou FULL no Sound Lab. A de complexidade alta colocou o selo no Shape Lab, na posição que antes continha Sound Lab.
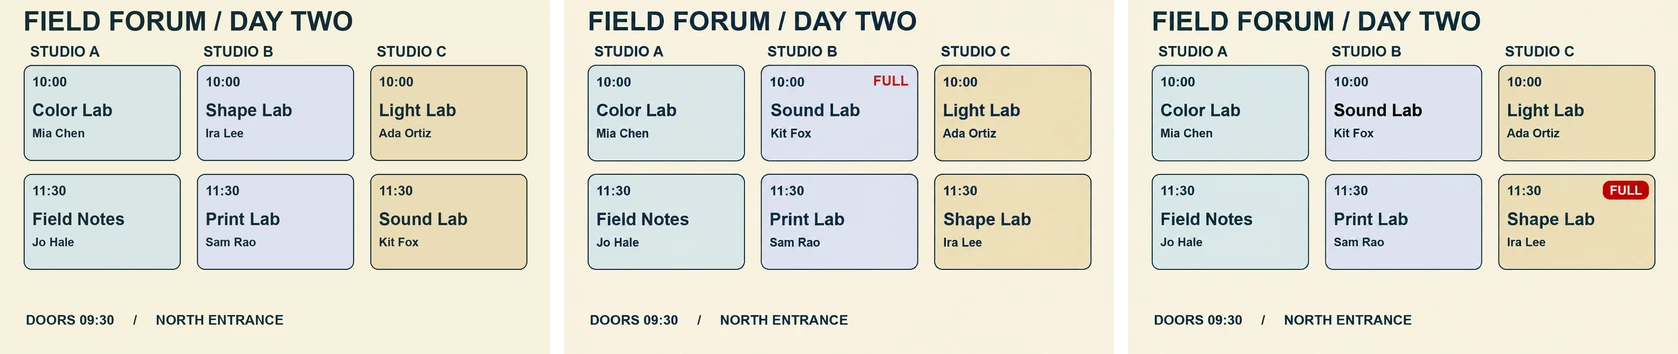
Da esquerda para a direita: programação original, uma renderização correta do Sunburst com complexidade média e uma renderização com complexidade alta que mantém o selo na posição antiga.
As 16 renderizações usaram a mesma programação de origem, com quatro saídas por modelo e configuração de complexidade.
| Modelo | Média, ambas as palestras trocadas corretamente | Média, aprovação completa | Alta, ambas as palestras trocadas corretamente | Alta, aprovação completa |
|---|---|---|---|---|
| Sunburst | 4/4 | 2/4 | 4/4 | 2/4 |
| Flare | 0/4 | 0/4 | 2/4 | 0/4 |
Duas renderizações do Sunburst em cada configuração colocaram FULL no cartão errado. As duas renderizações do Flare com complexidade alta que trocaram corretamente as palestras também posicionaram o selo no lugar errado. Como foram apenas quatro renderizações por configuração em uma única programação, esses números descrevem esta edição específica. As 12 requisições repetidas informaram contagens idênticas de tokens de entrada e saída nas duas configurações.
Em um fluxo de publicação de eventos, confira cada posição afetada e valide o selo na imagem final antes de publicar. Se a programação vier de dados estruturados, renderize o texto e o selo a partir desses dados. Assim, o selo acompanha o evento quando ele muda de posição.
Quando uma marcação ajuda o GPT Image 2.6 a escolher o objeto certo?
A marcação ajudou quando a imagem continha vários alvos igualmente válidos e o texto não indicava qual escolher. Enviamos ao GPT Image 2.6 Sunburst e ao GPT Image 2.6 Flare uma grade com seis garrafas idênticas e pedimos que exatamente uma tampa fosse alterada para dourado polido. O texto foi o mesmo em todas as condições. Ele instruía o modelo a editar a tampa circulada caso houvesse uma anotação, sem indicar nenhuma posição por escrito.
Definimos as tampas central superior e inferior direita como alvos. Sem a sobreposição, qualquer coincidência com a tampa definida era acidental. Na figura abaixo, Flare escolheu a tampa central superior sem marcação. Com a sobreposição, editou a tampa inferior direita e manteve as outras cinco pretas.
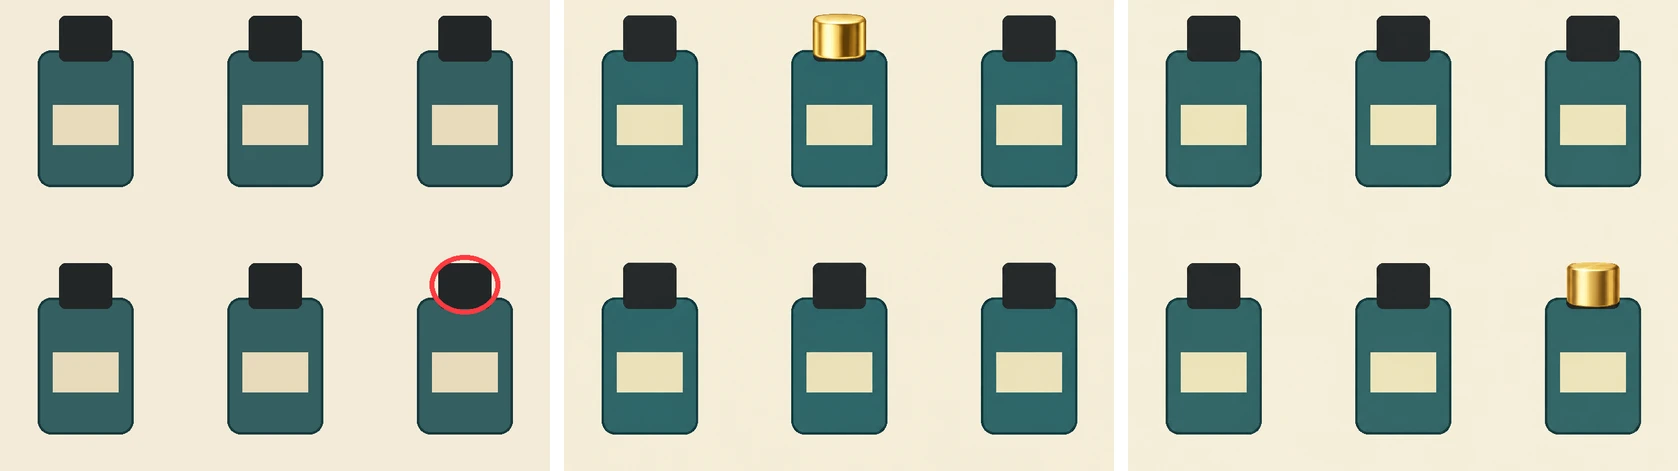
Da esquerda para a direita: entrada com a sobreposição exibida em vermelho, Flare sem marcação e Flare com marcação. A requisição enviou a imagem de origem e a sobreposição como entradas separadas.
| Tampa definida | Sunburst sem marcação | Sunburst com marcação | Flare sem marcação | Flare com marcação |
|---|---|---|---|---|
| Central superior | Central superior | Central superior | Superior direita | Central superior |
| Inferior direita | Central superior | Inferior direita | Central superior | Inferior direita |
| Acertos no alvo | 1/2 | 2/2 | 0/2 | 2/2 |
Nas oito saídas, os modelos alteraram uma única tampa, mantiveram as outras cinco pretas e não reproduziram o círculo na imagem renderizada. A sobreposição mudou qual tampa recebeu a edição. Em duas outras tarefas nas quais o texto já indicava o alvo, substituir tampas selecionadas e colocar um selo em uma embalagem, 4/4 saídas atenderam aos critérios do teste em cada condição.
O resultado de posicionamento vem de dois alvos em uma única imagem sintética, com uma renderização por modelo e condição. Em um fluxo no qual uma pessoa seleciona um objeto em uma tela, a figura mostra um uso direto dessa seleção. Quando o texto já identificava um alvo único, a sobreposição adicional não trouxe benefício observável nas duas tarefas anteriores.
Como as edições foram testadas?
Enviamos requisições JSON pelo endpoint de geração de imagens do Synthorai. Cada requisição gerou um PNG de 1024 × 1024 com quality fixado em medium. O comparativo das garrafas manteve a complexidade média e variou a sobreposição. O comparativo da programação usou quatro saídas bem-sucedidas por modelo e configuração. As requisições ao GPT Image 2 foram executadas em um lote separado, e o avaliador sabia qual era o modelo ao pontuá-las. O mesmo avaliador usou imagens 2.6 numeradas nos testes repetidos e aplicou a mesma lista de verificação. A programação só passava se os dois cartões de destino estivessem corretos, o selo acompanhasse Sound Lab, os outros quatro cartões e os rótulos de sala e horário fossem preservados, e o rodapé e a grade permanecessem intactos.
O exemplo usa o endpoint JSON do Synthorai em /v1/images/generations. A OpenAI documenta a edição orientada por marcação em seu endpoint nativo /v1/images/edits. Guia de geração de imagens da OpenAI Synthorai Image API
Para reproduzir a requisição marcada do Flare, salve os dois arquivos no mesmo diretório do script. A sobreposição é um PNG transparente com as mesmas dimensões da imagem de origem e um círculo ao redor da tampa inferior direita. PNG de origem · PNG da sobreposição
import base64
import json
import os
from pathlib import Path
from urllib.request import Request, urlopen

def png_data_url(path):
    return "data:image/png;base64," + base64.b64encode(Path(path).read_bytes()).decode()

payload = {
    "model": "gpt-image-2.6-flare",
    "prompt": (
        "Change exactly one bottle cap from black to polished gold. "
        "If a cap is circled in the annotation, change that cap. "
        "Keep all other caps black and preserve the six bottles and layout. "
        "Do not reproduce the circle."
    ),
    "image": png_data_url("bottles.png"),
    "markup": png_data_url("cap-overlay.png"),
    "complexity": "medium",
    "quality": "medium",
    "size": "1024x1024",
    "n": 1,
    "output_format": "png",
}

request = Request(
    "https://synthorai.io/v1/images/generations",
    data=json.dumps(payload).encode(),
    headers={
        "Authorization": f"Bearer {os.environ['SYNTHORAI_API_KEY']}",
        "Content-Type": "application/json",
    },
)
with urlopen(request, timeout=240) as response:
    result = json.load(response)

Path("edited.png").write_bytes(base64.b64decode(result["data"][0]["b64_json"]))
print(result.get("usage"))
Perguntas frequentes
A comparação com o GPT Image 2 usa o mesmo nível de planejamento?
A requisição ao GPT Image 2 omitiu complexity. Sunburst e Flare usaram explicitamente complexidade média na tabela com os três modelos. As entradas e configurações de saída são as mesmas, e os resultados se aplicam a essas configurações específicas de API.
O GPT Image 2.5 foi testado pelo Synthorai?
GPT Image 2.5 Sunburst e Flare aparecem apenas na tabela pública do Arena. O experimento no Synthorai usou GPT Image 2, GPT Image 2.6 Sunburst e GPT Image 2.6 Flare. Ranking do Arena para edição de uma única imagem
Quando devo usar marcação em uma edição de imagem?
Use markup quando puder indicar o objeto desejado diretamente na imagem, principalmente se houver vários objetos semelhantes. Envie a anotação como um PNG transparente separado e descreva a edição no prompt. Na imagem com seis garrafas, a tampa desejada foi selecionada em 4/4 requisições com marcação e 1/4 sem marcação.
A complexidade alta tornou as edições da programação mais confiáveis?
Neste layout, Sunburst passou em 2/4 nas duas configurações, e Flare passou em 0/4 em ambas. Flare posicionou corretamente as duas palestras em duas renderizações com complexidade alta, mas ambas ainda colocaram o selo FULL no lugar errado.