
Claude Opus 5.5 vs Opus 5: stesse risposte, metà token output
Indice
- Cosa cambia davvero in Claude Opus 5.5?
- Cosa mostrano i benchmark del rilascio?
- Il risparmio dichiarato vale anche per i task single-shot?
- Cosa succede in un tool loop, dove i costi degli agent si accumulano?
- Quanto risparmio deriva soltanto dal taglio dei prezzi?
- Conviene mai usare un effort più alto?
- Cosa si rompe cambiando il model ID?
- I budget dei prompt rimangono validi?
- Quando conviene migrare?
- FAQ
Il prezzo di listino di Claude Opus 5.5 è inferiore del 20% rispetto a Claude Opus 5: $4 per milione di token di input e $20 per milione di token di output, contro $5 e $25. Quel 20% si applica indipendentemente dal comportamento del modello. Ci interessa quindi capire quanto risparmio rimane escludendolo. Su 13 task single-shot eseguiti con le impostazioni predefinite dei due modelli, Opus 5.5 ha addebitato il 65% in meno. A parità di prezzi, costa comunque il 56% in meno. In un tool loop multi-hop il vantaggio si riduce nettamente: 37% in meno in fattura, 22% mantenendo invariati i prezzi per token.
TL;DR
- Su 468 chiamate valutate, Opus 5.5 ha addebitato $0.0072 per task contro $0.0204 di Opus 5, con tutte le risposte corrette per entrambi.
- A parità di prezzi, Opus 5.5 è comunque costato il 56% in meno su questi task: in media ha prodotto 341 token di output contro 799.
- In un tool loop con quattro domande, il divario scende al 22% a parità di prezzi, perché prevalgono i token di input ed entrambi i modelli leggono gli stessi file.
- Con effort
max, Opus 5.5 è costato 3.3x rispetto alla propria configurazione predefinita nel loop, senza risolvere nulla in più. - Impostare
tool_choicesuanyo su un tool specifico ora restituisce HTTP 400; Opus 5 accetta entrambe le opzioni.
Anthropic ha rilasciato Opus 5.5 il 2026-09-22 dichiarando che, sui workload tipici, “costa il 40% in meno rispetto a Opus 5”. Solo la seconda parte di questa riduzione, cioè l’uso di meno token per task, dipende dal comportamento del modello. È quindi questa la parte che abbiamo misurato.
Cosa cambia davvero in Claude Opus 5.5?
Il taglio dei prezzi è il cambiamento minore. Quello principale è la scomparsa del controllo per disattivare il thinking. Con l’adaptive thinking, il modello decide quanto ragionare prima di rispondere. I relativi token vengono addebitati come output anche se l’API non li mostra. Su Opus 5.5 questa modalità è sempre attiva. L’unico controllo rimasto è effort, un parametro della richiesta con cinque livelli da low a max, che stabilisce quanto budget il modello può dedicare al ragionamento.
Opus 5 accettava thinking: {"type": "disabled"}. Nelle nostre misurazioni di Opus 5, era l’unica impostazione che portava il costo allo stesso livello di Opus 4.8. Questo controllo non esiste più.
| Opus 5 | Opus 5.5 | |
|---|---|---|
| Prezzo di listino (input / output per MTok) | $5 / $25 | $4 / $20 |
| Thinking | adattivo, disattivabile con effort high o inferiore | adattivo, sempre attivo |
| Effort predefinito | high | medium |
| Uso forzato dei tool | accettato | errore 400 (misurato) |
| Context window / output massimo | 1M / 128K | 1M / 128K |
| Knowledge cutoff | maggio 2026 | giugno 2026 |
| Data di rilascio | 2026-07-24 | 2026-09-22 |
| Testo tra le chiamate ai tool | blocchi text | blocchi thinking, vuoti con l’impostazione di visualizzazione predefinita |
| Categorie dei controlli di sicurezza | cybersecurity | cybersecurity e biologia, più un rifiuto per l’estrazione del reasoning |
Al di là della tabella, contano due righe. L’effort predefinito è sceso da high a medium, quindi una richiesta senza il campo effort non usa la stessa profondità impiegata da Opus 5. Anche la modifica agli aggiornamenti di avanzamento avviene senza segnali espliciti: le brevi note che il modello scriveva tra una chiamata ai tool e l’altra ora arrivano come blocchi di thinking, il cui testo rimane vuoto se non ne viene richiesta la visualizzazione. Un’interfaccia utente che mostrava queste note in streaming smette quindi di aggiornarle, senza alcun errore da intercettare.
Cosa mostrano i benchmark del rilascio?
Nella tabella pubblicata per il lancio, Anthropic colloca Opus 5.5 davanti a Fable 5.1 in tutti i benchmark di coding e knowledge work, e davanti a GPT-6 Astra nella maggior parte dei casi. I dati seguenti sono di Anthropic e sono stati ottenuti con adaptive thinking ed effort massimo. Per le righe di Terminal-Bench è stato usato xhigh.
| Benchmark | Opus 5.5 | Fable 5.1 | Opus 5 | GPT-6 Astra |
|---|---|---|---|---|
| Terminal-Bench 4.0 (coding agentico) | 66.4% | 55.8% | 52.3% | 57.9% |
| FrontierCode v1.1 | 54.4% | 50.3% | 48.0% | 53.3% |
| CursorBench 4.0 | 57.8% | 51.8% | 46.6% | non comunicato |
| GDPval-AA v2.1 (knowledge work, Elo) | 1846 | 1735 | 1708 | 1542 |
| AutomationBench (workflow aziendali) | 40.0% | 31.4% | 26.9% | 41.4% |
| Terminal-Bench-Science 0.1 | 58.7% | 52.6% | 29.0% | 64.6% |
| OSWorld 2.0 (uso del computer) | 81.8% | 80.7% | 74.0% | non comunicato |
Anthropic accompagna la propria tabella con una precisazione insolita: a questo livello, “i margini nei benchmark sono diventati un indicatore meno affidabile delle differenze nel mondo reale”. In pratica, la distanza da Fable 5.1 sarebbe inferiore a quella suggerita dai punteggi. Prima di citare questi numeri vanno considerate anche due note. Il test AutomationBench è stato eseguito da Zapier senza modelli di fallback, quindi ogni intervento dei controlli di sicurezza è stato contato come un fallimento. L’intera tabella è stata inoltre prodotta con i controlli di produzione attivi: quando interveniva un classificatore, i task di cybersecurity venivano assegnati a Opus 4.8 e quelli di biologia a Opus 5.
Questi benchmark non dicono quanto costa eseguire un task. Lo abbiamo quindi misurato.
Il risparmio dichiarato vale anche per i task single-shot?
Sì, e dipende soprattutto da una maggiore efficienza, non dal nuovo listino. Per single-shot intendiamo una sola richiesta e una sola risposta, senza tool: problemi di aritmetica e conteggio, come una regola iterativa di 200 passaggi o il conteggio dei percorsi su una griglia con celle bloccate. Abbiamo eseguito 13 task, con 3 ripetizioni ciascuno, usando tutti e cinque i livelli di effort più l’impostazione predefinita, sia su Opus 5.5 sia su Opus 5, per un totale di 468 chiamate valutate. Prima del test abbiamo calcolato tutte le risposte corrette in Python con un approccio brute force. Ogni prompt conteneva inoltre una stringa casuale univoca, per impedire a qualsiasi livello tra noi e il modello di rispondere usando un duplicato in cache. Il costo per task è calcolato applicando i prezzi di listino Anthropic ai token addebitati per ogni chiamata, thinking incluso, anziché leggendo il costo dalla risposta.
| Effort | Output mediano Opus 5.5 | Opus 5.5 $/task | Output mediano Opus 5 | Opus 5 $/task |
|---|---|---|---|---|
| predefinito | 193 | 0.0072 | 448 | 0.0204 |
| low | 185 | 0.0060 | 439 | 0.0201 |
| medium | 218 | 0.0085 | 538 | 0.0200 |
| high | 223 | 0.0094 | 542 | 0.0206 |
| xhigh | 233 | 0.0111 | 525 | 0.0197 |
| max | 762 | 0.0240 | 532 | 0.0220 |
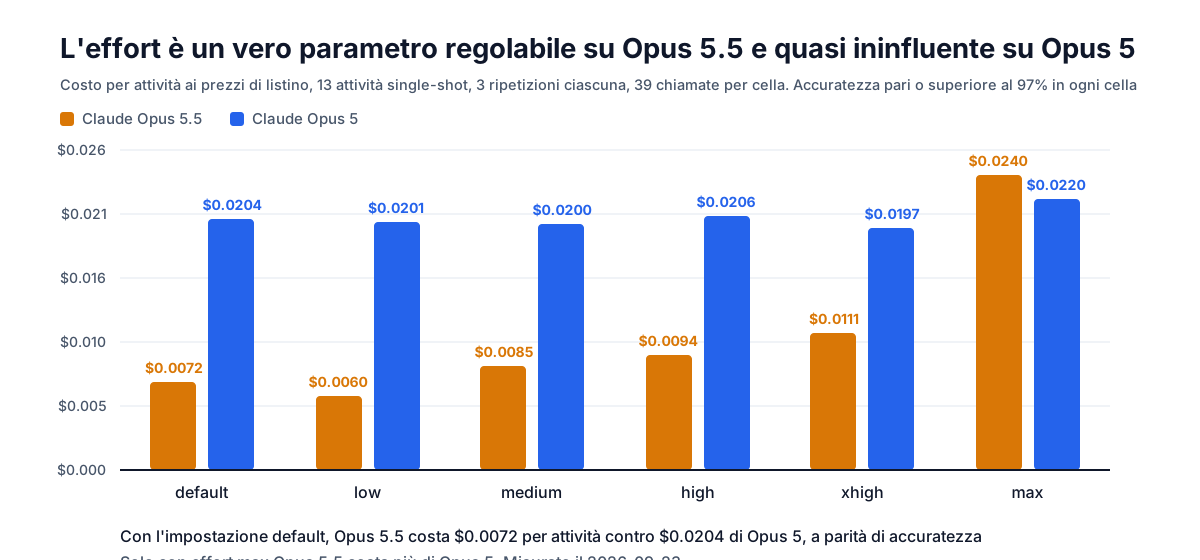
Con le impostazioni predefinite, entrambi i modelli hanno raggiunto un’accuratezza del 100%. A tutti gli altri livelli è rimasta almeno al 97%, con i tre errori distribuiti tra task e livelli diversi, anziché concentrati nella parte bassa della scala. Su questo insieme di task non emerge alcun crollo dell’accuratezza. La differenza riguarda quindi interamente il costo.
La scala dell’effort si comporta in modo diverso sui due modelli. Per Opus 5 il costo rimane pressoché invariato: da $0.0197 a $0.0220 tra low e max, con uno scarto del 12%. Opus 5.5 copre invece un intervallo di 4x, da $0.0060 a $0.0240. Su Opus 5.5 l’effort è un controllo effettivo, mentre su Opus 5 produce quasi nessun effetto. Una migrazione che riutilizza la stessa impostazione può quindi portare a un comportamento molto diverso da quello di partenza.
Sui cinque task più difficili il divario aumenta. Con l’impostazione predefinita, Opus 5.5 è costato $0.0113 per task contro $0.0375 di Opus 5, con un output mediano rispettivamente di 585 e 1,145 token.
Cosa succede in un tool loop, dove i costi degli agent si accumulano?
Il risparmio rimane, ma il vantaggio si riduce. Un tool loop è il test più realistico per confrontare Opus 5.5 con Opus 5. Ogni turno corrisponde a una richiesta: il modello invoca un tool, il codice lo esegue e poi rimanda l’intera cronologia. In una conversazione di cinque turni, la cronologia crescente viene quindi pagata cinque volte. Il costo dipende soprattutto dal numero di turni, non dal prezzo per token. Abbiamo fornito a entrambi i modelli tre tool (elenco dei file, lettura di un file e ricerca) su un piccolo servizio sintetico, insieme a quattro domande che richiedevano di seguire una catena di chiamate attraverso tre o quattro file. Abbiamo poi eseguito 12 test per configurazione sulla stessa interfaccia, con gli stessi tool e lo stesso prompt.
| Configurazione | Risolti | Turni mediani | Chiamate ai tool mediane | Token di output mediani | $/esecuzione |
|---|---|---|---|---|---|
| Opus 5.5, predefinito | 12/12 | 4 | 5 | 427 | 0.0326 |
Opus 5.5, low | 12/12 | 4.5 | 5 | 430 | 0.0330 |
Opus 5.5, max | 12/12 | 5 | 12 | 3,124 | 0.1087 |
| Opus 5, predefinito | 11/12 | 5 | 7 | 666 | 0.0519 |
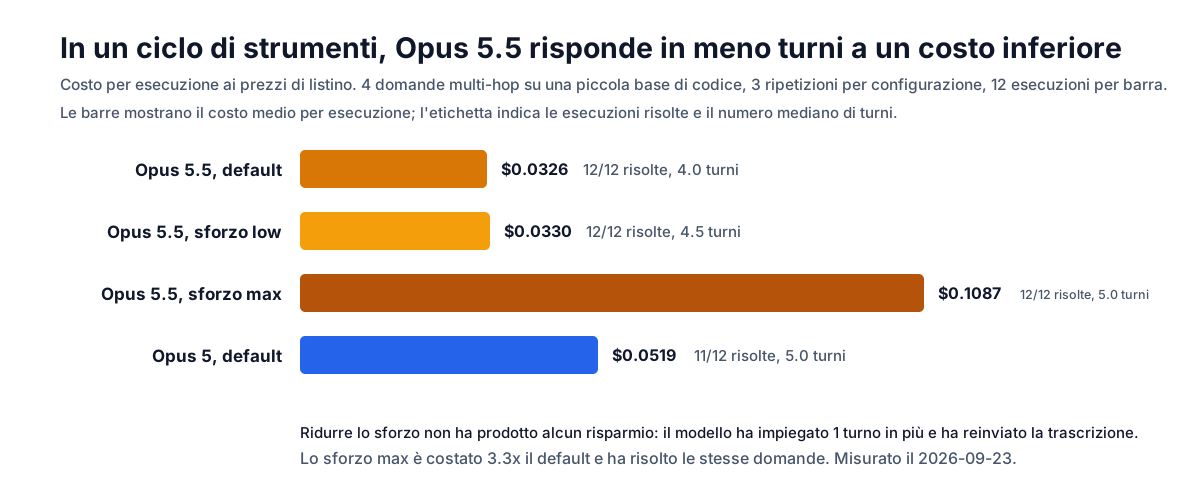
Con le impostazioni predefinite, Opus 5.5 è costato il 37% in meno per esecuzione rispetto a Opus 5, con il 12% di turni in meno e il 30% di token di output in meno. Il divario per domanda risolta è maggiore, 43%, perché Opus 5 ha fallito un’esecuzione. Il risultato è vicino al “40% in meno” dichiarato dal fornitore ed è quello che compare in fattura.
In questo workload, però, gran parte del vantaggio deriva dal listino. Il motivo è semplice: a ogni turno il loop rimanda l’intera cronologia ed entrambi i modelli leggono gli stessi file. Il numero totale di token è sceso solo del 19%, mentre i token di output sono diminuiti del 30%. Produrre meno testo aiuta meno proprio nel tipo di workload che costa di più. La sezione successiva quantifica questa differenza.
Nel loop, abbassare Opus 5.5 a low non ha prodotto alcun risparmio. In media il modello ha richiesto un turno aggiuntivo e il costo della cronologia ritrasmessa ha annullato la riduzione dei token. Il controllo dell’effort, efficace nei task single-shot, smette di offrire vantaggi nel loop perché il costo dipende dai turni, non dalla profondità del ragionamento.
Quanto risparmio deriva soltanto dal taglio dei prezzi?
Da un settimo a due quinti, in base alla forma del workload. La colonna centrale ricalcola il costo dei token misurati per Opus 5.5 usando le tariffe di Opus 5. Mostra quindi quanto Opus 5.5 risparmia producendo meno testo, mantenendo invariato il listino rispetto a Opus 5.
| Workload | Differenza addebitata | A parità di prezzi | Token di output |
|---|---|---|---|
| 13 task single-shot, impostazione predefinita | -65% | -56% | -57% |
| i cinque più difficili | -70% | -62% | -63% |
| tool loop multi-hop, impostazione predefinita | -37% | -22% | -30% |
Le righe single-shot mostrano un effettivo guadagno di efficienza: il taglio dei prezzi genera solo il 14% del risparmio, mentre il resto deriva dalla minore quantità di testo prodotta dal modello. Per pianificare i costi conviene usare la riga del tool loop, perché rappresenta la forma più comune del traffico agentico. In quel caso, il taglio dei prezzi genera il 41% del risparmio complessivo.
Conviene mai usare un effort più alto?
Non in questo workload, e il sovrapprezzo è elevato. Nel tool loop, Opus 5.5 con max è costato $0.1087 per esecuzione, 3.3x rispetto alla propria configurazione predefinita, risolvendo esattamente le stesse 12 domande. Il budget aggiuntivo è stato speso in chiamate ai tool: una mediana di 12 contro 5 con l’impostazione predefinita, insieme a 3,124 token di output contro 427. Nei task single-shot, max è stato l’unico livello in cui Opus 5.5 è costato più di Opus 5, $0.0240 contro $0.0220.
Il budget viene assorbito dal reasoning. In questi task con risposta singola, il thinking ha rappresentato il 98.4% dei token di output di Opus 5.5 con l’impostazione predefinita e il 99.6% con max. Tutti questi token vengono addebitati alla tariffa di output e, con l’impostazione di visualizzazione predefinita, non sono visibili. Anthropic consiglia di riservare max ai problemi al limite delle capacità del modello. I dati mostrano che, sui task che il modello risolve già, ogni aumento dell’effort aggiunge soltanto costi.
Cosa si rompe cambiando il model ID?
Due tipi di richiesta accettati da Opus 5 restituiscono un errore 400 su Opus 5.5. Entrambi sono comuni nel codice esistente.
L’uso forzato dei tool viene rifiutato. Qualsiasi client che imponga una chiamata a un tool, una tecnica comune per ottenere JSON strutturato da un modello chat, riceve questo errore:
tool_choice: type "tool" and "any" are not supported for this model.L’errore si presenta anche tramite un client compatibile con OpenAI, dove la stessa richiesta usa tool_choice: "required" oppure una funzione specifica. auto e none continuano a funzionare. Per migrare, bisogna indicare nel prompt quando applicare il tool e usare schemi rigorosi per i tool o structured output quando serve JSON conforme a uno schema.
Il thinking non può essere disattivato. Sia thinking: {"type": "disabled"} sia un valore manuale per budget_tokens generano un errore. Su un’interfaccia compatibile con OpenAI viene rifiutato anche l’equivalente reasoning_effort: "none". Il parametro effort li sostituisce:
import anthropic

client = anthropic.Anthropic()

response = client.messages.create(
    model="claude-opus-5-5",
    max_tokens=4096,
    messages=[{"role": "user", "content": "Summarize this incident report in five bullets."}],
    output_config={"effort": "low"},   # low | medium | high | xhigh | max; medium is the default
)

# Thinking is billed as output whether or not you can read it.
print(response.usage.input_tokens, response.usage.output_tokens)
low è l’opzione più simile al vecchio comportamento con thinking disattivato. Nel nostro insieme di task single-shot è stata anche la più economica, mantenendo l’accuratezza. Il thinking rimane comunque attivo e continua a essere addebitato come output.
I budget dei prompt rimangono validi?
I budget in token restano invariati. Sui due modelli, gli stessi quattro input hanno conteggiato rispettivamente 1,277 token contro 1,275 per un testo in inglese, 583 contro 581 per codice Python, 482 contro 480 per un blocco JSON con argomenti di un tool e 500 contro 498 per un testo in cinese. Lo scarto costante di due token deriva dal framing della richiesta, non dal testo. Un budget di contesto o una soglia di chunking calibrati su Opus 5 non richiedono quindi una nuova baseline per Opus 5.5.
Quando conviene migrare?
Per ridurre i costi, conviene passare a Opus 5.5 appena risolti i due problemi con le richieste descritti sopra. Anche escludendo il taglio dei prezzi, ottenere la stessa accuratezza spendendo il 56% in meno nei task single-shot e il 22% in meno in un tool loop non è una differenza marginale. Il confronto tra le impostazioni predefinite è inoltre quello che rispecchia la maggior parte dei deployment reali.
L’effort va ricalibrato, non trasferito invariato. L’impostazione predefinita è passata da high a medium e il controllo copre un intervallo quattro volte più ampio rispetto a Opus 5. Il livello migliore dipende dal tipo di workload: low è risultato il più economico e accurato nei task single-shot, mentre nel tool loop l’impostazione predefinita ha superato sia low sia max.
FAQ
Claude Opus 5.5 costa davvero il 40% in meno di Opus 5? In fattura, il dato è vicino: nel nostro tool loop Opus 5.5 è costato il 37% in meno per esecuzione rispetto a Opus 5, e il 65% in meno per task single-shot. Venti punti percentuali derivano dal listino più basso e si applicano indipendentemente dal comportamento del modello. Il guadagno di efficienza restante è del 22% nel loop e del 56% nei task single-shot.
Posso ancora disattivare il thinking su Opus 5.5?
No. Sia thinking: {"type": "disabled"} sia i budget manuali di token restituiscono un errore 400 su Opus 5.5. Va usato output_config.effort, dove low è l’impostazione più economica. I token di thinking vengono addebitati come output a ogni livello.
Cosa sostituisce l’uso forzato dei tool?
Mantieni tool_choice: {"type": "auto"} e specifica chiaramente nel prompt quando deve essere usato il tool. Quando serve JSON conforme a uno schema, usa schemi rigorosi per i tool o structured output. Su Opus 5.5 le varianti any e con un tool specifico vengono rifiutate con un errore 400, anziché essere convertite silenziosamente. Il problema si presenta quindi come richiesta fallita, non come risposta errata.
Devo misurare di nuovo le dimensioni dei prompt? No. Lo stesso testo ha generato gli stessi conteggi di token su Opus 5 e Opus 5.5 per testo, codice, JSON e cinese. I budget di contesto rimangono quindi invariati.
Opus 5.5 sostituisce Fable 5.1? Nella tabella dei benchmark di Anthropic, Opus 5.5 supera Fable 5.1 in tutti i benchmark elencati, con un prezzo per token pari al 40% di quello di Fable 5.1. Anthropic continua però a posizionare Fable 5.1 per reasoning complesso e attività agentiche di lunga durata. Dichiara inoltre che, nel mondo reale, il divario è inferiore a quello suggerito dai punteggi. La scelta corretta è quindi ripetere le proprie valutazioni anziché basarsi sulla tabella.
Misurazioni correlate: Claude Opus 5 vs Opus 4.8, la scala dell’effort di GPT-6 Astra e i controlli del thinking dei diversi fornitori.
Misurato il 2026-09-23, un giorno dopo il rilascio, tramite un gateway verso la Claude API e un’interfaccia compatibile con OpenAI. Il test comprende 468 chiamate single-shot valutate (13 task con risposte corrette calcolate localmente tramite brute force, 3 ripetizioni, 6 impostazioni di effort, 2 modelli) più 48 esecuzioni del tool loop (4 domande multi-hop, 3 ripetizioni, 4 configurazioni). I prompt includevano valori casuali univoci; ogni modello è stato usato tramite l’interfaccia che supportava il relativo parametro effort; i costi sono stati calcolati usando i prezzi di listino Anthropic anziché essere letti dalle risposte.