
gemini-3.1-flash-lite-image vs wan2.7-image-pro
Cuál usar y cuándo
Estos dos facturan en unidades diferentes - gemini-3.1-flash-lite-image cobra por token ($0.25 por millón de entrada, $30 por millón de salida) mientras que wan2.7-image-pro cobra $0.075 por llamada - , por lo que ninguna conversión única es honesta y debe comparar según la forma promedio de su propia solicitud. Elija gemini-3.1-flash-lite-image cuando desee texto junto a imágenes a partir de entrada de texto o imagen, con un límite de salida de 4096 tokens y un límite de conocimiento de 2025-01. Elija wan2.7-image-pro para generación pura de salida de imagen donde el precio plano por llamada hace que los costos sean predecibles independientemente de la longitud del prompt.
Precios
| gemini-3.1-flash-lite-image | wan2.7-image-pro | Δ | |
|---|---|---|---|
| Por imagen generada | - | $0.075 | - |
| Entrada / 1M tokens | $0.25 | - | - |
| Salida / 1M tokens | $30 | - | - |
Estos dos modelos se facturan en unidades distintas, así que no se muestra ningún Δ: para convertir una en otra habría que asumir algo que no hemos medido. Arriba, cada tarifa aparece en su propia unidad.
Especificaciones
| gemini-3.1-flash-lite-image | wan2.7-image-pro | |
|---|---|---|
| Modalidades de entrada | texto imagen | texto imagen |
| Modalidades de salida | texto imagen | imagen |
| Lanzamiento | 2026-06-30 | 2026-04-01 |
| Corte de conocimiento | 2025-01 | - |
| Tamaños de salida | 1K only (1:1 = 1024x1024) |
|
| Modos de entrada | text-to-image, interleaved generation + editing, up to 14 reference images | text-to-image, image editing (incl. bounding-box interactive edit), 0-9 reference images, text/image-to-image-set |
| Imágenes por solicitud | - | 12 |
| Formatos | - | png |
| Notas | 1K (1024px) output only 10 aspect ratios (1:1, 3:2, 2:3, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 21:9) and up to 14 reference images interleaved generation and editing with fast multi-turn local edits sub-2s end-to-end latency SynthID + C2PA watermarking always on | 4K text-to-image (max 4096x4096; editing max 2K), aspect ratios 1:8-8:1 instruction + click-to-edit editing character-consistent sets up to 12 images print-quality text rendering incl. formulas/tables |
Las especificaciones se transcriben de la documentación de cada proveedor; si un proveedor no publica un dato, la fila se omite en vez de deducirlo. Fuentes completas: gemini-3.1-flash-lite-image · wan2.7-image-pro
Un mismo prompt en los dos modelos, medido a través de la pasarela
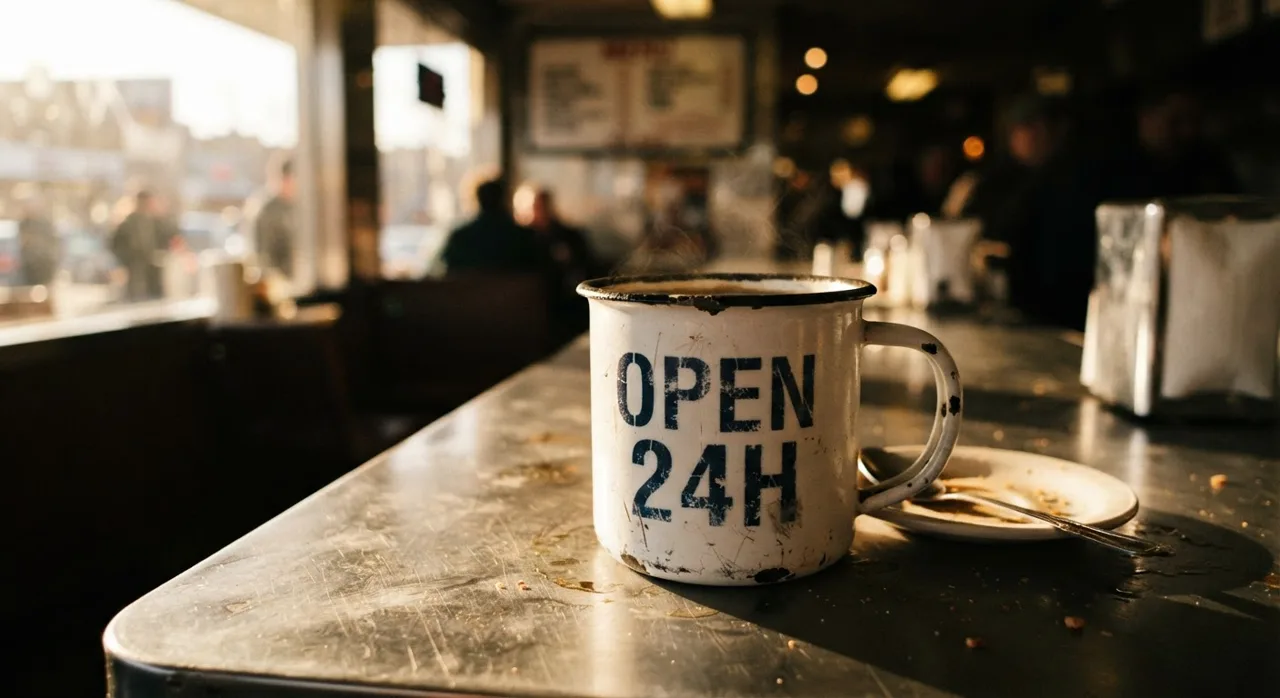
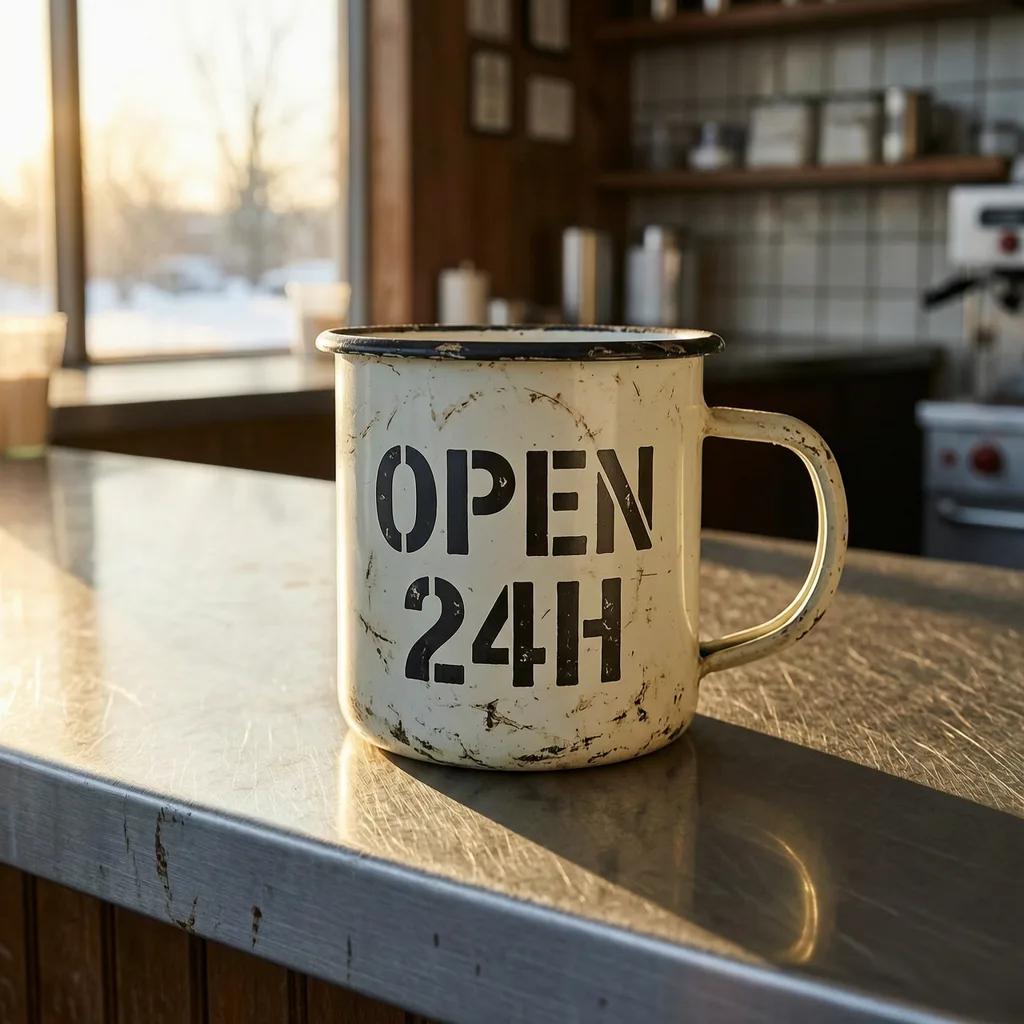
Un prompt y una solicitud por modelo, sin reintentos y sin escoger el mejor resultado: lo que ves es lo primero que devolvió cada modelo. No fijamos ni el tamaño ni la duración; cada modelo usó sus valores por defecto, porque una solicitud hecha a la medida de todos no dejaría en buen lugar a ninguno. Los archivos se han recodificado para la web, así que fíjate en la composición y en la fidelidad al prompt, no en la compresión.
Cambia de uno a otro con una sola línea
Los dos ids aparecen en todas las pestañas de abajo; lo único que cambia es el par de líneas resaltadas. El endpoint, la clave y la estructura de la solicitud son los mismos.
from openai import OpenAI

client = OpenAI(
    base_url="https://synthorai.io/v1",
    api_key="sk-syn-...",
)

resp = client.images.generate(
    model="gemini-3.1-flash-lite-image",
    # model="wan2.7-image-pro",  # descomenta esta línea, comenta la de arriba
    prompt="a watercolor lighthouse at dawn",
    size="1024x1024",
)
print(resp.data[0].b64_json[:80])
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://synthorai.io/v1",
apiKey: "sk-syn-...",
});
const resp = await client.images.generate({
model: "gemini-3.1-flash-lite-image",
// model: "wan2.7-image-pro", // descomenta esta línea, comenta la de arriba
prompt: "a watercolor lighthouse at dawn",
size: "1024x1024",
});
console.log(resp.data?.[0]?.b64_json?.slice(0, 80));curl https://synthorai.io/v1/images/generations \
-H "Authorization: Bearer sk-syn-..." \
-H "Content-Type: application/json" \
-d '{
"model": "gemini-3.1-flash-lite-image",
# "model": "wan2.7-image-pro", # descomenta esta línea, comenta la de arriba
"prompt": "a watercolor lighthouse at dawn",
"size": "1024x1024"
}'package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/option"
)
func main() {
client := openai.NewClient(
option.WithBaseURL("https://synthorai.io/v1"),
option.WithAPIKey("sk-syn-..."),
)
resp, _ := client.Images.Generate(context.TODO(), openai.ImageGenerateParams{
Model: "gemini-3.1-flash-lite-image",
// Model: "wan2.7-image-pro", // descomenta esta línea, comenta la de arriba
Prompt: "a watercolor lighthouse at dawn",
Size: "1024x1024",
})
fmt.Println(resp.Data[0].B64JSON[:80])
}import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.images.*;
OpenAIClient client = OpenAIOkHttpClient.builder()
.baseUrl("https://synthorai.io/v1")
.apiKey("sk-syn-...")
.build();
ImagesResponse resp = client.images().generate(
ImageGenerateParams.builder()
.model("gemini-3.1-flash-lite-image")
// .model("wan2.7-image-pro") // descomenta esta línea, comenta la de arriba
.prompt("a watercolor lighthouse at dawn")
.size("1024x1024")
.build());
System.out.println(resp.data().orElseThrow().get(0).b64Json().orElseThrow().substring(0, 80));Preguntas frecuentes
¿Cuál es más barato, gemini-3.1-flash-lite-image o wan2.7-image-pro?
Se facturan en unidades distintas, así que no hay una cifra única que sea honesta: en la tabla de arriba, gemini-3.1-flash-lite-image y wan2.7-image-pro aparecen cada uno en su propia unidad. Compáralos con tu propia carga de trabajo; el veredicto, al principio de esta página, explica qué ganas y qué pierdes con cada uno.
¿Puedo hacer pruebas A/B de gemini-3.1-flash-lite-image frente a wan2.7-image-pro sin dos integraciones?
Sí. Los dos se sirven desde el mismo endpoint compatible con OpenAI y con una sola clave API. Para cambiar de uno a otro basta con tocar una línea, el nombre del modelo, así que puedes mandar una parte del tráfico a cada uno y comparar directamente las facturas.
¿Cambia el precio con el tamaño de la imagen?
Depende de cómo se facture el modelo. Los que cobran por imagen cuestan lo mismo sea cual sea el prompt o el tamaño de salida; en los que se facturan por tokens, el precio sube con la resolución que generes, así que una imagen 4K cuesta varias veces lo que una pequeña. La tabla de arriba indica qué caso es el de cada modelo.