
LLM 智能体为什么慢?用追踪定位 3 个原因
逐一复现并修复智能体变慢的三个原因:模型调用串行执行、自身代码中的工具运行缓慢,以及只需一行答案却仍进行推理。串行模型调用修复后,耗时从3.7秒降至1.8秒,减少1.9秒,约缩短51%。分别检查模型调用方式、工具代码和回答所需的推理,定位不同环节的延迟来源。
我们的推荐
实时价格| 模型 | 结论 | 价格 |
|---|---|---|
| GPT-6 Luna 生成五个单句回答时,默认推理强度下的耗时中位数为 25.6 s,将 reasoning_effort 设为 none 后为 10.2 s,输出 token 数从 1,150 降至 190。 | 演示中的主智能体 | 低至 $0.1/百万 |
| DeepSeek V4.1 Flash 在输入 token 数同为 127 的情况下,依次发送三个单句检查请求时,耗时中位数为 3.7 s,同时发送时为 1.8 s。 | 演示中的子智能体 | 低至 $0.3/百万 |
目录
智能体运行慢,通常有三个原因:模型调用之间本来没有依赖,却在相互等待;两次调用之间,自身代码耗时太长;某次模型调用做了当前步骤不需要的额外工作。查看一次追踪,几秒内就能判断是哪一种,因为追踪会把每次调用画在时间轴上,也会显示调用之间的空档。本文用一个小型客服智能体逐一复现这些问题,再修复它们,并在 Synthorai 控制台中并排对比修复前后的运行记录。
TL;DR
- 用
asyncio.gather同时发送三个独立的模型调用,耗时中位数从 3.7 s 降至 1.8 s,成本不变。 - 同时执行四次模拟的 1.1 s 数据库查询,智能体自身代码的耗时从 4.6 s 降至 1.3 s。这部分耗时无法靠换模型解决。
- 在 GPT-6 Luna 上生成五个单句回答时关闭推理(
reasoning_effort="none"),耗时从 25.6 s 降至 10.2 s,输出 token 从 1,150 降至 190。
本文接着追踪 LLM 智能体展开,后者介绍了将模型调用关联成一次追踪所需的三个请求头。按那篇指南配置好演示环境(Python 3.10 或更高版本,已激活 virtualenv),然后在 github.com/synthorai-io/use-cases 的同一个目录下运行这三个案例:
cd use-cases/agent-tracing
python incidents.py serial-checks slow-tool reasoning
每个案例都会运行两次,先运行有问题的版本,再运行修复后的版本。每次运行打印一行结果,其中包含追踪 ID:
serial-checks
  before   3.5 s   3 calls     127 in (     0 cached)     60 out  $0.000110   trace-d2bb96ebcf04
  after    1.5 s   3 calls     127 in (     0 cached)     62 out  $0.000112   trace-5f1e76a2de87
模型调用的延迟会波动,因此我们在 2026 年 10 月 11 日将每个案例运行了五次。表中列出中位数,括号中是最快和最慢的耗时。第三个案例的修复版有一次运行失败,因此其中位数取自四次运行。上面的示例输出和截图中的对比,来自每个案例额外的一次运行,不计入这五次。耗时由脚本测量,采用墙钟时间,即从开始到结束的实际经过时间。
| 案例 | 追踪中看到的现象 | 修复方式 | 修复前 | 修复后 |
|---|---|---|---|---|
serial-checks | 条形呈阶梯状,互不重叠 | 同时发送独立调用 | 3.7 s(3.5 到 4.5) | 1.8 s(1.7 到 2.0) |
slow-tool | your app 行很长 | 修复自身代码 | 11.0 s(9.5 到 12.2) | 9.2 s(6.7 到 11.0) |
reasoning | 输出数量远大于实际回复 | 降低推理强度 | 五个回答共 25.6 s(19.0 到 31.8) | 10.2 s(7.9 到 12.1) |
智能体运行慢,先看哪里?
先看追踪顶部的摘要。它把墙钟时间分为网关内耗时和应用内耗时。墙钟时间就是用户实际等待的时间。“In the gateway”表示至少有一个模型请求尚未结束的时间。“In your app”则是其余时间:请求之间只有自身代码在运行的时段。应用内耗时也包含代码与网关之间的网络耗时,在本文的运行记录中,每次调用约占零点几秒。
根据这个划分决定下一步查哪里:
- 大部分时间在网关内,条形呈阶梯状:调用在相互等待。看第一个案例。
- 应用内耗时占比很大:问题不在模型。看第二个案例。
- 大部分时间在网关内,某个条形特别长:某一次调用占了主要耗时。摘要会将它标为“slowest”。看第三个案例。
要查看修改的效果,打开修改前的追踪,选择 Compare,再选中修改后的追踪。控制台会在同一页展示两次运行:每项指标都有 A、B 和变化量,每次调用都会与同名调用配对,两个瀑布图共用一条时间轴。本文所有截图都来自这个视图。
本可并行的调用逐个执行时,追踪是什么样?
瀑布图呈阶梯状:前一个条形结束,下一个才开始。演示中的智能体用 DeepSeek V4.1 Flash 对客户消息做三项检查,分别检查情绪、政策和风险,每项输出一句话。三项检查都不依赖其他检查的结果,但有问题的版本在循环中逐个等待:
for span, question in CHECKS.items():        # each call waits for the one before it
    await check(run, span, question)
只需一行就能修复:
await asyncio.gather(*(check(run, span, q) for span, q in CHECKS.items()))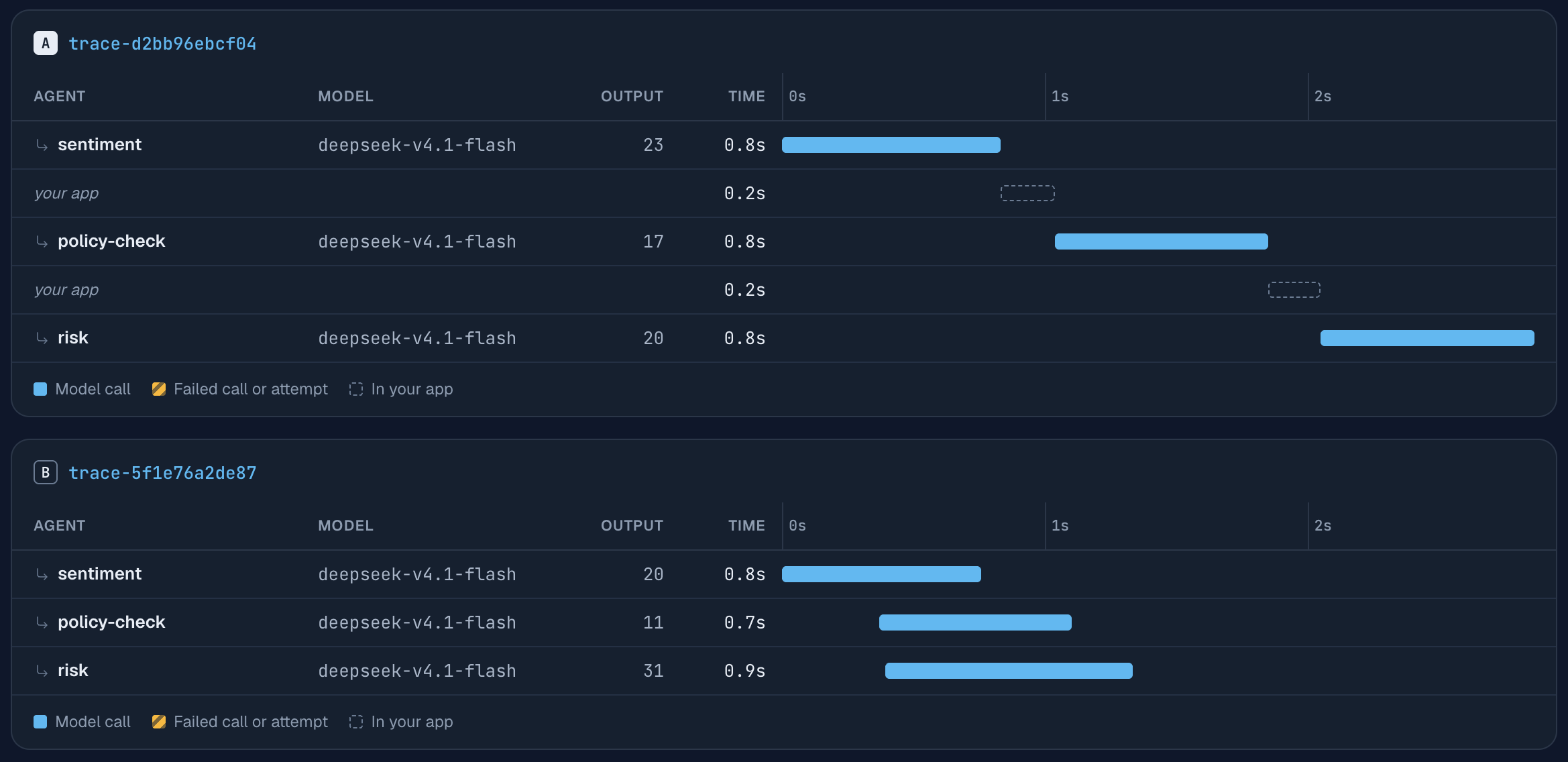
追踪 A 的墙钟时间为 2.9 s:三个调用各耗时 0.8 s,逐个执行,调用之间有 0.2 s 的空档。追踪 B 中,条形相互重叠,墙钟时间为 1.3 s。同一控制台页面上的对比表位于截图区域上方,显示墙钟时间从 2.9 s 降至 1.3 s,减少 53.4%(根据未舍入的时间计算)。脚本对这两次运行测得的耗时为 3.5 s 和 1.5 s,因为它还计入了建立连接以及每次调用的网络耗时。
两次运行的输入都是 127 个 token。成本随输出量变化,而输出长度在各次运行间略有波动:这一组的成本分别为 $0.000110 和 $0.000112;五次运行中,串行版的成本中位数为 $0.000105,并行版为 $0.000109。并行调用发送和接收的 token 相同,因此不会增加成本。
检查自己的智能体时,逐一查看相邻的两个条形:后一次调用是否使用了前一次的输出?如果没有,它们就可以重叠执行。存在数据依赖的调用,比如先生成计划,再执行计划中的步骤,必须保持顺序。
怎么判断慢的是自己的代码?
看 your app 行是否很长。这个案例的有问题版本先从四张表中查询客户信息,再回答问题,查询逐个执行。每次查询用一个 1.1 s 的 sleep 模拟数据库调用:
rows = [await lookup(t) for t in tables] # four queries, one at a time同时执行四次查询,也只需一行:
rows = await asyncio.gather(*(lookup(t) for t in tables))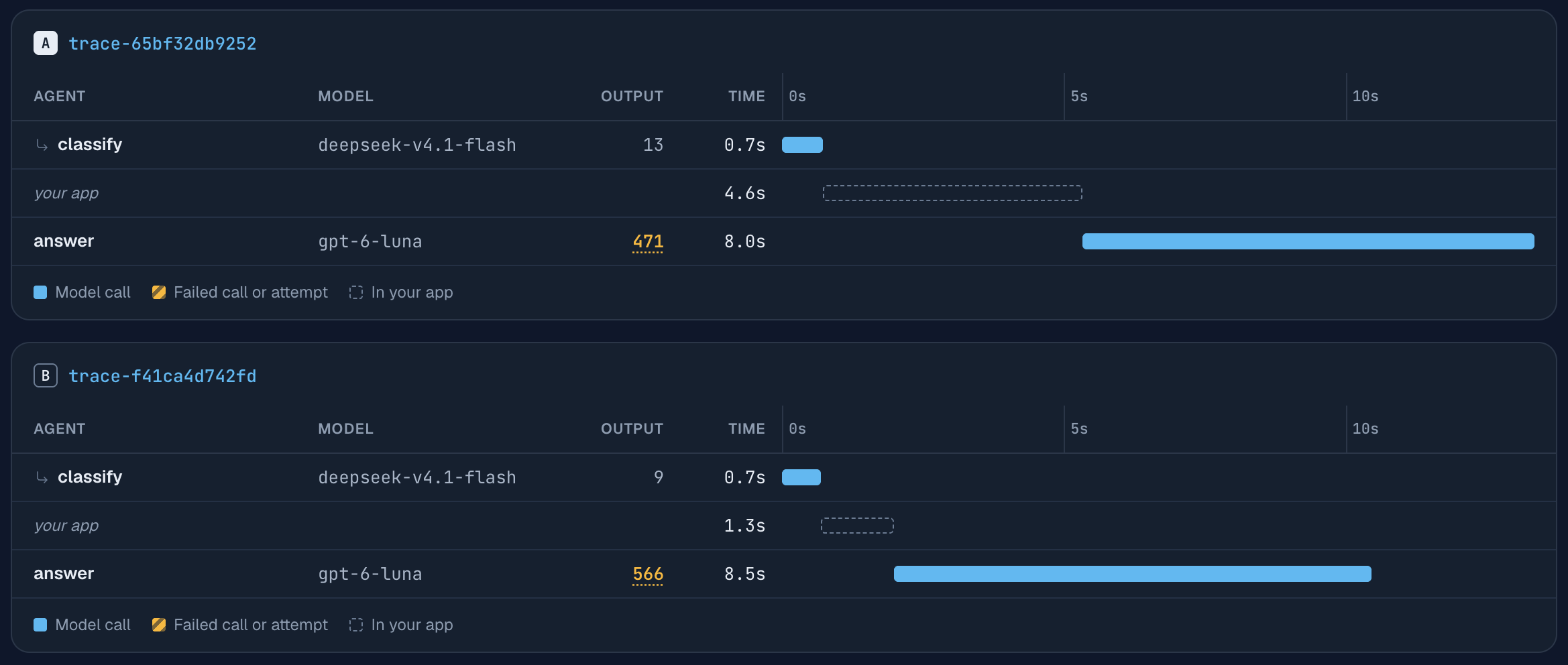
修改的这一行耗时从 4.6 s 降至 1.3 s,对比表显示“In your app”减少了 71.8%,同样根据未舍入的时间计算。换模型或改 prompt 都不会影响这一部分:当时没有进行中的模型请求,智能体只是在等待自己的查询。
总耗时没有这么整齐。这一组的墙钟时间从 13.3 s 降至 10.5 s,减少了 2.8 s,但修复本身节省了 3.3 s。差的半秒来自 GPT-6 Luna 的 answer 调用:第一次输出了 471 个 token,第二次输出了 566 个,耗时分别为 8.0 s 和 8.5 s。表中的五次运行里,两版的耗时区间有重叠:修复版为 6.7 到 11.0 s,有问题的版本为 9.5 到 12.2 s,因此单看一次运行,修复版也可能更慢。
所以要比较修改的那一行,而不是单次运行的总耗时。对比视图中的逐调用表会自动完成这一步:它将对应调用对齐,按 A 和 B 展示耗时、输出量与成本。要证明端到端耗时确实改善,需要比较两个版本各自多次追踪的时长。Logs 中的 p95 延迟(95% 的请求在此时间内完成)反映不出这次修复。它测量的是单个请求,而这里节省的是请求之间的时间。
网关只能看到空档持续了多久,看不到代码在这段时间做了什么。如果空档很长,又不知道原因,就需要用 OpenTelemetry 为自己的函数添加 span。
如果慢的是某一次模型调用呢?
先看这次调用输出了多少 token,因为生成输出需要时间。推理模型会先思考再回答,即使可见回复只有一句话,思考过程也会作为输出 token 计费并计入耗时。这个案例的有问题版本向 GPT-6 Luna 提出五个简短的政策问题,要求“用一句话回答”,但保留默认推理强度。修复版增加了一个参数:
await call(run, "answer", model=PLANNER_MODEL, messages=messages, reasoning_effort="none")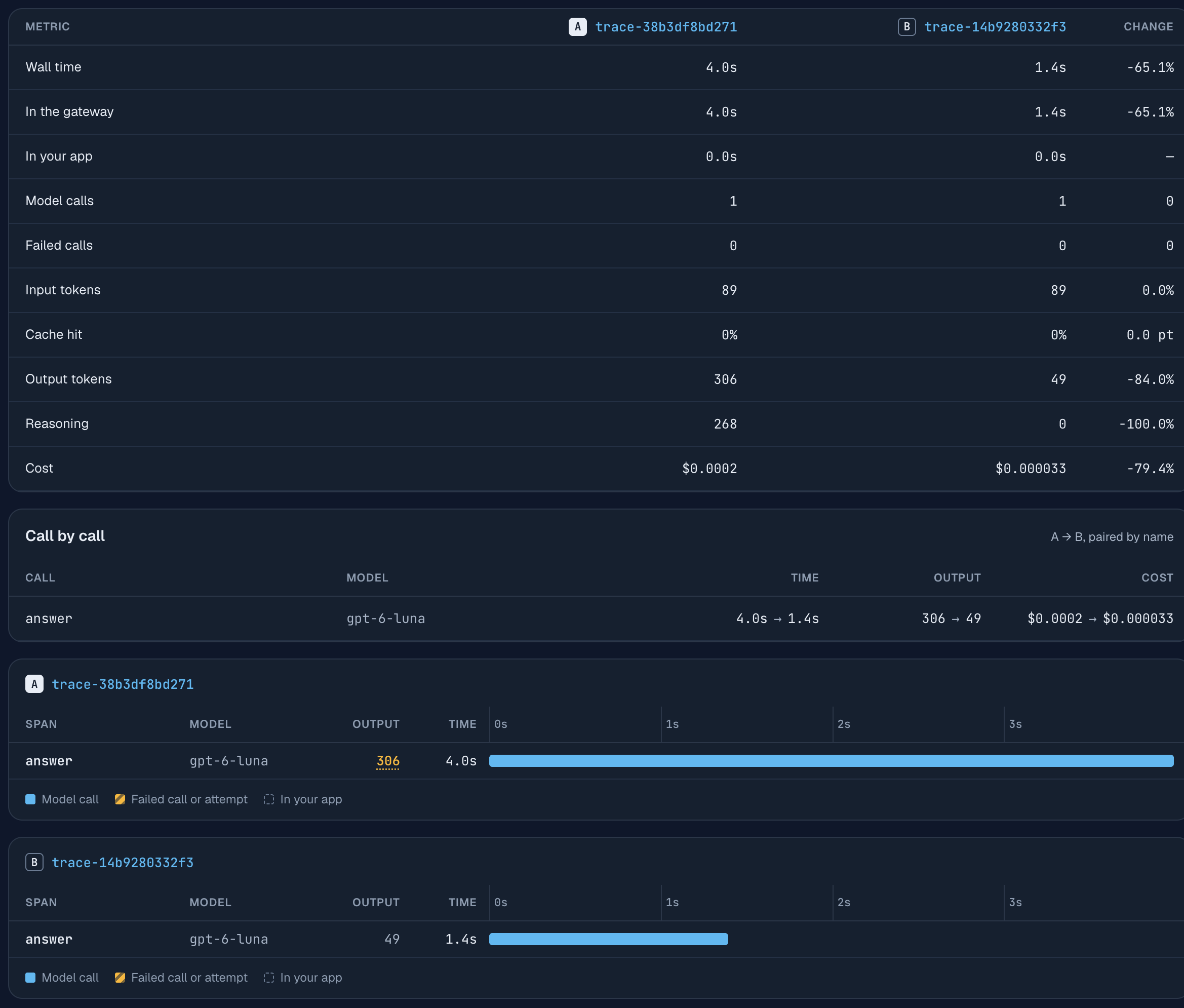
这是五个问题中第一个问题的修复前后对比。两次回复都只有一句话。默认推理强度下,模型为生成这句话输出了 306 个 token,其中 268 个用于推理,耗时 4.0 s。关闭推理后,输出了 49 个 token,耗时 1.4 s。调用成本从 $0.00016 降至 $0.000033,控制台会将前者舍入显示为 $0.0002。
| 五个单句回答(五次运行的中位数,第二行为四次) | 耗时 | 输出 token | 成本 |
|---|---|---|---|
| 默认推理强度 | 25.6 s | 1,150 | $0.000614 |
reasoning_effort="none" | 10.2 s | 190 | $0.000134 |
不用打开对比视图也能发现这个问题。瀑布图有 Output 列;如果某次调用的输出量较大,且大部分用于推理,数量就会带下划线,上面的 306 就是如此。选中该调用后,面板会在输出 token 下方单独列出推理 token。
查询、分类、改写工具结果等步骤适合关闭推理。需要多步推理的任务不适合,而这次演示没有测试这类任务。GPT-6 Luna 实测数据列出了各档设置下每个回答的推理 token 和成本,推理强度指南列出了各模型接受的参数值。按步骤调整,并检查该步骤修改前后的回答。
本文没有覆盖什么?
有两点。第一是用户感受到的回复速度。Streaming 不会缩短调用时长,但用户能更早看到文字,对聊天回复来说,这往往才是关键。调用面板中的 First token 字段用于查看这一点。这些追踪中该字段为空,因为演示没有使用 streaming。
第二是智能体之外的原因:例如提供商在某个时段响应慢,或速率限制导致客户端等待并重试。它们会表现为一个很长的条形,或一次失败调用后跟着重试。调整代码结构无法解决这些问题。
常见问题
如何找到 LLM 智能体最慢的步骤?
打开这次运行的追踪,查看摘要:它会标出最慢的调用,并将墙钟时间分为网关内耗时和应用内耗时。下方的瀑布图把每次调用画成条形,最长的条形或最长的 your app 行,就是需要检查的步骤。
并行 LLM 调用比串行调用更贵吗?
不会。演示中的三项检查逐个发送时,成本中位数为 $0.000105,并行发送时为 $0.000109,输入同样是 127 个 token;差异来自各次运行的输出长度波动。成本取决于 token 数,并行调用发送和接收的 token 相同。需要留意的是速率限制,因为并行调用会同时到达。
回复很短,为什么模型调用还是很慢?
通常是因为模型先进行了推理。推理过程会生成输出 token,但这些 token 不会出现在回复中。在 GPT-6 Luna 上生成五个单句回答时,默认推理强度下的输出 token 中位数为 1,150,使用 reasoning_effort="none" 时为 190。
如何衡量修复是否让智能体更快?
比较修改的部分,不要只看一次运行的总耗时。演示中,并行执行四次查询后,自身代码耗时从 4.6 s 降至 1.3 s;但由于某次模型调用的耗时波动,修复后单次运行的墙钟时间仍在 6.7 s 到 11.0 s 之间。按追踪时长比较两个版本的多次运行。
网关能显示两次模型调用之间我的代码做了什么吗?
它会用 your app 行显示空档持续了多久,但不会显示其中发生了什么。要查看自身代码中的 span,需要使用 OpenTelemetry SDK,并透传它的 traceparent 请求头,让两个视图使用同一个追踪 ID。
延伸阅读
- 追踪 LLM 智能体:本文使用的请求头和瀑布图。
- LLM 智能体为什么这么贵?:用同样的方法分析账单。
- 调试 LLM 智能体:从用户投诉定位到出错的调用。
- 按子智能体分析 Claude Code 成本:用同样的视图分析并非自己编写的编程智能体。
- 让 Claude 分析你的 LLM 日志:通过 MCP 回答有关请求日志的问题。
- 为智能体提供日志工具:用自己的程序读取同样的日志,以及所需模型 token 的成本。
- GPT-6 Luna 与 GPT-5.6 Luna 对比:各档推理强度下每个回答的推理 token 和成本。