
gemini-3.1-flash-lite-image vs GPT Image 2
什麼情況選哪一個
兩者皆為圖片模型,每百萬輸出 token 皆收取相同的 $30,因此真正的差異在於輸入:gemini-3.1-flash-lite-image 接收文字與圖片為每百萬 $0.25,而 gpt-image-2 為 $5,使其在提供提示詞與參考圖片時的成本便宜了 20x。針對包含大量提示詞或圖片輸入並輸出圖片的管線,當輸入量主導帳單時請選擇 gemini-3.1-flash-lite-image,並請注意它也能在圖片之外回傳文字,具有 4096-token 的輸出上限,且無法關閉思考功能。當您需要來自 OpenAI 的純圖片輸出端點,且輸入成本只是次要的支出項目時,請選擇 gpt-image-2。
定價
| gemini-3.1-flash-lite-image | GPT Image 2 | Δ | |
|---|---|---|---|
| 輸入 / 1M tokens | $0.25 | $5 | 0.05× |
| 輸出 / 1M tokens | $30 | $30 | = |
費率取自網站建置時的即時目錄;各模型頁面都列有最新的價目。
兩者的相對位置:每 1M tokens 的輸出價格,涵蓋同一計費單位下全部 9 個圖像生成模型(對數尺度)
規格
| gemini-3.1-flash-lite-image | GPT Image 2 | |
|---|---|---|
| 輸入模態 | 文字 圖像 | 文字 圖像 |
| 輸出模態 | 文字 圖像 | 圖像 |
| 發布日期 | 2026-06-30 | 2026-04-21 |
| 知識截止日期 | 2025-01 | - |
| 輸出尺寸 | 1K only (1:1 = 1024x1024) |
|
| 輸入方式 | text-to-image, interleaved generation + editing, up to 14 reference images | text-to-image, image edit with mask inpainting |
| 每次請求圖片數 | - | 10 |
| 格式 | - | png, jpeg, webp |
| 備註 | 1K (1024px) output only 10 aspect ratios (1:1, 3:2, 2:3, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 21:9) and up to 14 reference images interleaved generation and editing with fast multi-turn local edits sub-2s end-to-end latency SynthID + C2PA watermarking always on | Flexible resolutions: edges up to 3840px in multiples of 16, ratio <=3:1, ~0.65-8.3MP total (incl. 4K 3840x2160) editing with mask inpainting all image inputs processed at high fidelity significantly improved text rendering (precise placement can still struggle) |
規格摘錄自各供應商的文件;供應商沒有公布的項目就直接略過,不自行推測。 完整來源: gemini-3.1-flash-lite-image · GPT Image 2
同一段提示詞,兩個模型,經閘道實測
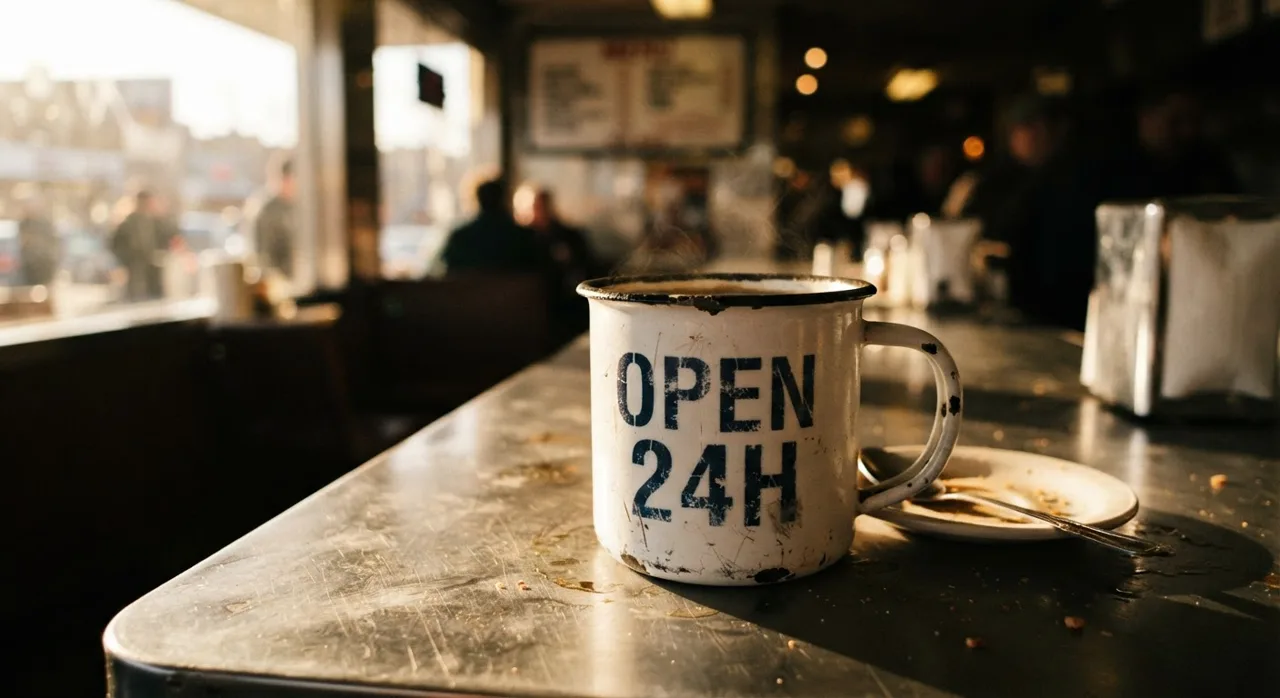
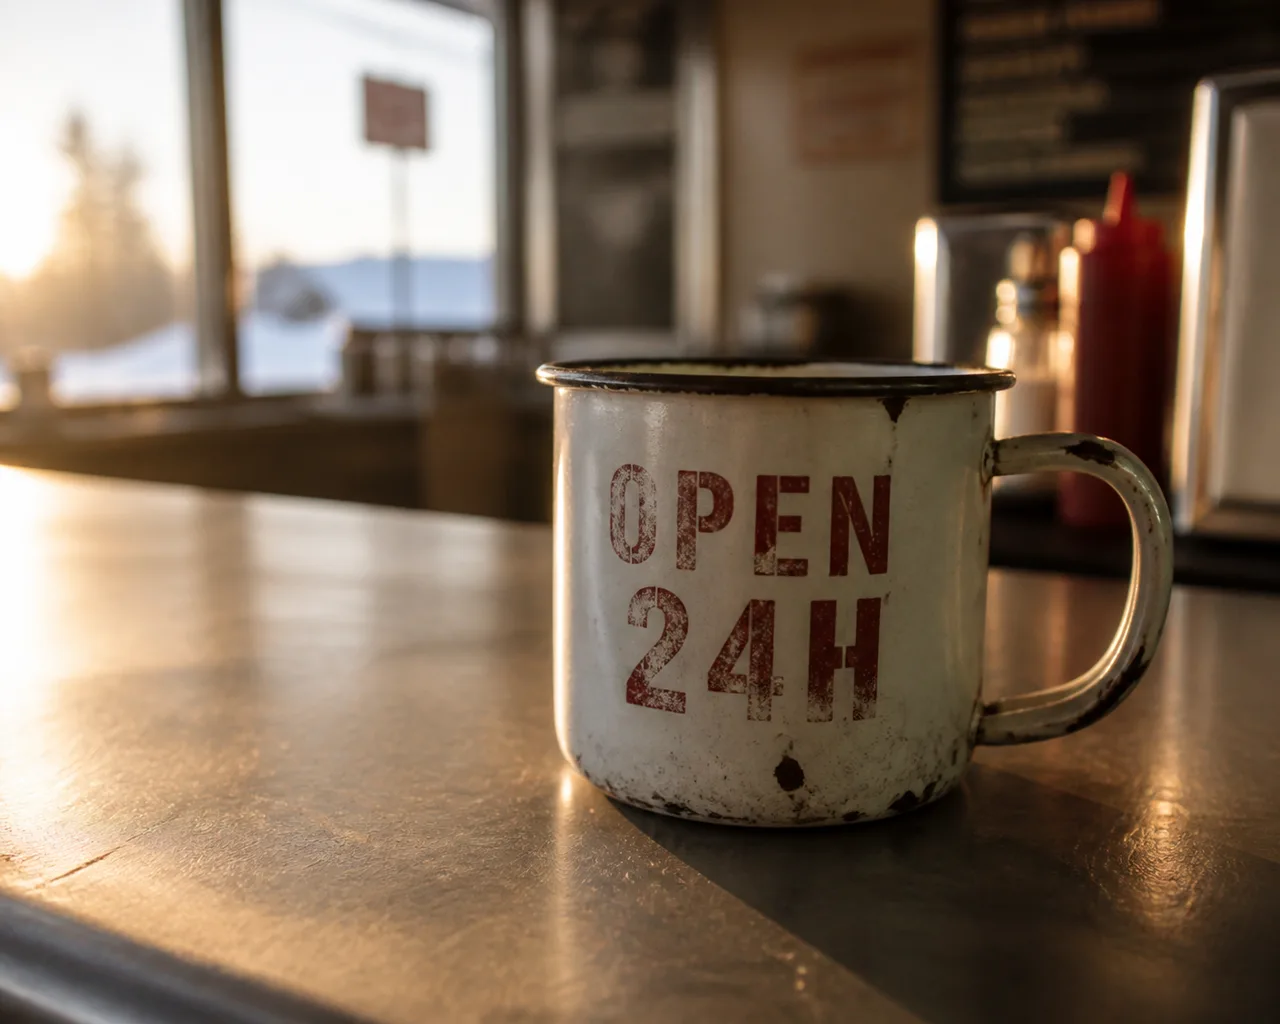
同一段提示詞,每個模型只送一次請求,不重試,也不挑比較好的結果,看到的就是各模型回傳的第一個結果。尺寸和長度都沒有指定,各模型用的是自己的預設值;如果硬把請求調成每個模型都適用的規格,反而誰的長處都看不出來。這裡的檔案都為了網頁重新編碼過,所以請看構圖和有沒有照提示詞做,不要拿來評斷壓縮品質。
改一行程式碼就能在兩者之間切換
下面每個頁籤都列了這兩個模型 ID,要改的只有醒目標示的那兩行。端點、金鑰和請求格式都不變。
from openai import OpenAI

client = OpenAI(
    base_url="https://synthorai.io/v1",
    api_key="sk-syn-...",
)

resp = client.images.generate(
    model="gemini-3.1-flash-lite-image",
    # model="gpt-image-2",  # 取消這一行的註解,並把上一行註解掉
    prompt="a watercolor lighthouse at dawn",
    size="1024x1024",
)
print(resp.data[0].b64_json[:80])
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://synthorai.io/v1",
apiKey: "sk-syn-...",
});
const resp = await client.images.generate({
model: "gemini-3.1-flash-lite-image",
// model: "gpt-image-2", // 取消這一行的註解,並把上一行註解掉
prompt: "a watercolor lighthouse at dawn",
size: "1024x1024",
});
console.log(resp.data?.[0]?.b64_json?.slice(0, 80));curl https://synthorai.io/v1/images/generations \
-H "Authorization: Bearer sk-syn-..." \
-H "Content-Type: application/json" \
-d '{
"model": "gemini-3.1-flash-lite-image",
# "model": "gpt-image-2", # 取消這一行的註解,並把上一行註解掉
"prompt": "a watercolor lighthouse at dawn",
"size": "1024x1024"
}'package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/option"
)
func main() {
client := openai.NewClient(
option.WithBaseURL("https://synthorai.io/v1"),
option.WithAPIKey("sk-syn-..."),
)
resp, _ := client.Images.Generate(context.TODO(), openai.ImageGenerateParams{
Model: "gemini-3.1-flash-lite-image",
// Model: "gpt-image-2", // 取消這一行的註解,並把上一行註解掉
Prompt: "a watercolor lighthouse at dawn",
Size: "1024x1024",
})
fmt.Println(resp.Data[0].B64JSON[:80])
}import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.images.*;
OpenAIClient client = OpenAIOkHttpClient.builder()
.baseUrl("https://synthorai.io/v1")
.apiKey("sk-syn-...")
.build();
ImagesResponse resp = client.images().generate(
ImageGenerateParams.builder()
.model("gemini-3.1-flash-lite-image")
// .model("gpt-image-2") // 取消這一行的註解,並把上一行註解掉
.prompt("a watercolor lighthouse at dawn")
.size("1024x1024")
.build());
System.out.println(resp.data().orElseThrow().get(0).b64Json().orElseThrow().substring(0, 80));常見問題
gemini-3.1-flash-lite-image 和 GPT Image 2 哪個比較便宜?
以「輸入 / 1M tokens」來看,gemini-3.1-flash-lite-image 比較便宜($0.25 對 $5,相差 20×)。其他項目的結果可能相反,完整價目請看上表;實際成本要看你的用量組合。
可以只串接一次,就對 gemini-3.1-flash-lite-image 和 GPT Image 2 做 A/B 測試嗎?
可以。兩個模型都走同一個 OpenAI 相容端點,用的也是同一把 API 金鑰,切換時只要改一行裡的模型名稱字串。你可以把一部分流量分別導到兩邊,再直接比較帳單。
價格會隨圖片大小改變嗎?
要看模型怎麼計費。按張計費的模型,不管提示詞長短或輸出尺寸,每張收費都一樣;按 token 計費的模型,費用會隨生成的解析度增加,所以一張 4K 圖片的成本會是小圖的好幾倍。各模型適用哪一種,上表都有標示。