
gemini-3.1-flash-lite-image vs GPT Image 2
언제 어떤 모델을 쓸까
두 모델 모두 100만 출력 토큰당 동일한 $30를 청구하는 이미지 모델이므로 실질적인 차이는 입력에 있습니다: gemini-3.1-flash-lite-image는 100만 토큰당 $0.25에 텍스트와 이미지를 받는 반면 gpt-image-2는 $5를 청구하므로, 프롬프트와 참조 이미지를 제공하는 데 20x 더 저렴합니다. 입력 볼륨이 비용의 대부분을 차지하는 프롬프트 비중이 높은 작업이나 image-in-image-out 파이프라인의 경우 gemini-3.1-flash-lite-image를 선택하되, 이 모델은 이미지와 함께 텍스트도 반환할 수 있고 4096 토큰 출력 제한이 있으며 thinking을 끌 수 없다는 점에 유의하세요. OpenAI의 순수 image-out 엔드포인트를 원하고 입력 비용이 사소한 항목일 때는 gpt-image-2를 선택하세요.
가격
| gemini-3.1-flash-lite-image | GPT Image 2 | Δ | |
|---|---|---|---|
| 입력 / 1M 토큰 | $0.25 | $5 | 0.05× |
| 출력 / 1M 토큰 | $30 | $30 | = |
빌드 시점에 실시간 카탈로그에서 가져온 요금입니다. 현재 요금은 각 모델 페이지에서 확인할 수 있습니다.
가격 위치: 이 과금 단위를 쓰는 이미지 생성 모델 9개 전체의 1M 토큰당 출력 가격(로그 스케일)
사양
| gemini-3.1-flash-lite-image | GPT Image 2 | |
|---|---|---|
| 입력 모달리티 | 텍스트 이미지 | 텍스트 이미지 |
| 출력 모달리티 | 텍스트 이미지 | 이미지 |
| 출시일 | 2026-06-30 | 2026-04-21 |
| 지식 컷오프 | 2025-01 | - |
| 출력 크기 | 1K only (1:1 = 1024x1024) |
|
| 입력 방식 | text-to-image, interleaved generation + editing, up to 14 reference images | text-to-image, image edit with mask inpainting |
| 요청당 이미지 수 | - | 10 |
| 포맷 | - | png, jpeg, webp |
| 참고 | 1K (1024px) output only 10 aspect ratios (1:1, 3:2, 2:3, 3:4, 4:3, 4:5, 5:4, 9:16, 16:9, 21:9) and up to 14 reference images interleaved generation and editing with fast multi-turn local edits sub-2s end-to-end latency SynthID + C2PA watermarking always on | Flexible resolutions: edges up to 3840px in multiples of 16, ratio <=3:1, ~0.65-8.3MP total (incl. 4K 3840x2160) editing with mask inpainting all image inputs processed at high fidelity significantly improved text rendering (precise placement can still struggle) |
사양은 각 공급자의 문서에서 그대로 옮겨 적었습니다. 공급자가 공개하지 않은 항목은 추정해 채우지 않고 뺐습니다. 전체 출처: gemini-3.1-flash-lite-image · GPT Image 2
같은 프롬프트, 두 모델: 게이트웨이를 거쳐 측정
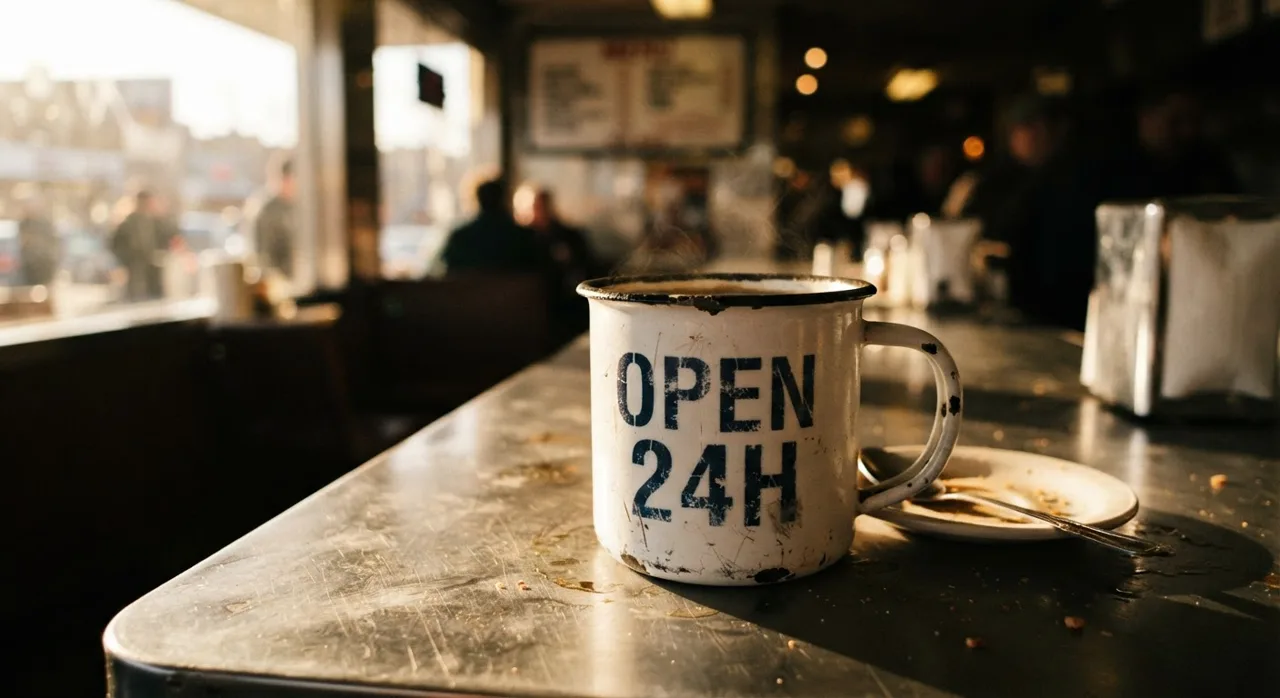
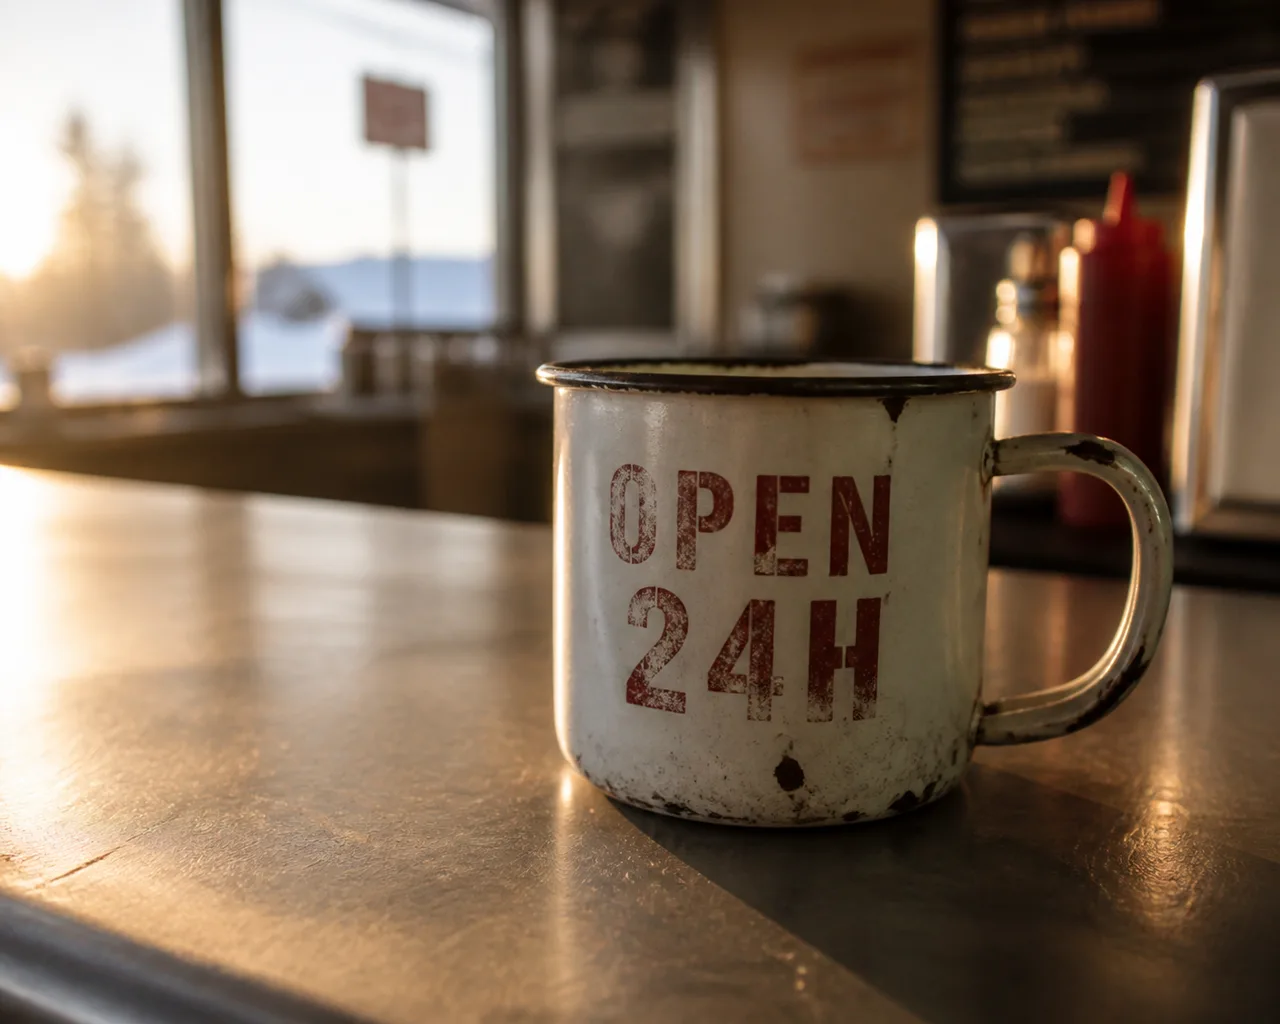
프롬프트 하나에 모델당 요청 한 번, 재시도도 골라내기도 없이 각 모델이 처음 반환한 결과입니다. 크기와 길이는 고정하지 않고 모델마다 기본값을 그대로 썼습니다. 모든 모델에 맞춘 요청은 어느 모델의 장점도 살리지 못하기 때문입니다. 여기 있는 파일은 웹용으로 다시 인코딩한 것이므로, 압축 품질이 아니라 구도와 프롬프트 반영 정도를 보고 판단하세요.
코드 한 줄로 모델 전환
아래 탭마다 두 모델 id가 모두 들어 있습니다. 바꿀 곳은 강조된 두 줄뿐이고, 엔드포인트, 키, 요청 형식은 그대로입니다.
from openai import OpenAI

client = OpenAI(
    base_url="https://synthorai.io/v1",
    api_key="sk-syn-...",
)

resp = client.images.generate(
    model="gemini-3.1-flash-lite-image",
    # model="gpt-image-2",  # 이 줄의 주석을 해제하고, 윗줄을 주석 처리하세요
    prompt="a watercolor lighthouse at dawn",
    size="1024x1024",
)
print(resp.data[0].b64_json[:80])
import OpenAI from "openai";
const client = new OpenAI({
baseURL: "https://synthorai.io/v1",
apiKey: "sk-syn-...",
});
const resp = await client.images.generate({
model: "gemini-3.1-flash-lite-image",
// model: "gpt-image-2", // 이 줄의 주석을 해제하고, 윗줄을 주석 처리하세요
prompt: "a watercolor lighthouse at dawn",
size: "1024x1024",
});
console.log(resp.data?.[0]?.b64_json?.slice(0, 80));curl https://synthorai.io/v1/images/generations \
-H "Authorization: Bearer sk-syn-..." \
-H "Content-Type: application/json" \
-d '{
"model": "gemini-3.1-flash-lite-image",
# "model": "gpt-image-2", # 이 줄의 주석을 해제하고, 윗줄을 주석 처리하세요
"prompt": "a watercolor lighthouse at dawn",
"size": "1024x1024"
}'package main
import (
"context"
"fmt"
"github.com/openai/openai-go/v3"
"github.com/openai/openai-go/v3/option"
)
func main() {
client := openai.NewClient(
option.WithBaseURL("https://synthorai.io/v1"),
option.WithAPIKey("sk-syn-..."),
)
resp, _ := client.Images.Generate(context.TODO(), openai.ImageGenerateParams{
Model: "gemini-3.1-flash-lite-image",
// Model: "gpt-image-2", // 이 줄의 주석을 해제하고, 윗줄을 주석 처리하세요
Prompt: "a watercolor lighthouse at dawn",
Size: "1024x1024",
})
fmt.Println(resp.Data[0].B64JSON[:80])
}import com.openai.client.OpenAIClient;
import com.openai.client.okhttp.OpenAIOkHttpClient;
import com.openai.models.images.*;
OpenAIClient client = OpenAIOkHttpClient.builder()
.baseUrl("https://synthorai.io/v1")
.apiKey("sk-syn-...")
.build();
ImagesResponse resp = client.images().generate(
ImageGenerateParams.builder()
.model("gemini-3.1-flash-lite-image")
// .model("gpt-image-2") // 이 줄의 주석을 해제하고, 윗줄을 주석 처리하세요
.prompt("a watercolor lighthouse at dawn")
.size("1024x1024")
.build());
System.out.println(resp.data().orElseThrow().get(0).b64Json().orElseThrow().substring(0, 80));자주 묻는 질문
gemini-3.1-flash-lite-image vs GPT Image 2, 어느 쪽이 더 저렴한가요?
입력 / 1M 토큰 기준으로는 gemini-3.1-flash-lite-image 쪽이 더 저렴합니다($0.25 대 $5, 20배 차이). 다른 항목에서는 반대일 수 있습니다. 전체 요금은 위 표에 있으며, 실제 비용은 사용 패턴에 따라 달라집니다.
연동을 두 번 하지 않고도 gemini-3.1-flash-lite-image vs GPT Image 2 A/B 테스트를 할 수 있나요?
네. 두 모델 모두 API 키 하나로 같은 OpenAI 호환 엔드포인트에서 호출합니다. 모델 문자열 한 줄만 바꾸면 전환되므로, 트래픽 일부를 각 모델로 보내 청구 금액을 직접 비교할 수 있습니다.
이미지 크기에 따라 가격이 달라지나요?
모델의 과금 방식에 따라 다릅니다. 이미지당 과금 모델은 프롬프트나 출력 크기와 관계없이 요금이 같습니다. 토큰 과금 모델은 렌더링 해상도에 비례하므로, 4K 이미지는 작은 이미지보다 몇 배 비쌉니다. 모델별 과금 방식은 위 표에서 확인할 수 있습니다.