
이미지 편집 비교: GPT Image 2.6 Sunburst, Flare, GPT Image 2
목차
- GPT Image 2.6에서 무엇이 달라졌나?
- Arena에서 GPT Image 2, 2.5, 2.6의 성능은?
- GPT Image 2, Sunburst, Flare는 같은 편집을 어떻게 처리했나?
- 세 모델의 일정표 편집 응답 속도는?
- 높은 복잡도가 일정표 편집 결과를 개선했나?
- GPT Image 2.6의 객체 선택에 markup이 도움이 되는 경우는?
- 편집 테스트는 어떻게 진행했나?
- FAQ
- GPT Image 2 비교에서 planning effort가 동일한가?
- Synthorai를 통해 GPT Image 2.5도 테스트했나?
- 이미지 편집에서 markup은 언제 사용해야 하나?
- 높은 복잡도가 일정표 편집의 신뢰성을 높였나?
GPT Image 2와 GPT Image 2.6의 두 변형 모델은 모두 같은 식품 라벨에서 주변 문구를 보존하면서 필드 3개를 수정했다. 컨퍼런스 일정표 편집에서는 중간 복잡도의 Sunburst가 렌더링 4회 중 2회를 통과했다. 중간 복잡도의 Flare와 기본 planning을 사용한 GPT Image 2는 각각 0/4였다. 일정표 작업은 발표 2개의 위치를 바꾸고, 그중 하나를 따라 FULL 배지도 이동하도록 요구했다.
TL;DR
- GPT Image 2와 두 2.6 변형 모델 모두 같은 식품 라벨 편집을 통과했다.
- 일정표에서는 중간 복잡도의 Sunburst가 2/4를 통과했다. GPT Image 2와 Flare는 각각 0/4였다.
- Sunburst는 중간 및 높은
complexity의 일정표 렌더링에서 각각 2/4를 통과했다. Flare는 중간 설정에서 발표 2개를 모두 바르게 교체한 결과가 0/4였고, 높은 설정에서는 2/4였다. 두 설정 모두 전체 통과는 0/4였다. - 텍스트에 위치 정보가 없을 때 시각적 표시를 추가하자 대상 선택 성공률이 1/4에서 4/4로 높아졌다.
GPT Image 2.6에서 무엇이 달라졌나?
OpenAI는 2026년 11월 4일 Images 2.6을 출시했다. Sunburst는 세부 작업과 여러 편집에 걸친 일관성을 위한 모델이고, Flare는 빠른 반복 작업에 맞춘 모델이다. 이번 릴리스에서는 API에 시각적 annotation과 planning 제어 기능이 추가됐고, GIF 및 SVG 출력도 지원하기 시작했다. OpenAI 릴리스 노트
complexity 설정은 렌더링 전에 수행하는 planning을 제어한다. 별도의 quality 설정은 렌더링의 세부 수준을 제어한다. OpenAI가 문서화한 planning 단계는 low, medium, high이며, 자사 API의 기본값은 high다. 2.6 요청에서는 두 파라미터를 모두 명시했다. OpenAI 이미지 생성 가이드
Arena에서 GPT Image 2, 2.5, 2.6의 성능은?
GPT Image 2.5 수치는 전부 Arena가 공개한 단일 이미지 편집 리더보드에서 가져왔다. 2026년 11월 12일 스냅샷에서는 두 2.5 항목의 표시 점수가 모두 2.6 Medium 항목보다 높았다. Arena 점수에는 투표자의 선호도가 반영된다. 항목마다 투표 수와 설정 라벨이 다르며, 아래 점수는 Arena에 표시된 불확실성을 그대로 유지했다. Arena 단일 이미지 편집 리더보드
| Arena 항목 | 표시 점수 | 투표 수 |
|---|---|---|
| GPT Image 2.5 Sunburst | 1519 ± 5 | 131,648 |
| GPT Image 2.5 Flare | 1484 ± 4 | 128,720 |
| GPT Image 2.6 Sunburst (Medium) | 1476 ± 11 | 3,493 |
| GPT Image 2 (Medium) | 1462 ± 3 | 364,695 |
| GPT Image 2.6 Flare (Medium) | 1460 ± 10 | 3,534 |
“Medium”은 Arena에서 사용하는 항목 라벨이다. gateway 테스트의 GPT Image 2 요청에서는 complexity 필드를 생략했다.
GPT Image 2, Sunburst, Flare는 같은 편집을 어떻게 처리했나?
세 모델 모두 식품 라벨 편집을 통과했다. GPT Image 2와 두 2.6 변형 모델은 나트륨 수치, lot code, 순중량을 모두 정확히 수정했다. 주변 문구도 그대로 보존했다. Sunburst와 Flare는 단순 편집 6개도 각각 6/6으로 통과했다. 병뚜껑과 reference badge 작업에서는 위치가 명확할 때 주변 세부 요소도 보존했다.
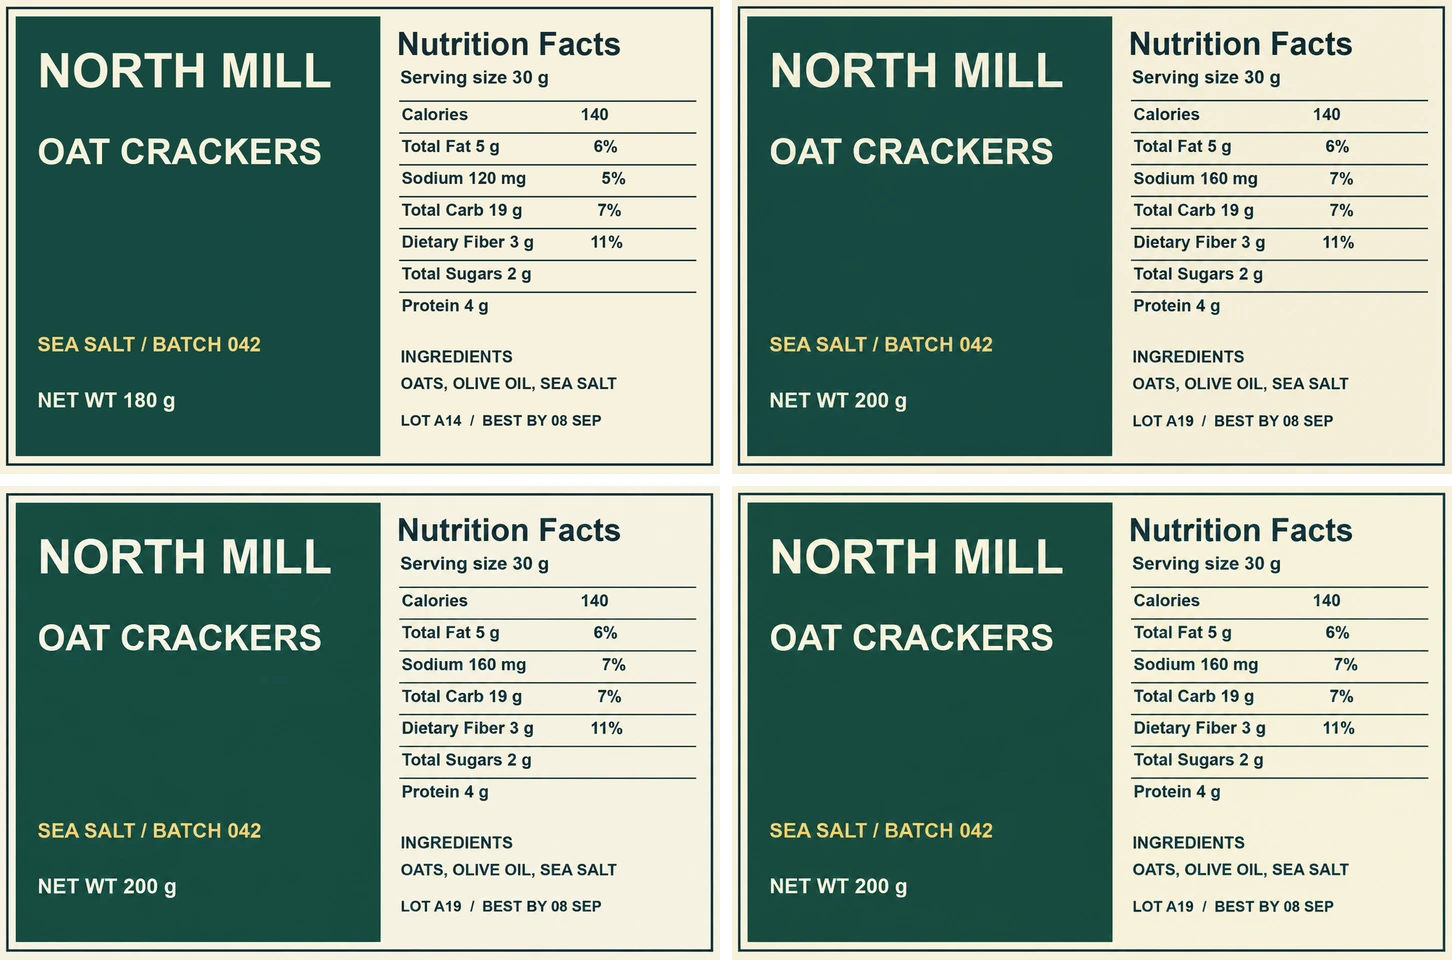
위쪽 행: 원본과 GPT Image 2. 아래쪽 행: Sunburst와 Flare. GPT Image 2는 기본 planning을 사용했고, 두 2.6 변형 모델은 중간 복잡도를 사용했다.
일정표 작업에서는 Studio B의 10:00 발표와 Studio C의 11:30 발표에서 제목과 발표자를 서로 바꾸고, 새 위치의 Sound Lab에 FULL을 추가하도록 요청했다. GPT Image 2는 매번 Sound Lab을 원래 위치에 두고 다른 발표 2개를 교체했다. Sunburst는 중간 복잡도 렌더링 4회 모두에서 요청한 발표 2개를 정확히 이동했다. 그중 2회는 배지가 이전 위치에 남았다.
| 모델 | Planning 설정 | 식품 라벨, 전체 통과 | 일정표, 발표 2개 모두 올바른 위치 | 일정표, 전체 통과 |
|---|---|---|---|---|
| GPT Image 2 | 기본값, 필드 생략 | 1/1 | 0/4 | 0/4 |
| GPT Image 2.6 Sunburst | 중간 | 1/1 | 4/4 | 2/4 |
| GPT Image 2.6 Flare | 중간 | 1/1 | 0/4 | 0/4 |
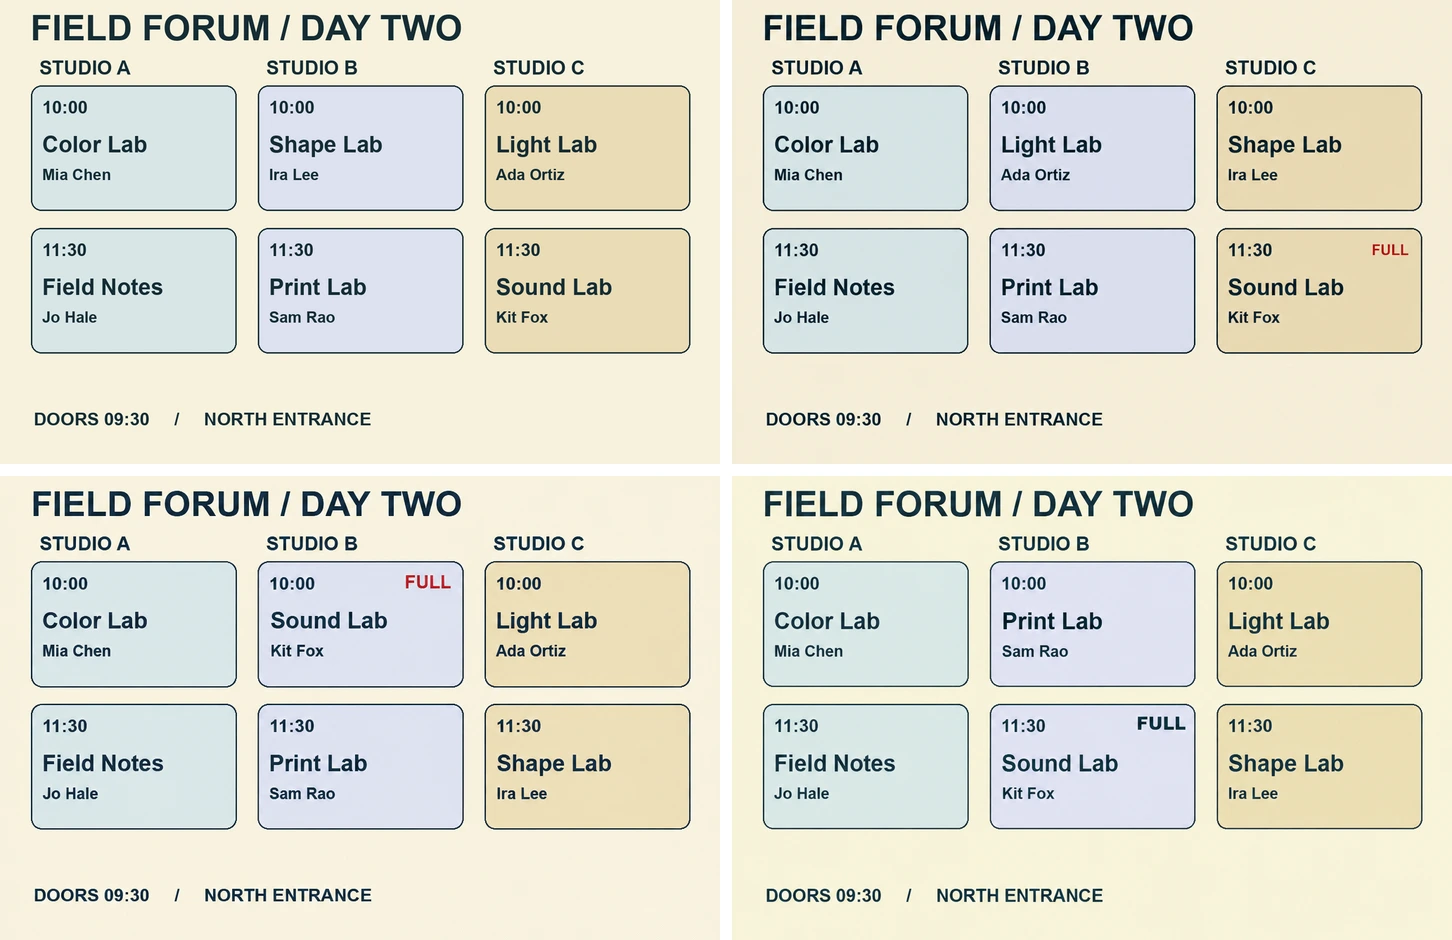
위쪽 행: 원본과 GPT Image 2. 아래쪽 행: Sunburst 렌더링 1개와 Flare 렌더링 1개. 표에는 모델별 렌더링 4회의 결과가 모두 포함됐다. GPT Image 2는 기본 planning을 사용했고, 두 2.6 변형 모델은 중간 복잡도를 사용했다.
세 모델에는 Synthorai를 통해 같은 원본 이미지와 prompt를 전달했고, 출력 크기와 요청한 quality: "medium"도 동일하게 설정했다. GPT Image 2 요청에서는 complexity를 생략했다. 두 2.6 요청은 이 표의 테스트에서 complexity: "medium"을 명시했다. GPT Image 2에 실제로 적용된 planning 단계는 알 수 없으므로, 표는 실행 당시의 API 설정 3개를 비교한다. 식품 라벨 점수는 렌더링 1회에서 얻었다. 일정표 점수는 하나의 layout에 대해 4회 시도한 결과다.
세 모델의 일정표 편집 응답 속도는?
같은 일정표 이미지와 prompt에서 Flare의 이미지 반환 시간 중앙값은 7.5초였다. Sunburst는 18.9초, GPT Image 2는 27.0초였다. 각 중앙값은 같은 테스트 호스트에서 Synthorai를 통해 성공한 API 응답 4회를 기준으로 하며, 요청 전송부터 전체 이미지 응답 수신까지의 시간을 측정했다.
| 모델 및 planning 설정 | 성공한 응답 | 중앙값 | 범위 |
|---|---|---|---|
| GPT Image 2, 기본값 | 4 | 27.0 s | 26.0 to 47.5 s |
| GPT Image 2.6 Sunburst, 중간 | 4 | 18.9 s | 18.3 to 21.3 s |
| GPT Image 2.6 Flare, 중간 | 4 | 7.5 s | 7.2 to 8.0 s |
이 시간은 중간 렌더링 품질로 편집 1회를 수행한 end-to-end latency다. GPT Image 2는 planning 필드를 생략한 별도 batch에서 실행했다.
높은 복잡도가 일정표 편집 결과를 개선했나?
Flare는 높은 복잡도 렌더링 중 2회에서 발표 2개를 모두 바르게 교체했지만, 중간 복잡도에서는 0회였다. 각 모델의 전체 통과 횟수는 두 설정에서 같았다. 일정표 작업에서는 2가지 변경이 서로 연동돼야 했다. 먼저 Studio B의 10:00 발표와 Studio C의 11:30 발표에서 제목과 발표자를 서로 바꾸되, 각 room과 시간은 원래 slot에 유지해야 했다. 그런 다음 Sound Lab이 들어간 새 카드에 FULL을 추가해야 했다. 발표 2개를 정확히 교체하더라도 FULL을 이전 위치에 붙이면 전체 통과가 아니다.
아래 Sunburst 예시에서 바로 그런 결과가 나왔다. 두 렌더링 모두 Sound Lab을 Studio B의 10:00으로, Shape Lab을 Studio C의 11:30으로 이동했다. 중간 복잡도 렌더링은 Sound Lab에 FULL을 붙였다. 높은 복잡도 렌더링은 Sound Lab이 있던 slot의 Shape Lab에 배지를 붙였다.
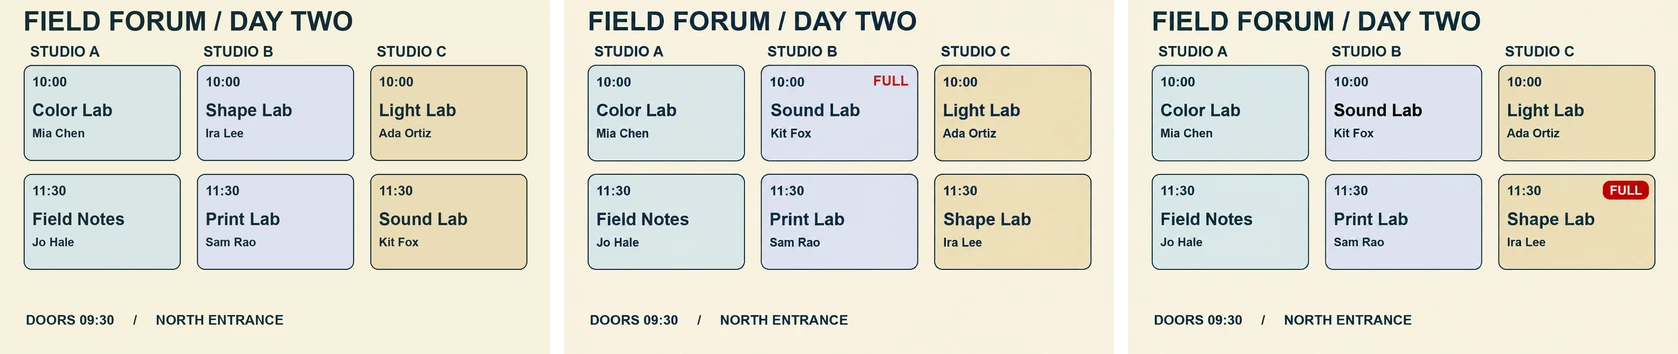
왼쪽부터 원본 일정표, 올바른 Sunburst 중간 복잡도 렌더링, 이전 slot에 라벨을 붙인 Sunburst 높은 복잡도 렌더링.
렌더링 16회에는 같은 원본 일정표를 사용했으며, 모델 및 복잡도 설정별로 출력 4개를 생성했다.
| 모델 | 중간, 발표 2개를 정확히 교체 | 중간, 전체 통과 | 높음, 발표 2개를 정확히 교체 | 높음, 전체 통과 |
|---|---|---|---|---|
| Sunburst | 4/4 | 2/4 | 4/4 | 2/4 |
| Flare | 0/4 | 0/4 | 2/4 | 0/4 |
Sunburst는 각 설정에서 렌더링 2개가 FULL을 잘못된 카드에 붙였다. 높은 복잡도의 Flare 렌더링 중 발표를 정확히 교체한 2개도 배지를 잘못 배치했다. 설정별 렌더링이 하나의 일정표에 대한 4회뿐이므로, 이 수치는 해당 편집의 결과를 나타낸다. 반복 요청 12회의 입력 및 출력 token 수는 두 설정에서 동일하게 보고됐다.
이벤트 게시 workflow에서는 배포 전에 영향을 받은 slot을 모두 확인하고, 최종 이미지에서 배지를 다시 읽어 검증해야 한다. 일정표가 구조화된 이벤트 데이터에서 생성된다면, 텍스트와 배지도 같은 데이터로 렌더링해야 한다. 그래야 이벤트의 slot이 바뀔 때 배지도 함께 이동한다.
GPT Image 2.6의 객체 선택에 markup이 도움이 되는 경우는?
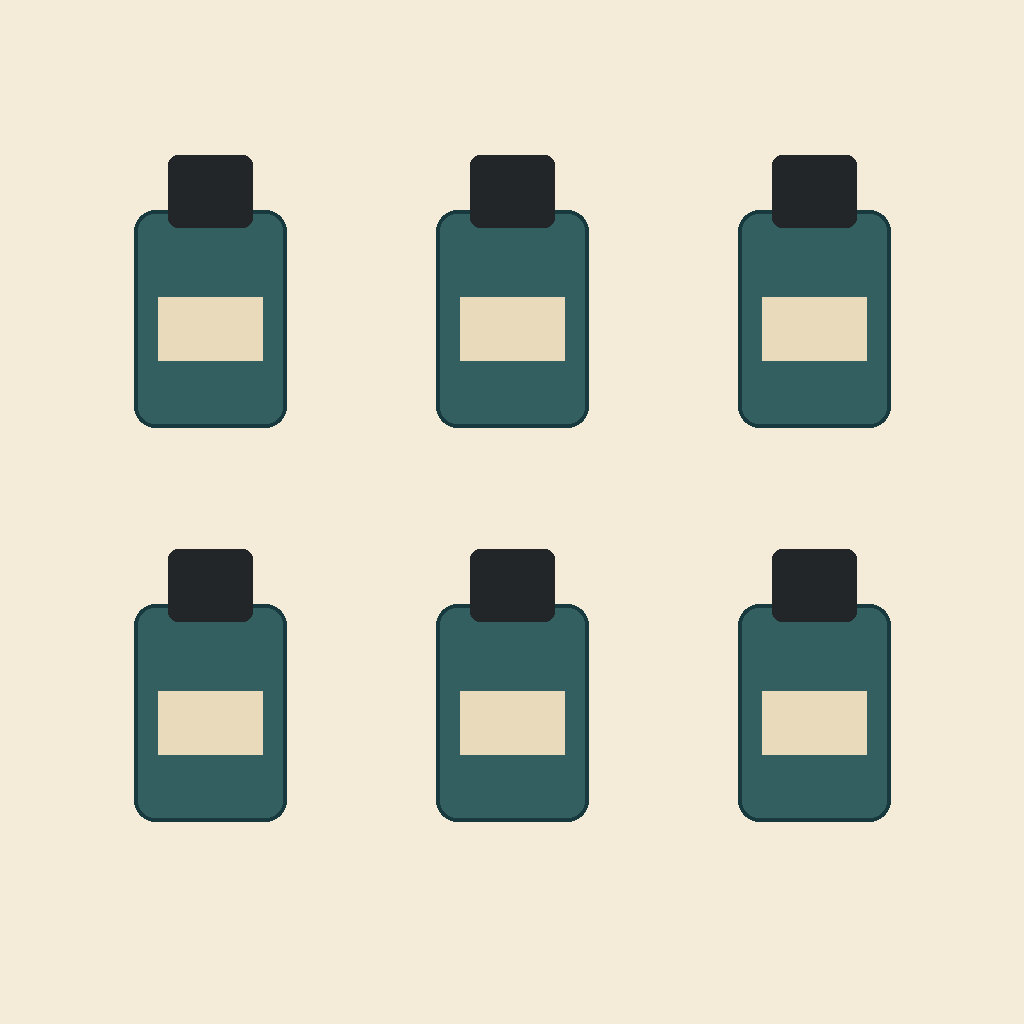
이미지에 똑같이 유효한 대상이 여러 개 있고 텍스트가 선택 기준을 제공하지 않을 때 markup이 도움이 됐다. GPT Image 2.6 Sunburst와 GPT Image 2.6 Flare에 동일한 병 6개가 있는 grid를 제공하고, 병뚜껑 정확히 1개만 광택이 있는 금색으로 바꾸도록 요청했다. 조건이 달라도 문구는 동일했다. annotation이 있으면 원으로 표시한 병뚜껑을 편집하도록 지시했고, 텍스트에는 위치를 명시하지 않았다.
지정 대상은 위쪽 가운데와 아래쪽 오른쪽 병뚜껑이었다. overlay가 없는 조건에서는 지정된 병뚜껑을 선택해도 우연히 일치한 결과다. 아래 그림에서 Flare는 markup이 없을 때 위쪽 가운데 병뚜껑을 선택했다. overlay를 추가하자 아래쪽 오른쪽 병뚜껑을 편집하고 나머지 5개는 검은색으로 유지했다.
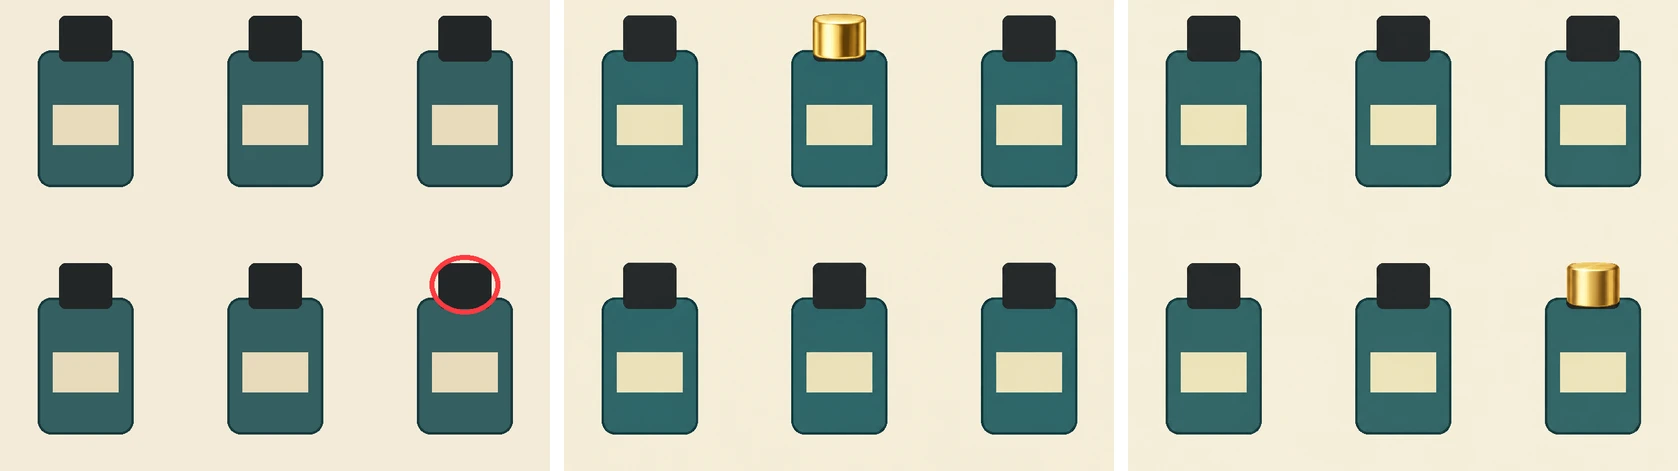
왼쪽부터 빨간색 overlay가 표시된 입력, markup 없는 Flare, markup을 적용한 Flare. 요청에는 원본 이미지와 overlay를 별도 입력으로 전달했다.
| 지정한 병뚜껑 | markup 없는 Sunburst | markup 적용 Sunburst | markup 없는 Flare | markup 적용 Flare |
|---|---|---|---|---|
| 위쪽 가운데 | 위쪽 가운데 | 위쪽 가운데 | 위쪽 오른쪽 | 위쪽 가운데 |
| 아래쪽 오른쪽 | 위쪽 가운데 | 아래쪽 오른쪽 | 위쪽 가운데 | 아래쪽 오른쪽 |
| 대상 적중 | 1/2 | 2/2 | 0/2 | 2/2 |
출력 8개 모두 병뚜껑 하나만 변경했고, 나머지 5개는 검은색으로 유지했으며, 렌더링 이미지에는 원을 포함하지 않았다. overlay는 편집을 적용할 병뚜껑을 바꿨다. 텍스트가 이미 대상 위치를 지정한 다른 작업 2개에서는 선택한 병뚜껑 교체와 패키지에 badge 배치 작업 모두 각 조건의 출력 4/4가 fixture 기준을 통과했다.
위치 관련 결과는 하나의 합성 이미지에서 대상 2개를 사용하고, 모델 및 조건별로 1회 렌더링해 얻었다. 사용자가 canvas에서 객체를 선택하는 workflow라면 이 선택 정보를 직접 활용할 수 있다. 텍스트가 이미 대상을 하나로 특정한 경우에는 위의 두 작업에서 overlay를 추가해도 관찰된 이점이 없었다.
편집 테스트는 어떻게 진행했나?
Synthorai 이미지 생성 endpoint를 통해 JSON 요청을 전송했다. 각 요청은 quality를 medium으로 고정하고 1024 × 1024 PNG 1개를 생성했다. 병 비교에서는 complexity를 중간으로 유지하면서 overlay만 바꿨다. 일정표 비교에는 모델 및 설정별로 성공한 출력 4개를 사용했다. GPT Image 2 요청은 별도 batch에서 실행했으며, 평가자는 채점할 때 모델을 알고 있었다. 반복 테스트에서는 같은 평가자가 번호만 붙인 2.6 이미지를 검토하고 동일한 작업 checklist를 적용했다. 일정표는 목적지 카드 2개가 정확하고, 배지가 Sound Lab을 따라 이동하고, 나머지 카드 4개와 room 및 시간 label이 보존되고, footer와 grid가 그대로 유지된 경우에만 통과로 판정했다.
이 예시는 Synthorai의 /v1/images/generations JSON endpoint를 사용한다. OpenAI는 자사 /v1/images/edits endpoint의 markup 기반 편집 방법을 문서화했다. OpenAI 이미지 생성 가이드 Synthorai Image API
표시된 Flare 요청을 재현하려면 두 파일을 script와 같은 위치에 저장하면 된다. overlay는 원본과 크기가 같은 투명 PNG이며, 아래쪽 오른쪽 병뚜껑 둘레에 원이 있다. 원본 PNG · Overlay PNG
import base64
import json
import os
from pathlib import Path
from urllib.request import Request, urlopen

def png_data_url(path):
    return "data:image/png;base64," + base64.b64encode(Path(path).read_bytes()).decode()

payload = {
    "model": "gpt-image-2.6-flare",
    "prompt": (
        "Change exactly one bottle cap from black to polished gold. "
        "If a cap is circled in the annotation, change that cap. "
        "Keep all other caps black and preserve the six bottles and layout. "
        "Do not reproduce the circle."
    ),
    "image": png_data_url("bottles.png"),
    "markup": png_data_url("cap-overlay.png"),
    "complexity": "medium",
    "quality": "medium",
    "size": "1024x1024",
    "n": 1,
    "output_format": "png",
}

request = Request(
    "https://synthorai.io/v1/images/generations",
    data=json.dumps(payload).encode(),
    headers={
        "Authorization": f"Bearer {os.environ['SYNTHORAI_API_KEY']}",
        "Content-Type": "application/json",
    },
)
with urlopen(request, timeout=240) as response:
    result = json.load(response)

Path("edited.png").write_bytes(base64.b64decode(result["data"][0]["b64_json"]))
print(result.get("usage"))
FAQ
GPT Image 2 비교에서 planning effort가 동일한가?
GPT Image 2 요청에서는 complexity를 생략했다. 세 모델 비교 표의 Sunburst와 Flare에는 중간 복잡도를 명시했다. 입력과 출력 설정은 같으며, 결과는 이 구체적인 API 설정에만 적용된다.
Synthorai를 통해 GPT Image 2.5도 테스트했나?
GPT Image 2.5 Sunburst와 Flare는 공개 Arena 표에만 포함됐다. Synthorai 실험에는 GPT Image 2, GPT Image 2.6 Sunburst, GPT Image 2.6 Flare를 사용했다. Arena 단일 이미지 편집 리더보드
이미지 편집에서 markup은 언제 사용해야 하나?
이미지에서 의도한 객체를 직접 가리킬 수 있을 때 markup을 사용한다. 특히 비슷하게 생긴 객체가 여러 개라면 유용하다. annotation을 별도의 투명 PNG로 보내고, prompt에 편집 내용을 설명하면 된다. 병 6개가 있는 이미지에서 markup을 적용한 요청은 4/4가 의도한 병뚜껑을 선택했고, 적용하지 않은 요청은 1/4만 선택했다.
높은 복잡도가 일정표 편집의 신뢰성을 높였나?
이 layout에서 Sunburst는 두 설정 모두 2/4를 통과했고, Flare는 두 설정 모두 0/4였다. Flare는 높은 복잡도 렌더링 2개에서 발표 2개를 정확히 배치했지만, 두 결과 모두 FULL 배지를 잘못 배치했다.