
컨텍스트 압축 비용: 몇 턴이면 회수할 수 있을까
목차
- 컨텍스트 압축으로 어떤 문제를 해결하려는가?
- 시나리오 1: 모델의 컨텍스트가 부족해지면?
- 시나리오 2: 더 높은 요금 구간에 들어가기 전에 압축해야 할까?
- 시나리오 3: 한 번의 압축 비용을 회수하려면 몇 턴이 더 필요한가?
- 압축하면 이미 낸 캐시 쓰기 할증을 낭비하는가?
- 회수 시점 공식은 실측 결과와 얼마나 일치하는가?
- DeepSeek의 암묵적 캐시에서는 무엇이 달라지는가?
- 컨텍스트 증가율은 압축 시점에 어떤 영향을 주는가?
- 작업을 계속할 때 모델이 제시하는 압축 주기는?
- 전체 비용은 어떻게 측정해야 하는가?
- 어떤 정책을 운영에 적용해야 하는가?
- 자주 묻는 질문
- 컨텍스트 압축은 항상 API 비용을 줄이는가?
- 요금 임계값에 정확히 맞춰 압축해야 하는가?
- 컨텍스트 창이 가득 찰 때까지 기다려도 되는가?
- 컨텍스트가 더 빨리 늘어나면 한 번의 요약 비용도 항상 더 빨리 회수되는가?
- 암묵적 캐시를 쓰면 컨텍스트 한도까지 기다려야 하는가?
Claude Sonnet 5.5에서 약 14k 토큰으로 시작한 웜 캐시 실험을 6회 진행했다. 컨텍스트 압축 비용은 이후 요청 4-6회 만에 회수됐다. 이 범위는 해당 워크로드에서 측정한 결과다. 압축 정책을 정할 때는 요약 생성 비용과 실제 캐시 과금 방식, 비용을 회수할 만큼 작업이 남아 있는지를 함께 고려해야 한다.
TL;DR
- 컨텍스트 창이 부족해지면 작업을 계속하기 위해 활성 컨텍스트를 줄여야 한다. 이번 실험에서는 모델의 최대 컨텍스트 창을 측정하지 않았다.
- 높은 요금 구간에서 요약을 생성한 사례에서는 이후 쿼리 1회로 거의 손익분기점에 도달했다. 요약 경로는 $0.0560882, 이력 유지 경로는 $0.0560655였다. 쿼리 2회에서는 요약 비용을 확실히 회수했다.
- 실험 후 공식으로 검산한 회수 시점은 4-5턴, 실측값은 4-6턴이었다. 사전에 예측 성능을 검증한 실험은 아니다.
- 질문 6개로 구성된 아카이브 작업은 압축 시 $0.0156941, 압축하지 않았을 때 $0.0059911이 들었다. 정확도는 모두 6/6이었다.
컨텍스트 압축으로 어떤 문제를 해결하려는가?
토큰 임계값을 정하기 전에 컨텍스트를 줄이는 이유부터 정해야 한다. 컨텍스트의 하드 한계에 가까운 상황, 더 높은 요금 구간에 진입하는 상황, 단순히 대화가 길어진 상황은 각각 판단 기준이 다르다.
컨텍스트 압축은 이전 대화 내용을 더 짧게 표현한 내용으로 바꾸고, 이후 요청에서 이를 사용하는 방식이다. 이번 실험에서는 클라이언트 측 텍스트 요약을 사용했다. 일반 모델 호출로 요약을 생성한 뒤, 애플리케이션이 이전 이력을 그 텍스트로 교체했다. 서명이나 암호화를 사용하는 네이티브 압축 기능은 요청 규격과 사용량 처리 방식이 다르다.
| 상황 | 주목적 | 실행 조건 | 이 글에서 다루는 근거 |
|---|---|---|---|
| 모델의 컨텍스트 창에 근접 | 작업을 계속 실행할 수 있도록 유지 | 다음 입력, 도구 결과, 출력을 수용할 여유 공간 확보 | 공개된 모델 한도와 엔지니어링 정책. 최대 컨텍스트 창 실험은 하지 않음 |
| 더 높은 요금 구간에 근접 | 전체 워크로드 비용 절감 | 예상 요금 절감액이 요약 및 후속 실행 비용을 초과 | 캐시를 사용하지 않은 소규모 요금 구간 실험 |
| 컨텍스트 창과 요금 구간에 여유가 있음 | 특정 워크로드 개선 | 필수 상태를 잃지 않으면서 요약 비용을 회수할 만큼 유효한 작업이 남아 있음 | 캐시를 사용하는 상태 유지 대조 실험과 짧은 아카이브 워크로드 |
시나리오 1: 모델의 컨텍스트가 부족해지면?
다음 요청이 지원되는 컨텍스트 창을 넘기 전에 활성 컨텍스트를 줄이거나 재구성해야 한다. 이 시점에는 전체 대화 이력을 그대로 유지하는 전략 자체가 불가능해질 수 있다.
Claude Haiku 5.5의 모델 사양에는 컨텍스트 창이 1M 토큰, 최대 출력이 128K로 명시돼 있다. 이는 공개된 사양이다. 게이트웨이 경로에서 실제로 허용하는 최대 컨텍스트는 테스트하지 않았으며, 아래의 요금 구간 실험으로도 그 한계를 확인할 수는 없다.
다음 입력, 도구 결과, 서비스에서 요구하는 출력을 위한 공간을 남겨야 한다. 요약 요청이 아직 들어갈 수 있을 때 압축을 실행해야 한다. 필수 상태는 요약이나 다시 조회할 수 있는 원본 레코드에 보존하고, 이후 작업이 성공적으로 이어지는지를 평가해야 한다. 컨텍스트 한도 초과로 거부된 요청은 저렴하게 성공한 비교 기준이 될 수 없다.
시나리오 2: 더 높은 요금 구간에 들어가기 전에 압축해야 할까?
실제 요금으로 계산했을 때 남은 작업에서 요약 비용을 회수할 수 있다면 압축한다. 요금 임계값을 넘으면 압축의 이점이 커질 수 있지만, 요약 요청 자체도 비싼 구간으로 과금될 수 있다.
Claude Haiku 5.5는 입력이 100,000 토큰을 넘으면 요금이 달라진다. 2026년 11월 4일에 확인한 표준 입력/출력 요금은 이 경계까지 100만 토큰당 $0.10/$0.50, 초과 시 $0.50/$2.50이다.
서로 다른 가상의 도서관 레코드를 Synthorai 게이트웨이로 전송했다. 입력 94,350 토큰인 요청은 $0.009437, 111,999 토큰인 요청은 $0.0560095가 들었다. 두 요청 모두 출력은 4 토큰이었다. 비용 차이에는 입력 길이와 요금 구간의 영향이 모두 포함돼 있다.
다음으로 더 큰 이력을 요약했다. 이 호출은 입력 112,028 토큰을 처리했고, 보고된 캐시 적중은 없었으며, 높은 요금 구간에서 $0.0560715가 들었다. 두 경로 모두 수량과 출처를 묻는 쿼리에 정확히 답했다.
| 남은 쿼리 수 | 이력 유지 | 요약 및 축소된 컨텍스트로 쿼리 | 낮은 요금으로 재계산한 이력 유지 | 낮은 요금으로 재계산한 압축 |
|---|---|---|---|---|
| 1 | $0.0560655 | $0.0560882 | $0.0112131 | $0.0112310 |
| 2 | $0.1120760 | $0.0560944 | $0.0224152 | $0.0112372 |
쿼리 1회에서는 두 경로의 차이가 $0.0000227로, 거의 손익분기점에 도달했다. 이 사례에서는 쿼리 2회로 요약 비용을 확실히 회수했다. 모든 토큰을 낮은 요금으로 다시 계산하면 토큰 양의 영향과 요금 구간의 영향을 분리할 수 있다.
이 캐시 미사용 요청들은 하나의 합성 작업을 측정한 결과다. 이미 캐시된 이력은 양상이 다르다. 요약으로 입력이 요금 경계 아래까지 얼마나 줄어드는지, 새 입력이 언제 다시 경계를 넘는지 확인해야 한다. 긴 컨텍스트의 요금 구간을 참고하자.
시나리오 3: 한 번의 압축 비용을 회수하려면 몇 턴이 더 필요한가?
Claude Sonnet 5.5에서 입력 약 13.5k-14.2k 토큰으로 시작한 캐시 실험 6회의 회수 시점은 이후 4-6턴이었다. 여기서 한 턴은 후속 모델 요청 1회를 뜻한다. 요약 생성과 이후 캐시 쓰기를 비용에 포함했으며, 공통 워밍업 이후 이어진 요청 12회 안에서 처음으로 비용이 역전되는 지점을 찾았다. 6회 모두 역전 이후 요청 12회째까지 압축 경로의 비용이 이력 유지 경로보다 높아지지 않았다. 이 관측 결과는 이후의 캐시 만료, 추가 요약, 작업 변경까지 다루지는 않는다.
압축하면 이미 낸 캐시 쓰기 할증을 낭비하는가?
이미 지불한 쓰기 비용은 의사결정 시점의 매몰비용이다. 앞으로 줄어드는 읽기 비용으로 요약 요청과 새 쓰기 비용을 충당할 수 있는지가 핵심이다. 이 실험은 TTL이 5분인 명시적 캐싱을 사용했다. 암묵적 캐시의 요금은 제공업체마다 다르며, 같은 쓰기 할증이 없을 수도 있다.
중간 증가율의 실험 1회에서 첫 압축과 세션 후반의 추가 요약을 비교하면 차이가 드러난다.
| 압축 시점 | 절감한 후속 읽기 비용 | 추가 후속 쓰기 비용 | 요약 생성 비용 | 12턴까지의 순효과 |
|---|---|---|---|---|
| 첫 요약과 이력 유지 비교 | $0.0159875 | $0.0010175 | $0.0049761 | $0.0099939 절감 |
| 두 번째 요약과 한 번만 요약한 경우 비교 | $0.0037283 | $0.0013925 | $0.0065302 | $0.0041844 증가 |
두 번째 행에는 기타 토큰 비용이 $0.0000100 줄어든 효과가 포함돼 있다. 요약 비용에는 요약 요청 자체의 캐시 항목도 포함되므로 중복 계산하면 안 된다. 토큰 사용량 항목만으로는 개별 항목 중 무엇이 한 번도 재사용되지 않았는지 알 수 없다.
회수 시점 공식은 실측 결과와 얼마나 일치하는가?
간단한 웜 캐시 모델로 비용 회수에 필요한 남은 턴 수를 추정할 수 있다. 교체할 이력 토큰 수를 H, 대체 요약의 입력 토큰 수를 S, 요약 요청의 전체 비용을 A, 캐시 읽기 토큰당 요금을 r, 캐시 쓰기 토큰당 요금을 w라고 하자. 교체할 이력 앞에 있는 고정 지침은 그대로 유지한다.
향후 요청 n회에서 이력을 유지하는 비용은 n*r*H다. 요약으로 교체하는 비용은 A + w*S + (n-1)*r*S다. 두 경로의 비용 차이는 다음과 같다.
compact cost minus retain cost
= A + (w-r)*S - n*r*(H-S)

payback turns
= ceil((A + (w-r)*S) / (r*(H-S)))
이 공식은 H > S이고, 요약이 즉시 캐시 대상이 되며, 요금이 변하지 않고, 이후 추가되는 내용과 출력, 도구 작업이 같다고 가정한다. 캐시 만료, 유지되는 접두부의 추가 재작성, 품질 복구 비용은 포함하지 않는다. 이런 조건이 달라지면 구간별로 나눠 비용을 계산해야 한다.
실험이 끝난 뒤 이 공식을 적용했다. 입력값에는 후속 요청 비용이 아니라 워밍업과 요약의 사용량 명세를 썼지만, 결과는 이미 알고 있었다. 사후 검산이지, 별도 검증 데이터나 사전 예측을 통한 검증은 아니다. 분석에서는 전체 워밍업 입력을 H, 요약 출력 토큰을 S의 근삿값으로 사용했다. 고정 지침, 요청 구성용 텍스트, 캐시 적용 조건 때문에 이 값은 실제로 교체 가능한 이력 및 대체 입력과 정확히 같지는 않다.
| 입력 증가량 | 실행 | 사후 추정 | 실측 회수 시점 |
|---|---|---|---|
| 턴당 약 96 토큰 | 1 | 5턴 | 6턴 |
| 턴당 약 96 토큰 | 2 | 5턴 | 6턴 |
| 턴당 약 1.4k 토큰 | 1 | 5턴 | 5턴 |
| 턴당 약 1.4k 토큰 | 2 | 4턴 | 4턴 |
| 턴당 약 5.2k-5.5k 토큰 | 1 | 5턴 | 5턴 |
| 턴당 약 5.2k-5.5k 토큰 | 2 | 4턴 | 5턴 |
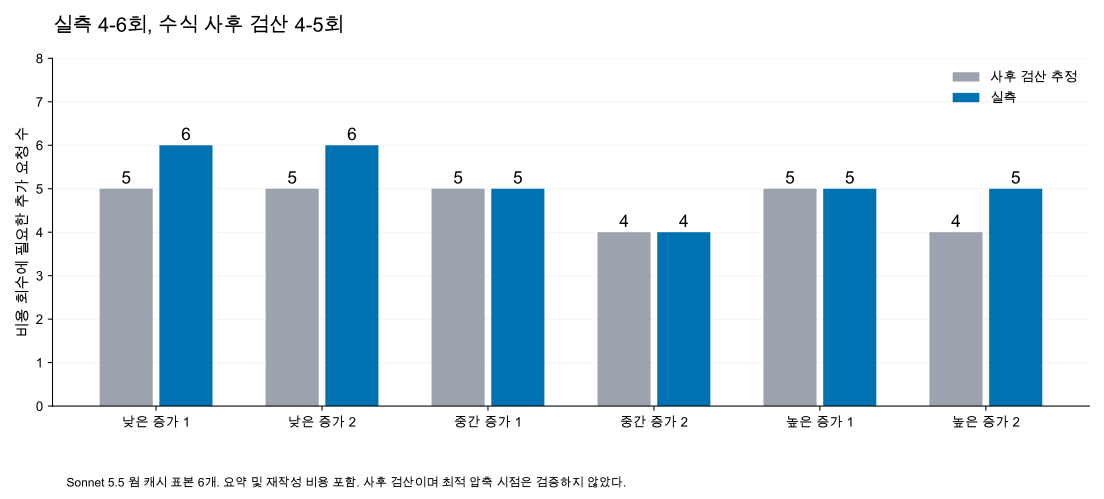
이 6회 실험에서 검산 오차는 최대 1턴이었다. 실제 의사결정에 쓰려면 이전 요약을 바탕으로 A와 S를 추정하고 새 작업에서 검증해야 한다. 이번 비교가 일반적인 오차 범위를 보장하지는 않는다.
DeepSeek의 암묵적 캐시에서는 무엇이 달라지는가?
별도 캐시 쓰기 요금이 없다고 해서 압축 이후 입력이 무료인 것은 아니다. DeepSeek V4.1 Flash 1017은 자동 캐싱을 사용하며, 캐시 적중 입력과 미스 입력의 요금이 다르다. 요금 페이지에는 별도 쓰기 요금이 없다. 새 요약 접두부가 캐시되지 않았다면 여전히 미스 입력 요금이 부과된다.
캐시 문서에 따르면 저장된 접두부 단위가 일치해야 한다. 캐시 생성에는 수 초가 걸리고 적중은 최선 노력 방식이므로, 교체 후 여러 요청에서 미스가 날 수도 있다. prompt_cache_hit_tokens와 prompt_cache_miss_tokens를 추적해야 한다. 콜드 호출이 정확히 1회뿐이라고 가정하거나, 변경하지 않은 시스템 접두부는 항상 적중한다고 가정하면 안 된다.
토큰당 미스 입력 요금을 p, 향후 요청 n회 중 교체된 접두부가 콜드 상태인 요청 수를 m이라고 하자. 이력을 유지하는 기준 경로는 계속 캐시에 적중하고 이후의 공통 비용이 상쇄된다면 다음과 같다.
compact cost minus retain cost
= A + m*(p-r)*S - n*r*(H-S)
콜드 요청이 1회라면 w 자리에 0이 아니라 p를 넣는다. m을 모르면 여러 시나리오를 계산하거나 실제 적중/미스 항목별 사용량으로 비용을 산정한다. 고정 접두부와 요약 호출의 미스도 포함해야 한다.
다음은 공식에 값을 대입한 계산이며, DeepSeek 실험이 아니다. 공식 비혼잡 시간대 Flash 요금인 적중 입력 $0.003/M, 미스 입력 $0.15/M, 출력 $0.60/M을 사용한다. 요약은 1k 토큰, 원래 이력은 웜 상태, 교체 후 콜드 요청은 1회이며, 요약 비용은 A = r*H + output_price*S라고 가정한다. 요청 구성용 텍스트, 추론, 도구는 제외한다.
| 원래 이력 | 가정한 요약 호출 비용 | 계산된 회수 시점 |
|---|---|---|
| 10k 토큰 | $0.000630 | 요청 29회 |
| 100k 토큰 | $0.000900 | 요청 4회 |
읽기 요금이 저렴하면 짧은 이력을 캐시된 상태로 유지하는 편이 유리할 수 있다. 반면 작업이 길면 압축 비용을 회수할 수 있다. DeepSeek의 품질과 회수 시점은 측정하지 않았다. 혼잡 시간대 요금이나 여러 요금이 섞인 세션에는 다시 계산해야 한다.
컨텍스트 증가율은 압축 시점에 어떤 영향을 주는가?
증가율은 의사결정 시점의 이력 크기를 바꾼다. 압축 전까지 j턴이 지났고 매 턴 g 토큰이 추가됐다면, 회수 시점 공식에 H_j = H_0 + g*j와 현재 요약 크기 및 비용을 넣는다.
이후 두 경로에서 같은 양이 늘어나면 양쪽에 공통 비용이 추가된다. 요금과 캐시 동작이 같다면 이 항들은 상쇄된다. 증가율이 높으면 용량이나 요금 제약에 더 빨리 도달하지만, 증가율만으로 회수 턴 수가 정해지지는 않는다.
증가율 실험에서는 필수 상태는 작게 유지하고 보관용 데이터만 늘렸다. 12턴 실험을 각각 2회 진행한 결과, 반복 압축은 중간 증가율에서 한 번만 요약한 경우보다 비쌌고 높은 증가율에서는 더 저렴했다. 연장 구간까지 포함해 모든 정책이 상태 쿼리 96/96개에 정확히 답했다. 다만 필수 상태가 무한히 커지는 상황을 테스트한 것은 아니다.
작업을 계속할 때 모델이 제시하는 압축 주기는?
증가율, 요약 크기, 요금, 캐시 동작이 대체로 일정한 장기 작업을 가정하자. 요약 출력과 대체 요약의 재쓰기를 포함한 압축 주기당 고정 비용을 F라고 한다. 주기에 선형으로 비례하는 비용은 제외한다. 이를 턴당 평균으로 환산하면 상수가 되기 때문이다. 요약 모델이 이력을 캐시에서 읽는다면 F를 A - r*H + w*S로 추정한다. 과금 방식이 다르면 그에 맞게 비용을 분해해야 한다. 턴당 증가량이 g, 요약 간격이 k일 때, 주기에 따라 달라지는 평균 비용은 다음과 같다.
average interval-dependent cost = F/k + r*g*(k-1)/2
candidate interval k = sqrt(2*F/(r*g))
candidate history threshold = S + g*k
이 모델은 F, r, g가 양수이고, 유지되는 요약이 작으며, 작업 품질이 비슷해야 성립한다. 증가량이 0이면 증가에 따른 주기적 실행 조건이 없다. 읽기가 무료라면 이 모델로는 읽기 비용을 절감해 압축 비용을 회수할 수 없다. 실험의 명시적 캐시 요금과 요약 크기를 대입하면 낮은 증가율에서는 약 30턴, 중간에서는 7-8턴, 높은 경우에는 4턴이 후보로 나온다. 용량 여유를 확보하면서 요청 1회 이상의 인접 정수 주기를 테스트해야 한다. 주기를 바꿔가며 실험해 이 값이 최적임을 확인하지는 않았다. 미스 입력에 과금하는 캐시는 고정 비용을 별도로 분해해야 한다.
실제 계산으로 단위를 확인해 보자. 기록된 중간 증가율 실험 1회에서 A = $0.0049761, H = 13,712, S ≈ 341, g ≈ 1,396 tokens/turn이었다. r = $0.10/M, w = $2.50/M을 사용하면 다음과 같다.
F ≈ 0.0049761 - (0.10/1,000,000)*13,712
    + (2.50/1,000,000)*341
  = $0.0044574 per cycle

k ≈ sqrt(2*0.0044574 / ((0.10/1,000,000)*1,396))
  ≈ 8 requests
기록된 값으로 후보를 계산한 것이지, 요청 8회마다 압축하는 정책이 최적이라고 입증한 것은 아니다. 작업 종료까지 남은 요청 수에 대한 검토는 별개다. 압축 비용 회수에 요청 5회가 필요하다고 추정되는데 3회만 남았다면, 주기상 실행 시점이 됐더라도 선택적 압축은 건너뛴다.
작업이 끝나갈 때는 남은 요청에서 비용을 회수할 수 없는 추가 요약을 생략한다. 용량, 요금 구간, 필수 정보 보존 요건은 이 단순화된 금전적 모델보다 우선한다.
짧은 아카이브 워크로드가 이 판단의 예다. 두 전략 모두 수량 질문 6개에 정확히 답했지만, 이력 유지 비용은 $0.0059911, 요약을 포함한 비용은 $0.0156941이었다. 쿼리 6회로는 압축 비용을 회수하지 못했다. 요약에 충분한 세부 정보가 남아 있어 추가 조회는 필요하지 않았다. 회수에 필요한 기간은 실제 요약과 워크로드에 달려 있으며, 어디서나 통하는 4-6턴 규칙은 없다.
전체 비용은 어떻게 측정해야 하는가?
요약, 교체 후 첫 요청, 모든 후속 요청을 포함해야 한다. 프롬프트 토큰 감소량과 캐시 적중률만으로는 비용 절감을 입증할 수 없다.
Claude Sonnet 5.5의 비용 계산에는 신규 입력 $2/M, TTL 5분 캐시 쓰기 $2.50/M, 캐시 읽기 $0.10/M, 출력 $10/M을 사용했다. 캐시 읽기는 저렴하지만 무료는 아니다. 웜 상태의 이력을 교체하면 새 쓰기가 발생할 수 있고, 요약이 너무 짧으면 캐시 대상조차 되지 않을 수 있다. 콘텐츠 블록에 명시적으로 설정한 캐시 분기점에서는 쓰기와 읽기가 사용량으로 확인됐다. 반면 짧게 압축한 일부 접두부는 초기에 쓰기와 읽기 모두 보고되지 않았다.
다음 함수는 접두부가 콜드 상태인 요청 수를 지정한다고 가정한다. 명시적 쓰기 요금이나 암묵적 캐시의 미스 입력 요금을 cold_input_per_million에 전달한다.
import math


def payback_turns(summary_cost, history_tokens, summary_tokens,
                  read_per_million=0.10, cold_input_per_million=2.50,
                  cold_requests=1):
    if cold_requests < 0 or int(cold_requests) != cold_requests:
        raise ValueError("cold_requests must be a nonnegative integer")
    r = read_per_million / 1_000_000
    p = cold_input_per_million / 1_000_000
    if summary_cost < 0 or p < r:
        raise ValueError("Unsupported cost assumptions")
    if history_tokens <= summary_tokens or r <= 0:
        return None
    upfront = summary_cost + cold_requests * (p - r) * summary_tokens
    saving_per_turn = r * (history_tokens - summary_tokens)
    return max(1, cold_requests, math.ceil(upfront / saving_per_turn))
압축 전에 의사결정하려면 이전 호출을 바탕으로 요약 비용을 추정한다. 실패와 복구 작업을 포함한 전체 사용량 명세로 검증해야 한다. 사용량 명세가 없다고 무료 요청인 것은 아니다.
측정은 2026년 11월 4일 게이트웨이의 Messages 인터페이스로 진행했다. thinking은 비활성화했고 호스팅 도구는 사용하지 않았다. 일반 응답의 출력 한도는 128 토큰, 요약은 2,048 토큰이었다. 반환된 사용량에 표준 요금을 적용해 비용을 재구성하고, 게이트웨이가 보고한 비용과 대조했다. 공급업체 청구서와 대사한 결과는 아니다. 일반 워크로드에서는 네이티브 압축 구현이 아니라 클라이언트 측 요약을 사용했다.
어떤 정책을 운영에 적용해야 하는가?
입력, 도구 결과, 출력을 위한 여유 공간을 두고 용량 및 요금 제약부터 적용한다. Claude Sonnet 5.5의 명시적 캐시 워크로드에서는 쓰기 할증과 요약 비용을 포함하고, 작업 종료 전에 비용을 회수하기 어려운 선택적 압축은 건너뛴다. 동일한 작업 유입과 종료 턴을 기준으로, 공식에서 구한 후보 주변의 정수 주기를 검증한다.
DeepSeek V4.1 Flash 1017의 암묵적 캐싱에서는 적중이 안정적이고 남은 작업이 적다면 유용한 접두부를 유지한다. 용량에 여유가 있을 때 실행하는 소프트 트리거를 더 늦게 설정하는 것도 합리적일 수 있다. 별도 쓰기 요금이 없다고 하드 한계까지 기다려도 된다는 뜻은 아니다. 작업이 길다면 실제 적중/미스 비용을 추정하고, 재작성 이후 캐시 적중이 나타날 때까지 요청을 관찰한다.
요금, 캐시 상태, 모델, 필수 상태 크기가 바뀌면 다시 계산한다. 원본은 다시 조회할 수 있도록 보관하고, 세부 정보에 민감한 작업에서는 변경된 값을 검증한다. 올바른 토큰 사용량 항목을 사용해 요약과 이후 사용량을 하나의 에이전트 세션에 기록한다.
자주 묻는 질문
컨텍스트 압축은 항상 API 비용을 줄이는가?
절감액이 요약, 캐시 재구성, 복구 비용을 넘어야 한다. 쿼리 6개로 구성된 아카이브 작업은 요약 시 $0.0156941, 이력 유지 시 $0.0059911이 들었고, 정확도는 모두 6/6이었다.
요금 임계값에 정확히 맞춰 압축해야 하는가?
요금 임계값은 남은 전체 워크로드를 평가할 시점이지, 자동으로 요약하라는 신호가 아니다. Claude Haiku 5.5 사례에서는 요약 자체도 100,000 토큰 초과 요금으로 과금됐다. 이후 쿼리 1회에서는 거의 손익분기점이었고, 2회에서는 비용을 확실히 회수했다.
컨텍스트 창이 가득 찰 때까지 기다려도 되는가?
요약 요청, 다음 입력과 도구 결과, 출력을 위한 공간을 남겨야 한다. 이력이 이미 너무 커졌다면 요약 요청조차 들어가지 않을 수 있다. 이번 실험에서는 최대 컨텍스트 창에서 요청이 실패하는 경계를 측정하지 않았다.
컨텍스트가 더 빨리 늘어나면 한 번의 요약 비용도 항상 더 빨리 회수되는가?
두 경로에서 컨텍스트가 똑같이 빠르게 늘어나면 양쪽 비용이 모두 올라간다. 한 번의 요약으로 얻는 절감액이 자동으로 커지는 것은 아니다. 반복 압축으로 추가 누적을 제한할 수 있지만, 요약과 재쓰기 비용도 늘어난다. 중간 증가율 실험에서는 12턴 동안 반복 압축이 한 번만 요약한 경우보다 비쌌고, 높은 증가율에서는 반복 압축이 유리했다. 증가율, 남은 작업 기간, 유지해야 할 상태를 바탕으로 정책을 선택해야 한다.
암묵적 캐시를 쓰면 컨텍스트 한도까지 기다려야 하는가?
작업이 짧다면 암묵적 캐시에서는 저렴한 웜 상태의 이력을 유지하는 편이 유리할 수 있다. DeepSeek V4.1 Flash 1017도 캐시되지 않은 요약 접두부에는 미스 입력 요금을 부과하며, 캐시 저장은 최선 노력 방식이다. 남은 작업에서 얻을 이익을 추정하되, 지원되는 컨텍스트 창 안에 도구, 입력, 출력을 위한 여유 공간을 남겨야 한다. 위의 DeepSeek 값은 계산 결과이지 실측 임계값이 아니다.