
GPT Image 2.6 Sunburst, Flare e GPT Image 2 nelle modifiche
Indice
- Cosa è cambiato in GPT Image 2.6?
- Come si confrontano GPT Image 2, 2.5 e 2.6 su Arena?
- Come si sono comportati GPT Image 2, Sunburst e Flare sulle stesse modifiche?
- Quanto tempo hanno impiegato i tre modelli per modificare il programma?
- La complessità alta ha migliorato la modifica del programma?
- Quando il markup aiuta GPT Image 2.6 a scegliere l’oggetto corretto?
- Come sono state testate le modifiche?
- Domande frequenti
- Il confronto con GPT Image 2 usa lo stesso livello di pianificazione?
- Avete testato GPT Image 2.5 tramite Synthorai?
- Quando conviene usare il markup per modificare un’immagine?
- La complessità alta ha reso più affidabili le modifiche del programma?
GPT Image 2 ed entrambe le varianti di GPT Image 2.6 hanno aggiornato tre campi sulla stessa etichetta alimentare senza alterare il testo circostante. Su un programma di conferenza, Sunburst ha superato 2 rendering su 4 a complessità media. Flare a complessità media e GPT Image 2 con la pianificazione predefinita hanno ottenuto 0/4. Il compito consisteva nello scambiare due interventi e fare in modo che il badge FULL seguisse uno dei due.
TL;DR
- GPT Image 2 ed entrambe le varianti 2.6 hanno superato la stessa modifica dell’etichetta alimentare.
- Sul programma, Sunburst ha ottenuto 2/4 a complessità media. GPT Image 2 e Flare hanno ottenuto 0/4.
- Sunburst ha superato 2/4 rendering del programma con
complexitymedia e alta. Flare ha scambiato correttamente entrambi gli interventi in 0/4 rendering a complessità media e 2/4 ad alta, senza però superare l’intero test in nessuna delle due configurazioni: 0/4. - Un’indicazione visiva ha portato la selezione dell’oggetto corretto da 1/4 a 4/4 quando il testo non ne specificava la posizione.
Cosa è cambiato in GPT Image 2.6?
OpenAI ha rilasciato Images 2.6 il 4 novembre 2026. Sunburst è pensato per lavori dettagliati e modifiche coerenti, mentre Flare punta su iterazioni più rapide. La release ha introdotto anche le annotazioni visive nell’API, un controllo per la pianificazione e i formati di output GIF e SVG. Note di rilascio di OpenAI
L’impostazione complexity controlla la pianificazione prima del rendering. L’impostazione separata quality regola invece il livello di dettaglio del rendering. OpenAI documenta tre livelli di pianificazione, low, medium e high; nella sua API il valore predefinito è high. Nelle richieste ai modelli 2.6 abbiamo impostato esplicitamente entrambi i parametri. Guida OpenAI alla generazione di immagini
Come si confrontano GPT Image 2, 2.5 e 2.6 su Arena?
I dati di GPT Image 2.5 provengono esclusivamente dalla classifica pubblica di Arena per la modifica di singole immagini. Nell’istantanea del 12 novembre 2026, entrambe le voci 2.5 avevano punteggi visualizzati superiori a quelli delle voci 2.6 Medium elencate. I punteggi di Arena riflettono le preferenze degli utenti. Le voci hanno quantità di voti ed etichette di configurazione diverse; i punteggi riportati sotto mantengono l’incertezza mostrata da Arena. Classifica Arena per la modifica di immagini singole
| Voce Arena | Punteggio mostrato | Voti |
|---|---|---|
| GPT Image 2.5 Sunburst | 1519 ± 5 | 131,648 |
| GPT Image 2.5 Flare | 1484 ± 4 | 128,720 |
| GPT Image 2.6 Sunburst (Medium) | 1476 ± 11 | 3,493 |
| GPT Image 2 (Medium) | 1462 ± 3 | 364,695 |
| GPT Image 2.6 Flare (Medium) | 1460 ± 10 | 3,534 |
“Medium” è l’etichetta usata da Arena. Nel nostro test sul gateway, la richiesta a GPT Image 2 non includeva il campo complexity.
Come si sono comportati GPT Image 2, Sunburst e Flare sulle stesse modifiche?
Tutti e tre i modelli hanno superato il test sull’etichetta alimentare. GPT Image 2 ed entrambe le varianti 2.6 hanno modificato correttamente il valore del sodio, il codice del lotto e il peso netto, preservando il testo circostante. Sunburst e Flare hanno inoltre superato tutte e sei le modifiche semplici e preservato i dettagli circostanti nei test con il tappo della bottiglia e il badge di riferimento, quando la posizione era indicata chiaramente.
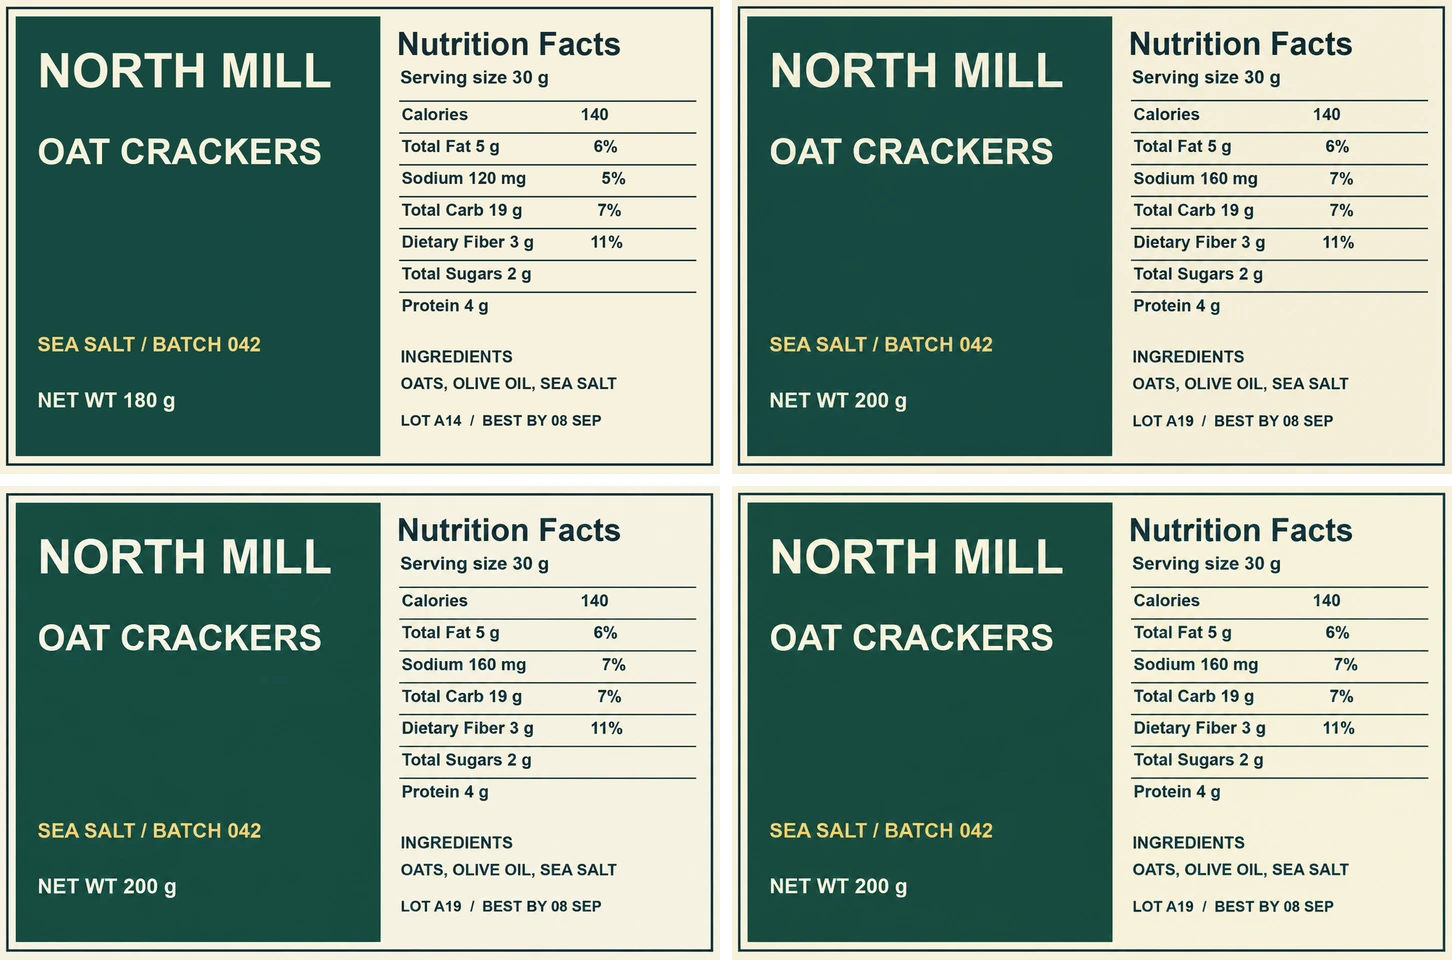
Riga superiore: originale e GPT Image 2. Riga inferiore: Sunburst e Flare. GPT Image 2 usa la pianificazione predefinita, mentre entrambe le varianti 2.6 usano una complessità media.
Per il programma, abbiamo chiesto a ogni modello di scambiare titoli e relatori di Studio B alle 10:00 e Studio C alle 11:30, quindi di aggiungere FULL a Sound Lab nella nuova posizione. GPT Image 2 ha lasciato sistematicamente Sound Lab nella posizione originale e ha scambiato altri due interventi. Sunburst ha spostato correttamente entrambi gli interventi richiesti in tutti e quattro i rendering a complessità media. In due casi, il badge è rimasto nella vecchia posizione.
| Modello | Impostazione di pianificazione | Etichetta alimentare, test superato | Programma, entrambi gli interventi nelle posizioni corrette | Programma, test superato |
|---|---|---|---|---|
| GPT Image 2 | Predefinita, campo omesso | 1/1 | 0/4 | 0/4 |
| GPT Image 2.6 Sunburst | Media | 1/1 | 4/4 | 2/4 |
| GPT Image 2.6 Flare | Media | 1/1 | 0/4 | 0/4 |
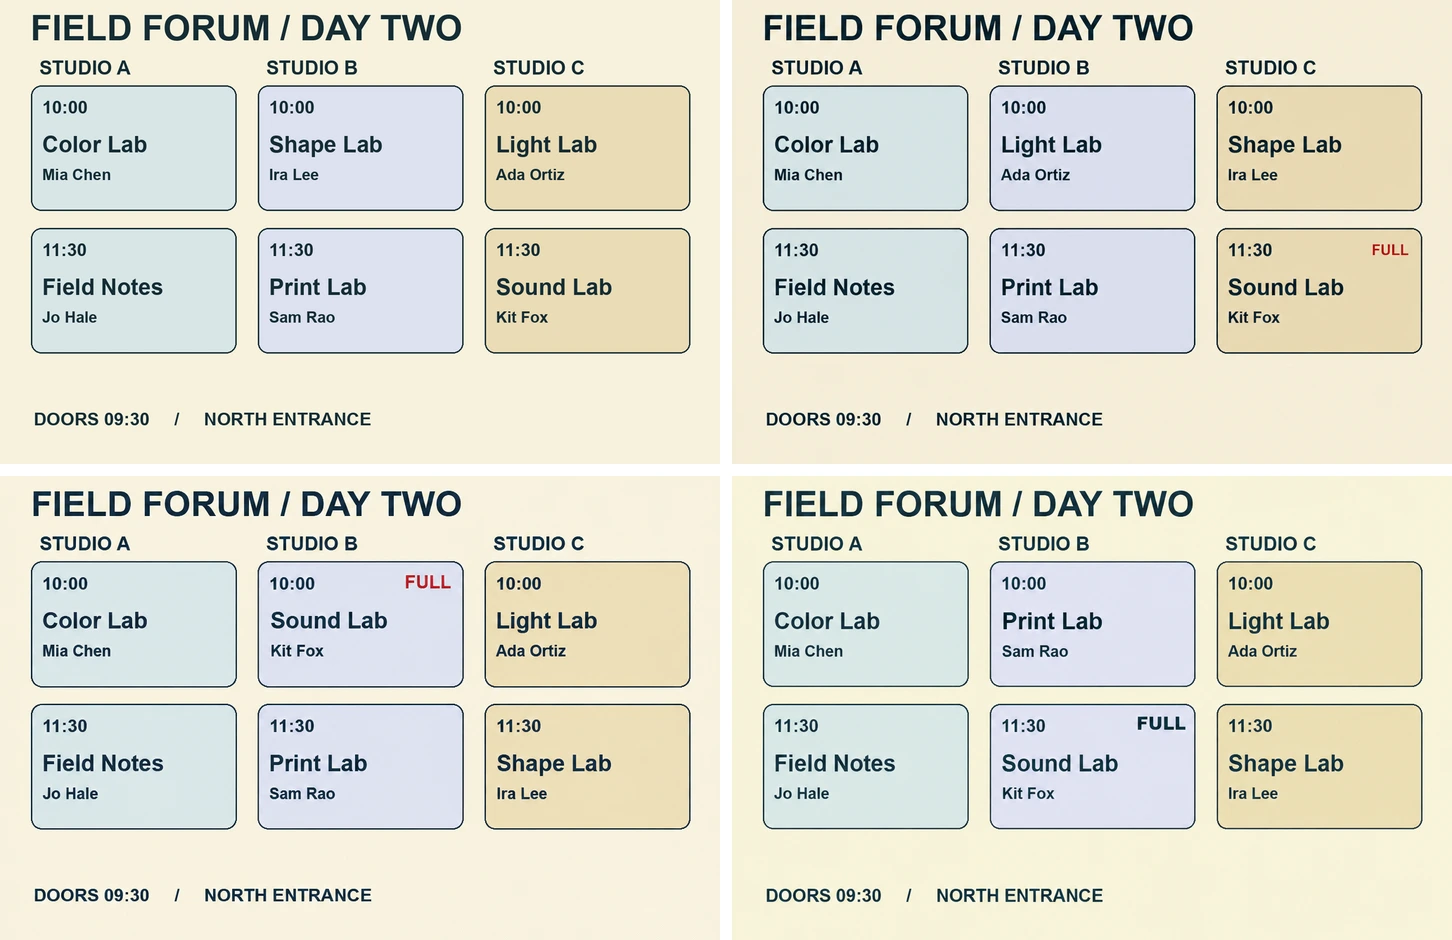
Riga superiore: originale e GPT Image 2. Riga inferiore: un rendering di Sunburst e uno di Flare. La tabella include tutti e quattro i rendering per modello. GPT Image 2 usa la pianificazione predefinita, mentre entrambe le varianti 2.6 usano una complessità media.
Tutti e tre i modelli hanno ricevuto le stesse immagini di origine e gli stessi prompt tramite Synthorai, con la stessa dimensione di output e quality: "medium". La richiesta a GPT Image 2 non includeva complexity. Per questa tabella, le due richieste ai modelli 2.6 impostavano esplicitamente complexity: "medium". Il livello effettivo di pianificazione di GPT Image 2 non è noto, quindi la tabella confronta le tre configurazioni API così come sono state eseguite. Il punteggio dell’etichetta alimentare deriva da un solo rendering. Quello del programma deriva da quattro tentativi sullo stesso layout.
Quanto tempo hanno impiegato i tre modelli per modificare il programma?
Sulla stessa immagine del programma e con lo stesso prompt, Flare ha restituito un’immagine in 7.5 secondi di mediana, seguito da Sunburst con 18.9 secondi e GPT Image 2 con 27.0 secondi. Ogni mediana comprende quattro risposte API riuscite, ottenute dallo stesso host di test tramite Synthorai. Il tempo è stato misurato dall’invio della richiesta alla ricezione della risposta completa con l’immagine.
| Modello e impostazione di pianificazione | Risposte riuscite | Mediana | Intervallo |
|---|---|---|---|
| GPT Image 2, predefinita | 4 | 27.0 s | 26.0 to 47.5 s |
| GPT Image 2.6 Sunburst, media | 4 | 18.9 s | 18.3 to 21.3 s |
| GPT Image 2.6 Flare, media | 4 | 7.5 s | 7.2 to 8.0 s |
I tempi misurano la latenza end-to-end di una singola modifica con qualità di rendering media. GPT Image 2 è stato eseguito in un batch separato, senza specificare il campo di pianificazione.
La complessità alta ha migliorato la modifica del programma?
Flare ha scambiato correttamente entrambi gli interventi in due rendering a complessità alta e in nessun rendering a complessità media. Per entrambi i modelli, il numero di test superati è rimasto uguale nelle due configurazioni. Il programma richiedeva che due modifiche restassero collegate. Prima bisognava scambiare titoli e relatori di Studio B alle 10:00 e Studio C alle 11:30, mantenendo stanza e orario nelle rispettive posizioni originali. Poi occorreva aggiungere FULL alla scheda che ora conteneva Sound Lab. Un rendering poteva scambiare correttamente entrambi gli interventi ma associare FULL alla vecchia posizione.
È quanto è successo nell’esempio di Sunburst qui sotto. Entrambi i rendering hanno spostato Sound Lab in Studio B alle 10:00 e Shape Lab in Studio C alle 11:30. Nel rendering a complessità media, FULL è stato applicato a Sound Lab. In quello a complessità alta è stato applicato a Shape Lab, nella posizione precedentemente occupata da Sound Lab.
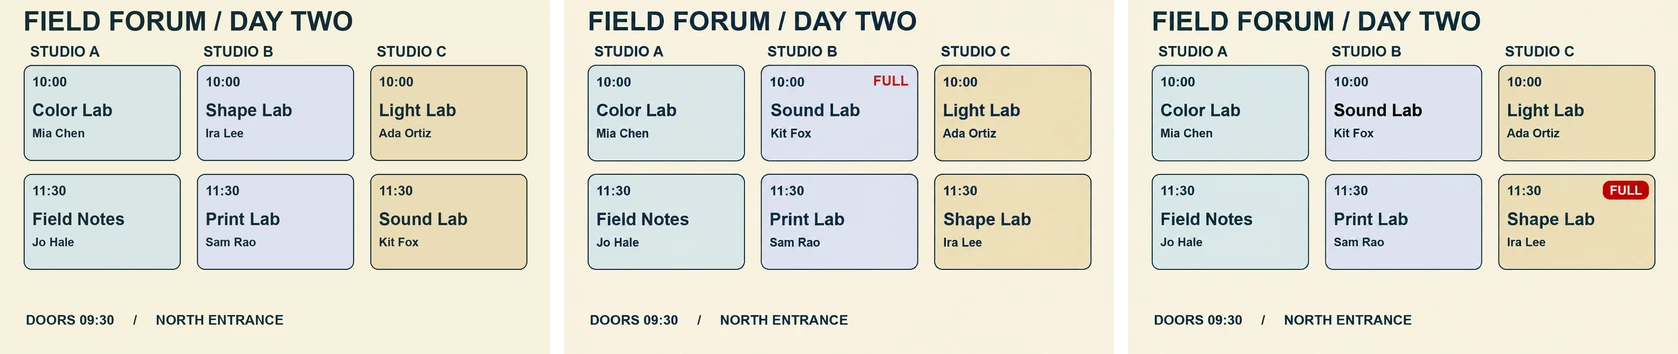
Da sinistra a destra: programma originale, un rendering corretto di Sunburst a complessità media e un rendering di Sunburst a complessità alta con il badge sulla vecchia posizione.
I 16 rendering hanno usato lo stesso programma di origine, con quattro output per modello e impostazione di complessità.
| Modello | Media, entrambi gli interventi scambiati correttamente | Media, test superato | Alta, entrambi gli interventi scambiati correttamente | Alta, test superato |
|---|---|---|---|---|
| Sunburst | 4/4 | 2/4 | 4/4 | 2/4 |
| Flare | 0/4 | 0/4 | 2/4 | 0/4 |
Due rendering di Sunburst per ciascuna impostazione hanno applicato FULL alla scheda sbagliata. Anche entrambi i rendering di Flare ad alta complessità che avevano scambiato correttamente gli interventi hanno posizionato male il badge. Con quattro rendering per impostazione su un solo programma, i conteggi descrivono questa specifica modifica. Le 12 richieste ripetute hanno riportato lo stesso numero di token di input e output per entrambe le impostazioni.
In un workflow di pubblicazione di eventi, controllate ogni posizione interessata e verificate il badge nell’immagine finale prima della pubblicazione. Se il programma deriva da dati strutturati dell’evento, generate testo e badge da quei dati, così il badge seguirà l’evento quando cambia posizione.
Quando il markup aiuta GPT Image 2.6 a scegliere l’oggetto corretto?
Il markup è stato utile quando nell’immagine erano presenti più oggetti ugualmente validi e il testo non specificava quale scegliere. Abbiamo fornito a GPT Image 2.6 Sunburst e GPT Image 2.6 Flare una griglia di sei bottiglie identiche, chiedendo di rendere dorato e lucido esattamente un tappo. Il testo è rimasto identico in entrambe le condizioni. Indicava di modificare il tappo cerchiato, se era presente un’annotazione, senza fornire alcuna posizione testuale.
Abbiamo scelto come obiettivi il tappo in alto al centro e quello in basso a destra. Senza overlay, qualsiasi corrispondenza con il tappo designato era casuale. Nella figura sotto, Flare ha scelto il tappo in alto al centro senza markup. Con l’overlay ha modificato quello in basso a destra, lasciando neri gli altri cinque.
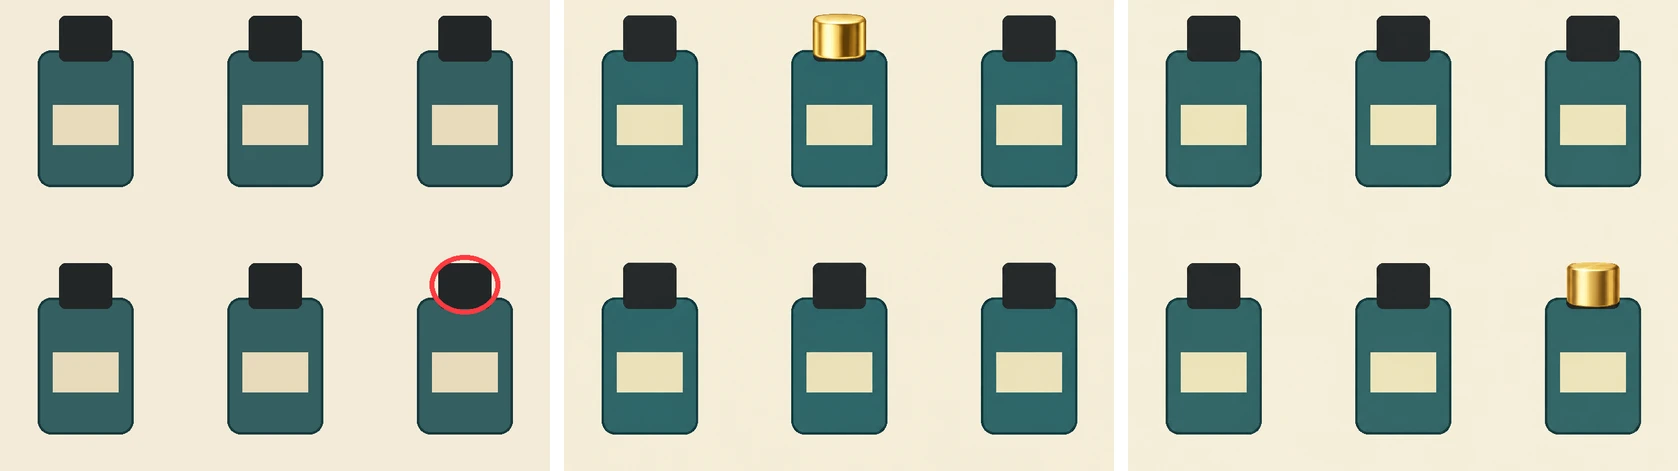
Da sinistra a destra: input con l’overlay mostrato in rosso, Flare senza markup e Flare con markup. La richiesta ha inviato l’immagine di origine e l’overlay come input separati.
| Tappo designato | Sunburst senza markup | Sunburst con markup | Flare senza markup | Flare con markup |
|---|---|---|---|---|
| In alto al centro | In alto al centro | In alto al centro | In alto a destra | In alto al centro |
| In basso a destra | In alto al centro | In basso a destra | In alto al centro | In basso a destra |
| Obiettivi centrati | 1/2 | 2/2 | 0/2 | 2/2 |
In tutti gli otto output, i modelli hanno modificato un solo tappo, lasciato neri gli altri cinque e omesso il cerchio dall’immagine generata. L’overlay ha determinato quale tappo modificare. In altri due test nei quali il testo specificava già la posizione dell’obiettivo, sostituire alcuni tappi e applicare un badge su una confezione, 4/4 output hanno soddisfatto i criteri del test in entrambe le condizioni.
Il risultato sulla posizione deriva da due obiettivi su una sola immagine sintetica, con un rendering per modello e condizione. In un workflow in cui un utente seleziona un oggetto su un canvas, la figura mostra un impiego diretto di quella selezione. Quando il testo identificava già un obiettivo univoco, l’overlay aggiuntivo non ha prodotto benefici osservabili nei due test descritti sopra.
Come sono state testate le modifiche?
Abbiamo inviato richieste JSON tramite l’endpoint di generazione immagini di Synthorai. Ogni richiesta ha generato un PNG da 1024 × 1024 con quality impostato su medium. Nel confronto delle bottiglie abbiamo mantenuto la complessità media e variato l’overlay. Il confronto del programma ha usato quattro output riusciti per modello e impostazione. Le richieste a GPT Image 2 sono state eseguite in un batch separato e chi le ha valutate conosceva il modello. Lo stesso valutatore ha usato immagini 2.6 numerate per i test ripetuti, applicando la stessa checklist. Il programma superava il test solo se le due schede di destinazione erano corrette, il badge seguiva Sound Lab, le altre quattro schede e le etichette di stanza e orario restavano invariate e il piè di pagina e la griglia rimanevano intatti.
L’esempio usa l’endpoint JSON di Synthorai all’indirizzo /v1/images/generations. OpenAI documenta le modifiche guidate dal markup sul proprio endpoint nativo /v1/images/edits. Guida OpenAI alla generazione di immagini Synthorai Image API
Per riprodurre la richiesta a Flare con markup, salvate entrambi i file accanto allo script. L’overlay è un PNG trasparente delle stesse dimensioni dell’immagine di origine, con un cerchio attorno al tappo in basso a destra. PNG di origine · PNG dell’overlay
import base64
import json
import os
from pathlib import Path
from urllib.request import Request, urlopen

def png_data_url(path):
    return "data:image/png;base64," + base64.b64encode(Path(path).read_bytes()).decode()

payload = {
    "model": "gpt-image-2.6-flare",
    "prompt": (
        "Change exactly one bottle cap from black to polished gold. "
        "If a cap is circled in the annotation, change that cap. "
        "Keep all other caps black and preserve the six bottles and layout. "
        "Do not reproduce the circle."
    ),
    "image": png_data_url("bottles.png"),
    "markup": png_data_url("cap-overlay.png"),
    "complexity": "medium",
    "quality": "medium",
    "size": "1024x1024",
    "n": 1,
    "output_format": "png",
}

request = Request(
    "https://synthorai.io/v1/images/generations",
    data=json.dumps(payload).encode(),
    headers={
        "Authorization": f"Bearer {os.environ['SYNTHORAI_API_KEY']}",
        "Content-Type": "application/json",
    },
)
with urlopen(request, timeout=240) as response:
    result = json.load(response)

Path("edited.png").write_bytes(base64.b64decode(result["data"][0]["b64_json"]))
print(result.get("usage"))
Domande frequenti
Il confronto con GPT Image 2 usa lo stesso livello di pianificazione?
La richiesta a GPT Image 2 non includeva complexity. Sunburst e Flare usavano esplicitamente una complessità media nella tabella con i tre modelli. Gli input e le impostazioni di output corrispondono, e i risultati valgono per queste specifiche configurazioni API.
Avete testato GPT Image 2.5 tramite Synthorai?
GPT Image 2.5 Sunburst e Flare compaiono solo nella tabella pubblica di Arena. L’esperimento su Synthorai ha usato GPT Image 2, GPT Image 2.6 Sunburst e GPT Image 2.6 Flare. Classifica Arena per la modifica di immagini singole
Quando conviene usare il markup per modificare un’immagine?
Usate markup quando potete indicare direttamente sull’immagine l’oggetto da modificare, soprattutto se sono presenti più oggetti simili. Inviate l’annotazione come PNG trasparente separato e descrivete la modifica nel prompt. Nell’immagine con le sei bottiglie, il tappo corretto è stato selezionato in 4/4 richieste con markup e 1/4 richieste senza markup.
La complessità alta ha reso più affidabili le modifiche del programma?
Su questo layout, Sunburst ha ottenuto 2/4 con entrambe le impostazioni e Flare 0/4 con entrambe. Flare ha posizionato correttamente entrambi gli interventi in due rendering ad alta complessità, ma in entrambi i casi il badge FULL era nella posizione sbagliata.