
GPT-6.1 Terra 对比 GPT-5.6 Terra 与 Sol:192 次 API 调用
目录
GPT-6.1 Terra 是 OpenAI 面向视觉工作流的低成本模型,输入价格为每百万 token $1,输出价格为每百万 token $5,均为 GPT-6.1 Sol 的一半。推理强度决定模型在回答前进行多少内部推理。none 会关闭推理;使用其他设置时,推理 token 计入输出费用。在我们的测试中,关闭推理后,全部 16 道表格和按钮选择题都通过了,但发票图像计算只通过 3/8,对应的纯文本计算则为 0/8。
TL;DR
- 在我们的合成测试中,GPT-6.1 Terra
none通过了 16/16 道表格和截图任务,但发票图像计算只通过 3/8。 - GPT-6.1 Terra
low通过了 24/24 道图像任务和 7/8 道对应的文本发票任务;medium分别通过 24/24 和 8/8。 - 处理 24 张图像,GPT-6.1 Terra
medium花费 $0.028290,GPT-6.1 Sollow花费 $0.055012。 - 在另一轮条件一致的对比中,处理 24 张图像,GPT-6.1 Terra
medium花费 $0.028269,GPT-5.6 Terra 花费 $0.072094。
GPT-6.1 Terra 在 OpenAI 模型系列中是什么定位?
GPT-6.1 Terra 面向视觉推理、屏幕操作和简洁写作,价格低于 GPT-6.1 Sol。OpenAI 于 2026 年 10 月 26 日发布 Terra。其模型选择指南推荐将它用于边界清晰、结果可验证的任务,包括屏幕工作流和范围明确的代码修复。复杂项目仍更适合使用通用性更强的 Sol。
GPT-5.6 Terra 是上一代基线,用于判断是否升级。Sol 是当前价格更高的选项,用于判断该选哪个模型档位。这三个模型对应两类决策:
| 规格 | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| 在本次对比中的定位 | 上一代基线 | 新一代视觉工作流模型 | 面向复杂工作的高价选项 |
| 标准输入价格,每 1M token | $2 | $1 | $2 |
| 标准输出价格,每 1M token | $12 | $5 | $10 |
| 缓存输入读取价格,每 1M token | $0.20 | $0.05 | $0.10 |
| 上下文窗口 | 1,050,000 token | 1,050,000 token | 1,050,000 token |
| 最大输出 | 128,000 token | 128,000 token | 128,000 token |
| 推理设置 | none, low, medium, high, xhigh, max | none, low, medium, high, xhigh, max | low, medium, high, xhigh, max |
| 默认推理设置 | medium | medium | medium |
| 输入/输出模态 | 文本和图像/文本 | 文本和图像/文本 | 文本和图像/文本 |
| 测试使用的端点 | Responses API | Responses API | Responses API |
来源:官方 GPT-5.6 Terra 文档、GPT-6.1 Terra 文档、Sol 文档和发布日志。上表价格适用于输入不超过 272,000 token 的 Standard 请求。超过该阈值后,整个请求的非缓存输入单价翻倍,输出单价上涨 50%。缓存写入另行计价;我们测量的主实验请求均未报告缓存读取或写入。
新 Terra 保留了上一代的上下文窗口、输出上限和推理设置名称。其标价中,输入价格降低 50%,输出价格降低 58.3%。后文的同条件升级测试会区分降价、token 用量变化和任务正确率各自的影响。
官方基准测试说明了什么?
OpenAI 在发布时对比了 GPT-6.1 Terra、GPT-5.6 Terra 和 GPT-6.1 Sol。发布文章实际披露的数据如下:
| 评测 | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| Agents’ Last Exam:专业视觉工作流 | 基线,未披露绝对分数 | medium 下比上一代高 15 个百分点,任务成本约为上一代的三分之一 | 未披露绝对分数 |
| MMMU-Pro:视觉推理 | 所有已报告设置下均低于新 Terra,未披露分数 | 接近 Sol,未披露分数 | 文中称新 Terra 已接近它,未披露分数 |
| Terminal-Bench 4.0:终端编程任务 | 公布分数为 21.5%,未说明推理强度 | max 下为 50.3% | 未披露分数 |
| 内部事实准确性测试:错误率越低越好 | low 下错误率为 53.6% | low 下错误率为 16.7% | 未披露 low 下的错误率 |
来源:OpenAI 发布时的评测。未公开的分数仍属未知;事实准确性评测为内部测试。下面的 API 测试使用同一组合成任务,评估升级和模型档位选择。
我们如何测试推理设置?
我们测试了 GPT-6.1 Terra 的 none、low、medium,以及 GPT-6.1 Sol 的 low。每种配置使用 32 个输入:24 张图像和 8 个对应的文本对照,共计 128 次主实验调用。另设一轮升级对比,在同样的 32 个输入上交错调用 GPT-5.6 Terra 和 GPT-6.1 Terra,均使用 medium,并为新 Terra 重新生成响应。这一轮增加 64 次调用,总计 192 次。升级对比表仅使用这一独立批次的数据。
| 任务类别 | 每种配置的输入数 | 要求的结果 |
|---|---|---|
| 发票图像 | 8 | 计算各行金额,扣除折扣,计算税额并舍入,再扣除预付款 |
| 表格筛选 | 8 | 汇总指定地区和季度的数据,再计算退货率 |
| 应用截图 | 8 | 在相似卡片中识别正确的控件 ID,并给出按钮内部的一个坐标点 |
| 发票文本对照 | 8 | 根据精确转写的文本,计算相同的发票数值 |
我们用三个模板生成了答案已知的虚构文档,并调整数值或布局。每张图像为 960 × 640 像素,提交时使用 detail: "high"。同一张发票的图像版和文本版使用相同的任务指令、schema 和业务规则。每个输入在每种配置下只获取一次响应。
测试于 2026 年 10 月 29 日通过 Synthorai 发起,使用 streaming Responses 请求,统一设置 4,096 token 的输出上限,并交错运行各配置。主实验的 128 次响应全部完成,返回的 JSON 均符合 schema。任务完全正确要求所有指定值都匹配;截图坐标必须落在正确按钮内部。评分由代码完成,使用整数分币和十进制舍入,不使用模型裁判。
这 24 张图像只覆盖三种任务模板,并不代表 24 种不同工作。主实验和升级实验共做了 16 组配对比较,并统一用 Holm 方法校正多重比较,校正后没有任何 p 值低于 0.05。下文的计数只描述本轮测试,不能据此确定模型的整体质量排名,也不能证明模型之间等效。
关闭推理后发生了什么?
GPT-6.1 Terra 在 none 下,8 道发票图像计算错了 5 道,8 道文本发票计算全部出错。同一轮推理强度测试中,low 的发票图像得分为 8/8,文本对照为 7/8;medium 两项均为 8/8。跨模型结果汇总在后面的三模型对比表中。
纯文本输入也出现错误,说明不能把所有失败都归因于图像识别。这 8 组配对输入也不足以证明图像格式更有优势。
下面这张发票能具体说明问题:
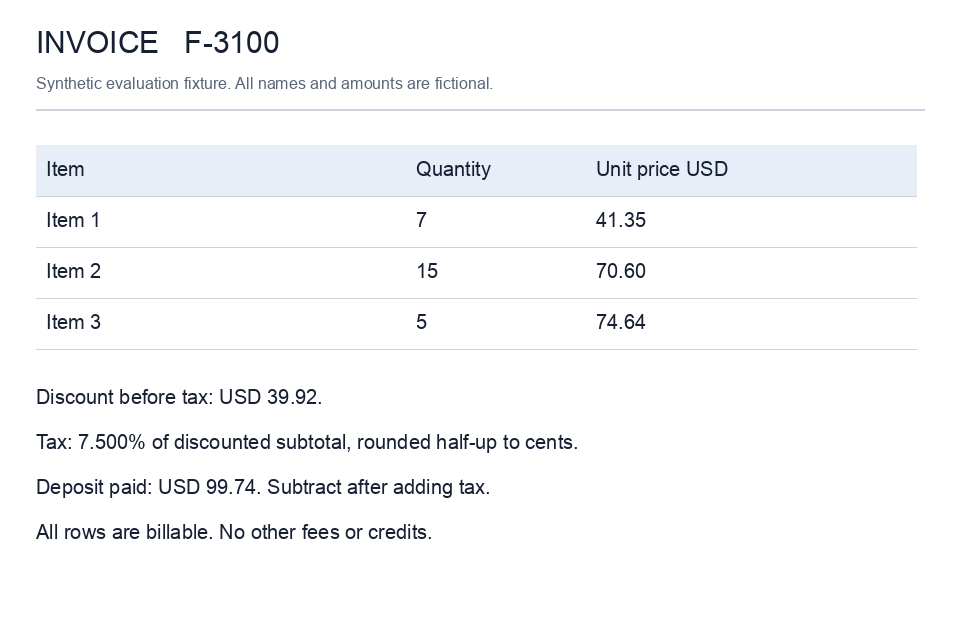
三个明细项分别为 7 × $41.35、15 × $70.60 和 5 × $74.64,小计为 $1,721.65。扣除 $39.92 折扣后,按 7.5% 计算税额并四舍五入,得到 $126.13;再扣除 $99.74 预付款,应付余额为 $1,708.12。
对于文本版,Terra low 返回的小计是 $1,711.65,税额是 $125.38,应付余额是 $1,697.37。JSON 符合 schema,但算术结果错误。提高推理强度是可以评估的一个变量;输出有类型约束,并不代表金额已经得到验证。
在最初的核心测试中,四种配置都通过了 8 道表格筛选任务和 8 道按钮选择任务。这两种模板在该轮测试中没有区分出质量差异;通过数量的差别来自发票计算错误。
三个模型在这些任务上表现如何?
GPT-5.6 Terra 和 GPT-6.1 Terra 均以 medium 比较;GPT-6.1 Sol 使用 low,用于实际的档位选择对比。我们在主要的档位建议中使用 Terra medium,因为它的文本发票成绩是 8/8,而 low 是 7/8;Sol 则使用已测试的 low。这里比较的是不同推理强度下的候选配置,不是相同推理强度下的质量。相差一道题,不能证明 medium 普遍更准确。
核心测试指最初的推理强度测试。升级测试指重新运行的新旧 Terra 对比。新 Terra 的两轮测量若有差异,表中会分别列出。升级建议使用升级测试数据,Terra 与 Sol 的选型建议使用核心测试数据。下文没有任何成本或延迟比值混用不同批次的数据。
| 指标 | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| 配置 | medium,升级测试 | medium,核心和升级测试 | low,核心测试 |
| 发票图像正确数 | 8/8 | 两轮均为 8/8 | 8/8 |
| 对应文本发票正确数 | 8/8 | 两轮均为 8/8 | 8/8 |
| 表格筛选正确数 | 8/8 | 两轮均为 8/8 | 8/8 |
| 截图任务完全正确数 | 2/8 | 两轮均为 8/8 | 8/8 |
| 全部图像任务正确数 | 18/24 | 两轮均为 24/24 | 24/24 |
| 24 张图像的成本 | $0.072094 | 核心:$0.028290;升级:$0.028269 | $0.055012 |
| 相同图像用量按每 1M token 输入 $1/输出 $5 计费 | $0.033500 | 核心:$0.028290;升级:$0.028269 | $0.027506 |
| 每个正确图像任务的成本 | $0.004005 | 核心:$0.001179;升级:$0.001178 | $0.002292 |
| 图像响应时间中位数 | 2.57 秒 | 核心:5.75 秒;升级:6.43 秒 | 4.51 秒 |
每个正确任务的成本等于总成本除以完全正确的响应数,其中包含错误回答的成本,但不模拟重试。我们按返回的用量和固定 Standard 费率计算,将推理 token 计入输出 token。独立的函数调用探测不计入其中。响应时间是经过网关的端到端耗时;服务基础设施未单独控制为固定条件。
旧 Terra 的六次失败都返回了正确按钮内部的坐标,但没有读取印在图上的控件 ID,而是编造了 cobalt-edit 之类的 ID。这些属于字段精确匹配错误。在升级测试中,两代模型都在 medium 下正确完成了全部发票计算。
在核心推理强度测试中,新 Terra none 处理 24 张图像花费 $0.024275,答对 19/24;low 花费 $0.027835,答对 24/24。因此,观测到的每个正确图像任务成本,none 为 $0.001278,low 为 $0.001160。在这组任务上,none 虽然总支出更低,但每个成功结果的成本并没有更低。
是否应该从 GPT-5.6 Terra 升级到 GPT-6.1 Terra?
如果你关注推理成本或视觉字段的精确提取,值得评估从 GPT-5.6 Terra 升级到 GPT-6.1 Terra。在同条件的 medium 测试中,图像任务成本降低 60.8%,完全正确数从 18/24 提升到 24/24。结果发生变化的六道题都涉及图中印出的控件 ID;经过统计校正,这个样本不足以证明新模型整体质量更高。
旧模型的当前费率为每百万 token 输入 $2、输出 $12。新 Terra 的两项价格分别降低 50% 和 58.3%。即使统一按 $1/$5 计费,它的图像任务用量成本仍低 15.6%。输入量接近,分别为 20,765 和 20,789 token;输出量则从 2,547 降至 1,496 token。
对于带校验的内部文档处理或字段提取,先用现有推理强度测试新模型,切换前核对精确 ID 和金额。对于延迟敏感的交互,在新模型达到应用的响应时间目标前,应保留旧模型作为对照:本轮测试中,旧模型的图像延迟中位数为 2.57 秒,新模型为 6.43 秒。对于可能触发付款的发票,无论使用哪一代,都要保留确定性计算和审批检查。
应该选择 GPT-6.1 Terra 还是 GPT-6.1 Sol?
对于这些边界明确的视觉任务,GPT-6.1 Terra medium 是更便宜的候选方案;如果更看重响应时间,或工作更复杂,则应保留 GPT-6.1 Sol low 作为对照。核心测试中,两者都正确完成了 24/24 道图像任务,成本分别为 $0.028290 和 $0.055012。观测到的 48.6% 成本降幅,完全可以由 Terra 低 50% 的输入/输出单价解释:将 Sol 的用量按 $1/$5 重新计价,结果为 $0.027506,略低于 Terra 的 $0.028290。
对于带校验的批量提取,先用本地样本评估 Terra,并比较错误类型。对于交互式工作流,应根据产品实际的延迟目标,对比 Sol 观测到的 4.51 秒中位数和 Terra 的 5.75 秒。复杂编程和开放式智能体项目需要使用这三种模板之外的代表性任务评估;OpenAI 的模型选择指南将 Sol 定位于复杂工作。这里的通过数量相同,不代表两者整体能力等效。
如何在 API 中设置推理强度?
使用 GPT-6.1 Terra 时,显式设置 reasoning.effort,并同时检查答案和返回的用量。GPT-6 指南列出的默认值为 medium,并要求工具调用使用 Responses。推理 token 会占用输出额度,费用已包含在输出 token 中,不会再额外计费一次。
下面的 Python 示例展示生产环境中的提取模式,并不是复现计算基准测试。安装 openai,设置 OPENAI_API_KEY,并将上图发票保存为 invoice.png。让模型提取明细项和文档上写明的规则,缺失字段保留为 null。这里支持的规则是先扣折扣再计税,按四舍五入精确到分,最后扣除预付款。
import base64
import json
from pathlib import Path
from openai import OpenAI

client = OpenAI(max_retries=0)
encoded = base64.b64encode(Path("invoice.png").read_bytes()).decode()
nullable_int = {"type": ["integer", "null"]}
rule = "discount_then_tax_half_up_then_deposit"
item_fields = {"quantity": nullable_int, "unit_price_cents": nullable_int}
properties = {
    "currency": {"type": ["string", "null"]},
    "items": {"type": "array", "items": {
        "type": "object", "properties": item_fields,
        "required": list(item_fields), "additionalProperties": False,
    }},
    "discount_cents": nullable_int,
    "tax_rate": {"type": ["string", "null"]},
    "deposit_cents": nullable_int,
    "calculation_rule": {"type": ["string", "null"],
                         "enum": [rule, "other", None]},
}
response = client.responses.create(
    model="gpt-6.1-terra",
    reasoning={"effort": "medium"},
    max_output_tokens=4096,
    store=False,
    input=[{"role": "user", "content": [
        {"type": "input_text", "text": (
            "Extract the printed invoice fields, not calculated totals. "
            "Use integer cents for prices, discount, and deposit, and an "
            "ISO currency code. Express the tax rate as a decimal string "
            "(7.5% becomes 0.075). Use null for missing or ambiguous fields. "
            f"Set calculation_rule to {rule} only when the printed rules "
            "explicitly match; use other for a different rule and null "
            "if unclear. Do not invent rules or default amounts to zero."
        )},
        {"type": "input_image", "detail": "high",
         "image_url": "data:image/png;base64," + encoded},
    ]}],
    text={"format": {
        "type": "json_schema", "name": "invoice_fields", "strict": True,
        "schema": {"type": "object", "properties": properties,
                   "required": list(properties), "additionalProperties": False},
    }},
)
if response.status != "completed":
    raise RuntimeError(f"Incomplete response: {response.status}")
if not response.output_text:
    raise RuntimeError("No invoice JSON returned; inspect refusal/error output")
extracted = json.loads(response.output_text)
print(extracted)
usage = response.usage
if usage is not None:
    reasoning = getattr(usage.output_tokens_details, "reasoning_tokens", None)
    print({"input_tokens": usage.input_tokens,
           "output_tokens": usage.output_tokens,
           "reasoning_tokens": reasoning})
我们还对最初核心测试的四种配置做了独立的本地函数调用探测:新 Terra 的 none/low/medium,以及 GPT-6.1 Sol 的 low。流程是选择截图控件、读取实际存储的选择,再返回已验证的结果。四种配置都正确完成了强制执行的三轮流程,共 12 轮 API 调用。函数结果使用匹配的调用 ID,并回传了输出项。这只是本地兼容性探测,不是自主桌面操作基准测试。
生产环境应该如何校验发票金额?
对于发票入账和付款,应提取带类型约束的运算数据,再用确定性代码计算合计。无论哪个模型在成本或延迟上胜出,都要校验源字段,并在资金划转前要求审批。
在提取示例后运行下面的代码。它会拒绝缺失或不受支持的输入,并计算图中发票的合计。用整数分币避免二进制浮点误差;用 Decimal 执行指定的税额舍入规则。
from decimal import Decimal, InvalidOperation, ROUND_HALF_UP


def invoice_totals(data):
    if data.get("currency") != "USD" or data.get("calculation_rule") != rule:
        raise ValueError("Missing or unsupported currency/calculation rule")
    items = data.get("items")
    if not isinstance(items, list) or not items:
        raise ValueError("Missing line items")
    for item in items:
        if (not isinstance(item, dict)
                or type(item.get("quantity")) is not int
                or item["quantity"] <= 0
                or type(item.get("unit_price_cents")) is not int
                or item["unit_price_cents"] < 0):
            raise ValueError("Invalid or missing line-item values")
    for key in ("discount_cents", "deposit_cents"):
        if type(data.get(key)) is not int or data[key] < 0:
            raise ValueError(f"Invalid or missing {key}")
    if not isinstance(data.get("tax_rate"), str):
        raise ValueError("Missing tax rate")
    try:
        rate = Decimal(data["tax_rate"])
    except InvalidOperation as exc:
        raise ValueError("Invalid tax rate") from exc
    if not rate.is_finite() or not Decimal(0) <= rate <= Decimal(1):
        raise ValueError("Unsupported tax rate")
    subtotal = sum(i["quantity"] * i["unit_price_cents"] for i in items)
    taxable = subtotal - data["discount_cents"]
    if taxable < 0:
        raise ValueError("Discount exceeds subtotal")
    tax = int((Decimal(taxable) * rate).quantize(
        Decimal("1"), rounding=ROUND_HALF_UP
    ))
    return {"subtotal_cents": subtotal, "tax_cents": tax,
            "balance_due_cents": taxable + tax - data["deposit_cents"]}


calculated = invoice_totals(extracted)
print({"source_fields": extracted, "calculated_totals": calculated})
这份输出可以进入复核流程,但不能直接自动入账。类型和规则检查无法证明价格读取正确:批准付款前,必须将提取字段与原文核对,并复核有歧义的条款。提取示例只是实现模式;我们测量的 192 次调用测试的是前文所述的计算提示词。
相关测量可参阅图像输入计费指南、不同 PDF 表示方式的成本测试和同价模型对比。
常见问题
值得从 GPT-5.6 Terra 升级到 GPT-6.1 Terra 吗?
在我们的同条件测试中,medium 下 GPT-6.1 Terra 的图像任务成本比 GPT-5.6 Terra 低 60.8%;若两者统一按每百万 token 输入 $1/输出 $5 计价,则低 15.6%。两者都通过了全部发票计算;旧模型错了六个图中印出的控件 ID。新模型观测到的延迟中位数更长,因此升级决策也必须验证响应时间。
应该选择 GPT-6.1 Terra 还是 GPT-6.1 Sol?
处理 24 道图像任务,GPT-6.1 Terra medium 花费 $0.028290,GPT-6.1 Sol low 花费 $0.055012,核心测试中两者均为 24/24。带校验的批处理可以评估 Terra,交互式工作则应对比 Sol:两者响应时间中位数分别为 5.75 秒和 4.51 秒。这些合成任务不能证明两者整体质量等效。
处理发票时可以关闭推理吗?
在核心测试中,GPT-6.1 Terra none 只正确完成了 3/8 道发票图像计算,对应文本计算为 0/8。精确金额计算应放在代码中,并校验提取出的运算数据。对于边界明确的表格或按钮选择任务,none 在这里通过了 16/16,可以针对具体工作负载进一步评估。