
GPT-6.1 Terra vs GPT-5.6 Terra·Sol: API 호출 192회 비교
목차
- OpenAI 모델 제품군에서 GPT-6.1 Terra의 위치
- 공식 벤치마크 결과
- 추론 설정 테스트 방법
- 추론을 끄면 어떤 결과가 나왔나
- 같은 작업에서 세 모델은 어떻게 달랐나
- GPT-5.6 Terra에서 GPT-6.1 Terra로 업그레이드해야 하나
- GPT-6.1 Terra와 GPT-6.1 Sol 중 무엇을 선택해야 하나
- API에서 추론 강도를 설정하는 방법
- 운영 환경에서 청구서 금액을 검증하는 방법
- 자주 묻는 질문
- GPT-5.6 Terra에서 GPT-6.1 Terra로 업그레이드할 만한가요?
- GPT-6.1 Terra와 GPT-6.1 Sol 중 무엇을 선택해야 하나요?
- 청구서 처리에서 추론을 꺼도 되나요?
GPT-6.1 Terra는 시각 작업을 위한 OpenAI의 저비용 모델입니다. 입력 100만 token당 $1, 출력 100만 token당 $5로, GPT-6.1 Sol 요금의 절반입니다. 추론 강도는 답변 전에 수행하는 내부 추론의 양을 제어합니다. none은 추론을 끄며, 다른 설정에서는 추론 token이 출력에 포함되어 과금됩니다. 테스트에서 추론을 껐을 때 표와 버튼 선택 작업 16개는 모두 통과했지만, 청구서 이미지 계산은 3/8, 동일한 내용의 텍스트 계산은 0/8만 통과했습니다.
TL;DR
- 합성 데이터 테스트에서 GPT-6.1 Terra
none은 표와 스크린샷 작업 16/16을 통과했지만, 청구서 이미지 계산은 3/8만 통과했습니다. - GPT-6.1 Terra
low는 이미지 작업 24/24와 동일한 내용의 텍스트 청구서 작업 7/8을 통과했습니다.medium은 각각 24/24와 8/8을 통과했습니다. - 이미지 24개의 처리 비용은 GPT-6.1 Terra
medium이 $0.028290, GPT-6.1 Sollow가 $0.055012였습니다. - 조건을 맞춘 별도 실행에서 이미지 24개의 처리 비용은 GPT-6.1 Terra
medium이 $0.028269, GPT-5.6 Terra가 $0.072094였습니다.
OpenAI 모델 제품군에서 GPT-6.1 Terra의 위치
GPT-6.1 Terra는 GPT-6.1 Sol보다 낮은 가격으로 시각적 추론, 화면 기반 조작, 간결한 글쓰기를 처리하도록 설계되었습니다. OpenAI는 2026년 10월 26일 Terra를 출시했습니다. 모델 선택 가이드에서는 화면 작업이나 범위가 명확한 코드 수정처럼 결과를 검증할 수 있고 작업이 명확히 정의된 용도에 Terra를 권장합니다. 복잡한 프로젝트에는 여전히 범용성이 더 높은 Sol이 적합합니다.
GPT-5.6 Terra는 업그레이드 여부를 판단하기 위한 이전 세대 기준 모델입니다. Sol은 현재 모델 등급을 선택할 때 비교할 고가 대안입니다. 세 모델을 비교하면 이 두 가지 결정을 내리는 데 도움이 됩니다.
| 사양 | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| 비교에서의 역할 | 이전 세대 기준 모델 | 새로운 시각 작업용 모델 | 복잡한 작업을 위한 고가 대안 |
| 1M token당 표준 입력 요금 | $2 | $1 | $2 |
| 1M token당 표준 출력 요금 | $12 | $5 | $10 |
| 1M token당 캐시 입력 읽기 요금 | $0.20 | $0.05 | $0.10 |
| 컨텍스트 윈도우 | 1,050,000 token | 1,050,000 token | 1,050,000 token |
| 최대 출력 | 128,000 token | 128,000 token | 128,000 token |
| 추론 설정 | none, low, medium, high, xhigh, max | none, low, medium, high, xhigh, max | low, medium, high, xhigh, max |
| 기본 추론 설정 | medium | medium | medium |
| 입력 / 출력 형식 | 텍스트 및 이미지 / 텍스트 | 텍스트 및 이미지 / 텍스트 | 텍스트 및 이미지 / 텍스트 |
| 테스트에 사용한 엔드포인트 | Responses API | Responses API | Responses API |
출처: 공식 GPT-5.6 Terra 레퍼런스, GPT-6.1 Terra 레퍼런스, Sol 레퍼런스, 릴리스 변경 이력. 위 요금은 입력이 272,000 token 이하인 Standard 요청에 적용됩니다. 이 한도를 넘으면 요청 전체에 대해 캐시되지 않은 입력 요금은 2배, 출력 요금은 50% 인상됩니다. 캐시 쓰기 요금은 별도입니다. 본 측정의 주 실험 요청에서는 캐시 읽기나 쓰기 사용량이 보고되지 않았습니다.
새 Terra는 이전 세대의 컨텍스트 크기, 출력 한도, 추론 설정 이름을 그대로 유지합니다. 공시 입력 요금은 50%, 출력 요금은 58.3% 낮아졌습니다. 뒤에서 다룰 동일 조건 업그레이드 테스트에서는 이 요금 인하 효과를 token 사용량과 정답률 변화에서 분리해 살펴봅니다.
공식 벤치마크 결과
OpenAI는 출시 발표에서 GPT-6.1 Terra를 GPT-5.6 Terra, GPT-6.1 Sol과 비교했습니다. 발표문에 실제로 공개된 내용은 다음과 같습니다.
| 평가 | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| Agents’ Last Exam: 전문 시각 작업 | 기준 모델, 절대 점수 미공개 | medium에서 이전 세대보다 15%포인트 높음, 작업 비용은 약 3분의 1 | 절대 점수 미공개 |
| MMMU-Pro: 시각적 추론 | 공개된 모든 설정에서 새 Terra보다 낮음, 점수 미공개 | Sol에 근접, 점수 미공개 | 새 Terra가 거의 따라잡았다고 설명, 점수 미공개 |
| Terminal-Bench 4.0: 터미널 코딩 작업 | 공개 점수 21.5%, 추론 강도 미명시 | max에서 50.3% | 점수 미공개 |
| 내부 사실성 테스트: 오류율이 낮을수록 좋음 | low에서 오류율 53.6% | low에서 오류율 16.7% | low 오류율 미공개 |
출처: OpenAI 출시 평가. 빠진 점수는 공개되지 않은 값이며, 사실성 평가는 내부 테스트입니다. 아래 API 테스트에서는 동일한 합성 작업을 사용해 업그레이드와 모델 등급 선택을 검토합니다.
추론 설정 테스트 방법
GPT-6.1 Terra의 none, low, medium과 GPT-6.1 Sol의 low를 비교했습니다. 각 설정에는 이미지 24개와 같은 내용을 담은 텍스트 대조군 8개, 총 32개 입력을 사용했습니다. 주 실험 호출은 총 128회입니다. 별도의 업그레이드 비교에서는 같은 입력 32개에 대해 GPT-5.6 Terra와 GPT-6.1 Terra를 모두 medium으로 설정하고 번갈아 새 응답을 받았습니다. 이 64회를 더해 총 192회를 호출했습니다. 업그레이드 표에는 이 별도 배치의 결과만 사용합니다.
| 작업 유형 | 설정별 입력 수 | 요구 결과 |
|---|---|---|
| 청구서 이미지 | 8 | 항목별 수량과 단가를 곱하고, 할인을 차감한 뒤 세금을 계산해 반올림하고 선입금을 차감 |
| 조건부 표 집계 | 8 | 지정된 지역과 분기에 해당하는 값을 집계한 뒤 반품률 계산 |
| 애플리케이션 스크린샷 | 8 | 비슷한 카드들 중 올바른 컨트롤 ID와 해당 버튼 내부의 좌표 식별 |
| 청구서 텍스트 대조군 | 8 | 정확히 옮긴 텍스트에서 동일한 청구서 금액 계산 |
정답을 알고 있는 가상 문서를 생성했으며, 3가지 템플릿에서 값이나 배치를 바꿨습니다. 모든 이미지는 960 × 640 픽셀이며 detail: "high"로 전송했습니다. 청구서의 이미지 버전과 텍스트 버전에는 동일한 작업 지시, 스키마, 업무 규칙을 사용했습니다. 각 입력에 대해 설정별로 응답을 한 번씩 받았습니다.
실험은 2026년 10월 29일 Synthorai를 통한 스트리밍 Responses 요청으로 진행했습니다. 출력 한도는 모두 4,096 token으로 맞추고 설정을 번갈아 실행했습니다. 주 실험의 응답 128개는 모두 완료되었고 스키마에 맞는 JSON을 반환했습니다. 요청한 값이 전부 일치해야 정답으로 판정했으며, 스크린샷 좌표는 올바른 버튼 안에 있어야 했습니다. 모델 평가자 없이 정수 센트와 십진수 반올림을 사용하는 코드로 채점했습니다.
이미지 24개는 서로 다른 24가지 업무가 아니라 3가지 작업 템플릿을 나타냅니다. 주 실험과 업그레이드 실험의 대응 비교 16개에 대해 다중 비교를 고려한 Holm 보정을 함께 적용했으며, 보정 p값이 0.05 미만인 비교는 없었습니다. 아래 수치는 이번 실행의 결과일 뿐, 모델의 전반적인 품질 순위나 동등성을 입증하지 않습니다.
추론을 끄면 어떤 결과가 나왔나
GPT-6.1 Terra의 none은 청구서 이미지 계산 8개 중 5개, 텍스트 청구서 계산 8개 전부를 틀렸습니다. 같은 추론 강도 비교에서 low는 청구서 이미지 8/8, 텍스트 대조군 7/8을 맞혔고, medium은 둘 다 8/8을 맞혔습니다. 모델 간 결과는 아래의 3개 모델 비교 표에 정리했습니다.
텍스트만 제공한 입력에서도 오류가 발생했으므로 모든 실패를 이미지 판독 문제로 설명할 수는 없습니다. 대응 입력 8쌍만으로 이미지 형식이 더 유리하다고 결론 내릴 수도 없습니다.
다음 청구서에서 오류를 구체적으로 볼 수 있습니다.
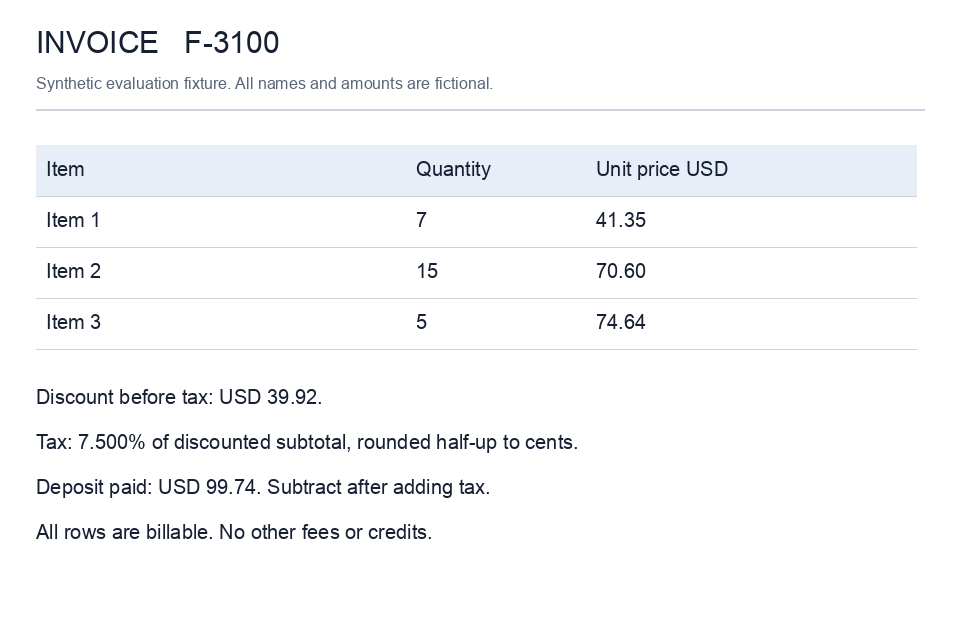
항목별 금액은 7 × $41.35, 15 × $70.60, 5 × $74.64입니다. 소계는 $1,721.65입니다. 할인 $39.92를 차감한 뒤 7.5% 세율을 적용하고 사사오입하면 세금은 $126.13입니다. 여기서 선입금 $99.74를 빼면 최종 납부액은 $1,708.12입니다.
텍스트 버전에서 Terra low는 소계 $1,711.65, 세금 $125.38, 납부액 $1,697.37을 반환했습니다. JSON은 스키마에 맞았지만 계산은 틀렸습니다. 추론 강도를 높이는 것은 검토할 변수 중 하나입니다. 타입이 지정된 출력만으로 금액이 맞다고 검증되지는 않습니다.
최초 핵심 실험에서는 네 설정 모두 조건부 표 집계 8개와 버튼 선택 8개를 통과했습니다. 이 실험에서 두 템플릿은 품질 차이를 드러내지 못했습니다. 정답 수 차이는 청구서 오류에서 발생했습니다.
같은 작업에서 세 모델은 어떻게 달랐나
GPT-5.6 Terra와 GPT-6.1 Terra는 medium으로 비교했고, 실용적인 모델 등급 비교를 위해 GPT-6.1 Sol은 low를 사용했습니다. Terra의 주 권장 설정을 medium으로 잡은 이유는 텍스트 청구서 결과가 low의 7/8과 달리 8/8이었기 때문입니다. Sol에는 테스트한 low 설정을 사용합니다. 이는 추론 강도가 서로 다른 후보 설정의 비교이지, 같은 추론 강도에서의 품질 비교가 아닙니다. 작업 1개 차이만으로 medium이 일반적으로 더 정확하다고 볼 수는 없습니다.
핵심 실험은 최초 추론 강도 비교입니다. 업그레이드 실험은 이전 Terra와 새 Terra를 새로 비교한 실행입니다. 새 Terra는 측정값이 다를 경우 각 실행의 값을 모두 표기했습니다. 업그레이드 권고에는 업그레이드 실험 값을, Terra와 Sol 간 권고에는 핵심 실험 값을 사용합니다. 아래 비용과 지연 시간 비율은 서로 다른 배치의 값을 섞어 계산하지 않았습니다.
| 측정 항목 | GPT-5.6 Terra | GPT-6.1 Terra | GPT-6.1 Sol |
|---|---|---|---|
| 설정 | medium, 업그레이드 실험 | medium, 핵심 및 업그레이드 실험 | low, 핵심 실험 |
| 청구서 이미지 정답 | 8/8 | 두 실험 모두 8/8 | 8/8 |
| 동일 내용 텍스트 청구서 정답 | 8/8 | 두 실험 모두 8/8 | 8/8 |
| 조건부 표 집계 정답 | 8/8 | 두 실험 모두 8/8 | 8/8 |
| 스크린샷 작업 완전 정답 | 2/8 | 두 실험 모두 8/8 | 8/8 |
| 전체 이미지 작업 정답 | 18/24 | 두 실험 모두 24/24 | 24/24 |
| 이미지 24개 비용 | $0.072094 | 핵심: $0.028290; 업그레이드: $0.028269 | $0.055012 |
| 같은 이미지 사용량에 1M token당 입력 $1 / 출력 $5 적용 | $0.033500 | 핵심: $0.028290; 업그레이드: $0.028269 | $0.027506 |
| 이미지 정답 1건당 비용 | $0.004005 | 핵심: $0.001179; 업그레이드: $0.001178 | $0.002292 |
| 이미지 응답 시간 중앙값 | 2.57초 | 핵심: 5.75초; 업그레이드: 6.43초 | 4.51초 |
정답 1건당 비용은 총비용을 완전히 맞힌 응답 수로 나눈 값입니다. 오답 비용도 포함하며 재시도는 시뮬레이션하지 않았습니다. 반환된 사용량에 고정 Standard 요금을 적용했고, 추론 token은 출력 token에 포함했습니다. 별도의 함수 호출 확인 실험은 제외했습니다. 응답 시간은 게이트웨이를 거친 전체 구간 기준이며, 서빙 인프라를 별도로 동일하게 고정하지는 않았습니다.
이전 Terra가 실패한 6건은 모두 올바른 버튼 내부 좌표를 반환했지만, 화면에 표시된 컨트롤 ID를 읽는 대신 cobalt-edit 같은 ID를 만들어 냈습니다. 정확한 필드값을 맞히지 못한 오류입니다. 업그레이드 실험의 medium에서는 두 세대 모두 청구서 계산을 전부 맞혔습니다.
핵심 추론 강도 실험에서 새 Terra none은 이미지 24개에 $0.024275를 사용해 19/24를 맞혔고, low는 $0.027835로 24/24를 맞혔습니다. 관측된 이미지 정답 1건당 비용은 none이 $0.001278, low가 $0.001160입니다. 이 데이터셋에서는 none의 총지출이 더 적었지만 성공 결과 1건당 비용까지 더 낮지는 않았습니다.
GPT-5.6 Terra에서 GPT-6.1 Terra로 업그레이드해야 하나
추론 비용이나 시각 정보의 정확한 필드 추출이 중요하다면 GPT-5.6 Terra에서 GPT-6.1 Terra로 업그레이드할지 평가해 볼 만합니다. 조건을 맞춘 medium 실행에서 이미지 작업 비용은 60.8% 줄었고, 완전 정답 수는 18/24에서 24/24로 늘었습니다. 결과가 달라진 6건은 화면에 표시된 컨트롤 ID에 관한 것입니다. 통계 보정을 적용하면 이 표본만으로 전반적인 품질 우위를 입증할 수는 없습니다.
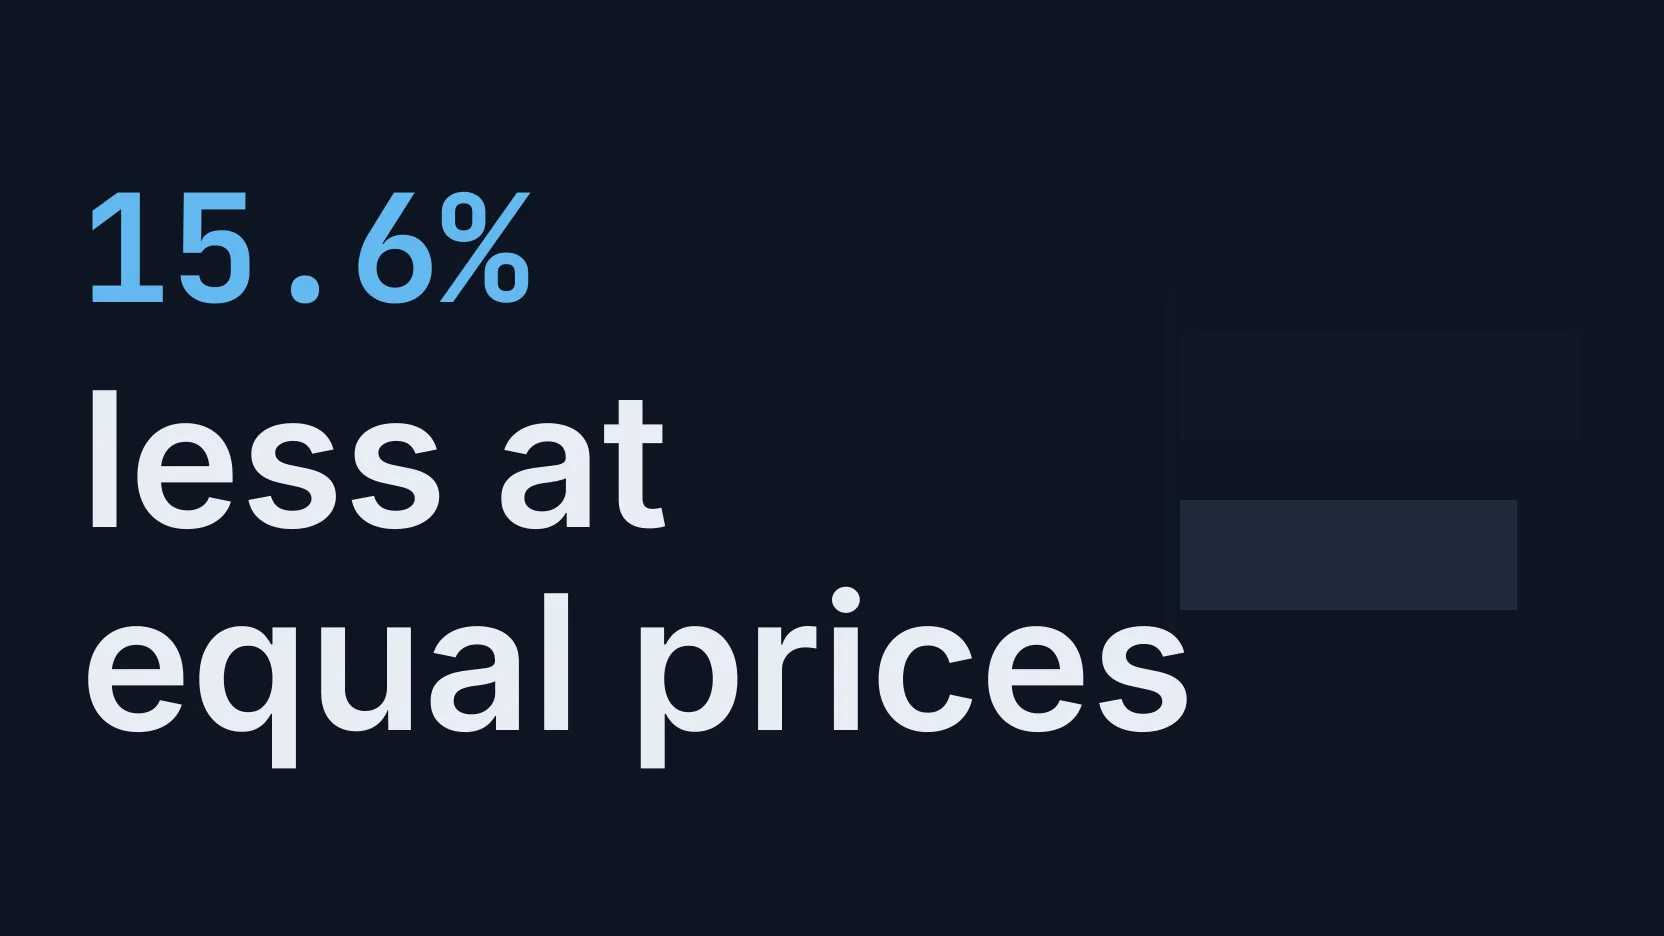
이전 모델의 현재 요금은 100만 token당 입력 $2, 출력 $12입니다. 새 Terra는 각각 50%, 58.3% 낮습니다. 동일한 $1/$5 요금을 적용해도 새 모델의 이미지 작업 사용량에 따른 비용은 15.6% 적습니다. 입력은 20,765 token과 20,789 token으로 비슷했지만, 출력은 2,547 token에서 1,496 token으로 줄었습니다.
내부 문서 처리나 검증 절차가 있는 필드 추출에서는 기존 추론 강도로 새 모델을 테스트하고, 전환 전에 ID와 금액이 정확한지 확인하세요. 지연 시간에 민감한 상호작용에서는 새 모델이 애플리케이션의 응답 시간 목표를 충족할 때까지 이전 모델을 비교 대상으로 유지하세요. 이번 실행에서 이미지 지연 시간 중앙값은 이전 모델이 2.57초, 새 모델이 6.43초였습니다. 지급으로 이어질 수 있는 청구서는 어느 세대를 쓰든 결정적 계산 코드와 승인 검사를 유지해야 합니다.
GPT-6.1 Terra와 GPT-6.1 Sol 중 무엇을 선택해야 하나
범위가 명확한 이 시각 작업들에서는 GPT-6.1 Terra medium이 더 저렴한 후보입니다. 응답 시간이나 더 복잡한 작업이 중요하다면 GPT-6.1 Sol low를 비교 대상으로 유지할 만합니다. 핵심 실험에서는 둘 다 이미지 24/24를 맞혔으며 비용은 각각 $0.028290, $0.055012였습니다. 관측된 48.6% 절감은 Terra의 입력·출력 요금이 50% 낮다는 점으로 설명됩니다. Sol 사용량에 $1/$5 요금을 적용하면 $0.027506으로, Terra의 $0.028290보다 조금 낮습니다.
검증 절차가 있는 배치 추출에서는 실제 업무 예제로 Terra를 먼저 평가하고 오류 유형을 비교하세요. 대화형 작업에서는 Sol의 관측 중앙값 4.51초와 Terra의 5.75초를 제품의 실제 지연 시간 목표에 맞춰 비교하세요. 복잡한 코딩과 범위가 정해지지 않은 에이전트 프로젝트는 이 3가지 템플릿을 넘어서는 대표성 있는 평가가 필요합니다. OpenAI의 모델 선택 가이드도 복잡한 작업에는 Sol을 권장합니다. 여기서 정답 수가 같았다는 사실이 전반적인 동등성을 뜻하지는 않습니다.
API에서 추론 강도를 설정하는 방법
GPT-6.1 Terra에서는 reasoning.effort를 명시적으로 설정하고 답변과 반환된 사용량을 함께 확인하세요. GPT-6 가이드는 기본값을 medium으로 명시하며, 도구 호출에는 Responses를 사용하도록 요구합니다. 추론 token은 출력 한도를 소비하고 출력 token에 포함되어 과금됩니다. 별도로 한 번 더 더해지는 것은 아닙니다.
다음 Python 예제는 계산 벤치마크를 재현하는 코드가 아니라 운영 환경의 추출 패턴을 보여줍니다. openai를 설치하고 OPENAI_API_KEY를 설정한 뒤 위 청구서 이미지를 invoice.png로 저장하세요. 항목과 문서에 적힌 규칙을 요청하고, 없는 필드는 null로 남깁니다. 이 예제가 지원하는 규칙은 세전 할인 차감, 센트 단위 사사오입, 세후 선입금 차감입니다.
import base64
import json
from pathlib import Path
from openai import OpenAI

client = OpenAI(max_retries=0)
encoded = base64.b64encode(Path("invoice.png").read_bytes()).decode()
nullable_int = {"type": ["integer", "null"]}
rule = "discount_then_tax_half_up_then_deposit"
item_fields = {"quantity": nullable_int, "unit_price_cents": nullable_int}
properties = {
    "currency": {"type": ["string", "null"]},
    "items": {"type": "array", "items": {
        "type": "object", "properties": item_fields,
        "required": list(item_fields), "additionalProperties": False,
    }},
    "discount_cents": nullable_int,
    "tax_rate": {"type": ["string", "null"]},
    "deposit_cents": nullable_int,
    "calculation_rule": {"type": ["string", "null"],
                         "enum": [rule, "other", None]},
}
response = client.responses.create(
    model="gpt-6.1-terra",
    reasoning={"effort": "medium"},
    max_output_tokens=4096,
    store=False,
    input=[{"role": "user", "content": [
        {"type": "input_text", "text": (
            "Extract the printed invoice fields, not calculated totals. "
            "Use integer cents for prices, discount, and deposit, and an "
            "ISO currency code. Express the tax rate as a decimal string "
            "(7.5% becomes 0.075). Use null for missing or ambiguous fields. "
            f"Set calculation_rule to {rule} only when the printed rules "
            "explicitly match; use other for a different rule and null "
            "if unclear. Do not invent rules or default amounts to zero."
        )},
        {"type": "input_image", "detail": "high",
         "image_url": "data:image/png;base64," + encoded},
    ]}],
    text={"format": {
        "type": "json_schema", "name": "invoice_fields", "strict": True,
        "schema": {"type": "object", "properties": properties,
                   "required": list(properties), "additionalProperties": False},
    }},
)
if response.status != "completed":
    raise RuntimeError(f"Incomplete response: {response.status}")
if not response.output_text:
    raise RuntimeError("No invoice JSON returned; inspect refusal/error output")
extracted = json.loads(response.output_text)
print(extracted)
usage = response.usage
if usage is not None:
    reasoning = getattr(usage.output_tokens_details, "reasoning_tokens", None)
    print({"input_tokens": usage.input_tokens,
           "output_tokens": usage.output_tokens,
           "reasoning_tokens": reasoning})
최초 핵심 실험의 네 설정, 즉 새 Terra의 none/low/medium과 GPT-6.1 Sol의 low에 대해서는 별도의 로컬 함수 호출 확인도 진행했습니다. 스크린샷 컨트롤을 선택하고, 실제로 저장된 선택값을 읽은 뒤, 검증된 결과를 반환하는 절차입니다. 네 설정 모두 강제로 지정한 3턴 순서를 정확히 완료했으며 총 API 턴 수는 12회였습니다. 함수 결과에는 일치하는 호출 ID를 사용하고 출력 항목을 다시 전달했습니다. 이는 로컬 호환성 확인이지, 자율 데스크톱 작업 벤치마크가 아닙니다.
운영 환경에서 청구서 금액을 검증하는 방법
청구서 전표 처리와 지급에서는 타입이 지정된 계산 입력값을 추출하고, 결정적 코드로 합계를 계산하세요. 비용이나 지연 시간 비교에서 어느 모델이 유리하든 원본 필드를 검증하고 자금 이동 전에 승인을 받아야 합니다.
추출 예제 뒤에 다음 코드를 실행하세요. 누락되었거나 지원하지 않는 입력을 거부하고 위 청구서의 합계를 계산합니다. 정수 센트를 사용하면 이진 부동소수점 오류를 피할 수 있고, Decimal로 명시된 세금 반올림 규칙을 적용할 수 있습니다.
from decimal import Decimal, InvalidOperation, ROUND_HALF_UP


def invoice_totals(data):
    if data.get("currency") != "USD" or data.get("calculation_rule") != rule:
        raise ValueError("Missing or unsupported currency/calculation rule")
    items = data.get("items")
    if not isinstance(items, list) or not items:
        raise ValueError("Missing line items")
    for item in items:
        if (not isinstance(item, dict)
                or type(item.get("quantity")) is not int
                or item["quantity"] <= 0
                or type(item.get("unit_price_cents")) is not int
                or item["unit_price_cents"] < 0):
            raise ValueError("Invalid or missing line-item values")
    for key in ("discount_cents", "deposit_cents"):
        if type(data.get(key)) is not int or data[key] < 0:
            raise ValueError(f"Invalid or missing {key}")
    if not isinstance(data.get("tax_rate"), str):
        raise ValueError("Missing tax rate")
    try:
        rate = Decimal(data["tax_rate"])
    except InvalidOperation as exc:
        raise ValueError("Invalid tax rate") from exc
    if not rate.is_finite() or not Decimal(0) <= rate <= Decimal(1):
        raise ValueError("Unsupported tax rate")
    subtotal = sum(i["quantity"] * i["unit_price_cents"] for i in items)
    taxable = subtotal - data["discount_cents"]
    if taxable < 0:
        raise ValueError("Discount exceeds subtotal")
    tax = int((Decimal(taxable) * rate).quantize(
        Decimal("1"), rounding=ROUND_HALF_UP
    ))
    return {"subtotal_cents": subtotal, "tax_cents": tax,
            "balance_due_cents": taxable + tax - data["deposit_cents"]}


calculated = invoice_totals(extracted)
print({"source_fields": extracted, "calculated_totals": calculated})
이 출력은 검토용이지 자동 전표 처리용이 아닙니다. 타입과 규칙 검사만으로 가격을 정확히 읽었는지는 알 수 없습니다. 지급 승인 전에 추출 필드를 원본과 대조하고 모호한 조건을 검토하세요. 추출 예제는 구현 패턴이며, 측정한 192회 호출은 앞서 설명한 계산 프롬프트를 테스트한 것입니다.
관련 측정은 이미지 입력 과금 가이드, PDF 표현 방식별 비용 테스트, 동일 가격 모델 비교에서 확인할 수 있습니다.
자주 묻는 질문
GPT-5.6 Terra에서 GPT-6.1 Terra로 업그레이드할 만한가요?
조건을 맞춘 medium 실행에서 GPT-6.1 Terra의 이미지 작업 비용은 GPT-5.6 Terra보다 60.8% 낮았습니다. 두 모델 모두 100만 token당 입력 $1 / 출력 $5를 적용하면 차이는 15.6%입니다. 청구서 계산은 두 모델 모두 전부 통과했지만 이전 모델은 화면에 표시된 컨트롤 ID 6개를 틀렸습니다. 새 모델의 관측 지연 시간 중앙값이 더 길었으므로 업그레이드 결정에는 응답 시간 검증도 포함해야 합니다.
GPT-6.1 Terra와 GPT-6.1 Sol 중 무엇을 선택해야 하나요?
핵심 실험에서 이미지 작업 24개의 비용은 GPT-6.1 Terra medium이 $0.028290, GPT-6.1 Sol low가 $0.055012였으며 둘 다 24/24를 맞혔습니다. 검증 절차가 있는 배치 작업에는 Terra를 평가하고, 대화형 작업에는 Sol을 비교하세요. 응답 시간 중앙값은 각각 5.75초와 4.51초였습니다. 이 합성 작업만으로 전반적인 품질이 동등하다고 볼 수는 없습니다.
청구서 처리에서 추론을 꺼도 되나요?
핵심 실험에서 GPT-6.1 Terra none은 청구서 이미지 3/8, 동일 내용의 텍스트 계산 0/8만 맞혔습니다. 정확한 금액 계산은 코드로 처리하고 추출한 계산 입력값을 검증하세요. 범위가 명확한 표나 버튼 선택 작업에서는 none이 16/16을 통과했으므로, 해당 워크로드에 맞춘 평가의 후보로 삼을 수 있습니다.